
当前位置:首页>自动驾驶>不止追求世界模型:自动驾驶赛车,正在逼出感知系统的真正极限

不止追求世界模型:自动驾驶赛车,正在逼出感知系统的真正极限

  • 2026-10-29 10:51:26
不止追求世界模型:自动驾驶赛车,正在逼出感知系统的真正极限

如果把“自动驾驶最难的问题”拿出来问,大多数人第一反应会是:长尾场景、复杂城市交通、行人和非机动车、施工区、天气变化、规则博弈……

这些当然都难。

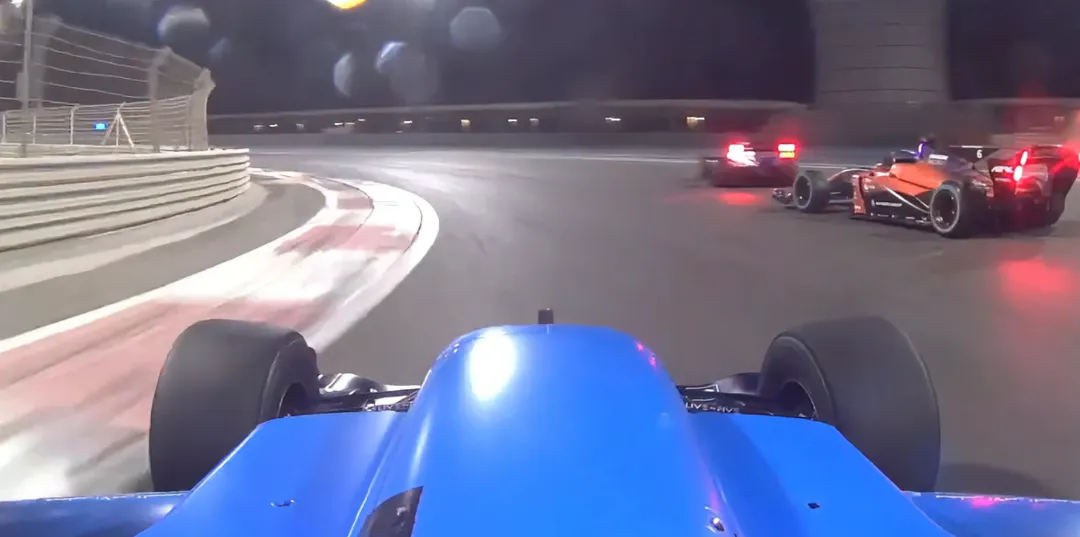
但如果把场景换到自动驾驶赛车,答案会突然变得不一样。在这里,没有乱穿马路的行人,没有社会车辆插队,也没有开放道路上那些无穷无尽的类别和长尾干扰。赛道是封闭的,对手是有限的,规则是明确的。看起来,问题似乎变简单了。

可真正做进去才会发现,赛车场景考验的不是“识别世界的广度”,而是“在极限动态下更新对手状态的速度”。 F1 官方对重刹阶段的解释提到,现代 F1 赛车制动时可产生超过 5g 的减速度;以巴塞罗那某典型重刹点为例,赛车可以在约 2.46 秒、125 米内从 310 km/h 降到 106 km/h。换句话说,按 300 km/h 粗算,100 毫秒已经是 8.3 米。对轮对轮攻防来说,8 米不是“小延迟”,而是一个车位、一条防守线,甚至是一整次超车机会。

所以,自动驾驶赛车真正逼问行业的,不是“模型够不够大”,而是另一个更硬核的问题:

在几十毫秒里,你能不能把最关键的对手状态,更新到闭环可用?

这,才是自动驾驶赛车最有价值的地方。

在极限驾驶里,车手看到的不是‘前方有车’,而是‘我还剩多少时间做判断’。

一
自动驾驶赛车真正难的,不是“看见车”,而是“及时、连续、可信地看见”

很多人会觉得,赛道环境比城市道路简单得多:目标就那几辆车,类别又单一,做个检测识别不就够了吗?

如果只是单帧离线识别,这事确实不算最难。但一旦把它放进高速对抗的闭环里,问题就完全变了性质。

在普通自动驾驶里,感知系统很多时候回答的是:“前面有什么?”而在赛车里,感知系统要持续回答的是:“前面那辆车此刻到底在哪、下一瞬会往哪、我这次进攻还能不能成立、我现在到底该信哪一个传感器?”

所以,赛车场景里的感知,核心已经不是单纯检测识别,而是对手状态估计。

它至少要包含这些内容:

  • 对手车中心位置与朝向

  • 纵向、横向相对速度

  • 车身包络与接触风险区域

  • 短时轨迹趋势与意图

  • 当前估计的置信度、延迟和“新鲜度”

也就是说,规划控制真正想吃的,不是一个 box,而是一个带时间戳、带置信度、能直接参与博弈的对手状态。近期自动驾驶赛车公开工作已经越来越往这个方向收敛:意大利车队PoliMOVE 把低延迟检测跟踪和异步融合放到核心位置,韩国KAIST 强调多模态感知—规划—控制的整栈协同,德国TUM 在 A2RL 中直接把多车交互、赛道规则和极限操稳放到同一个框架下处理。

场景一
末端重刹,晚 100 ms,可能就少了一个车位

真正能把这件事讲明白的,不是抽象概念,而是具体画面。

想象这样一个场景:前车守内线,你带着尾流冲进制动区。在这一瞬间,人类顶尖车手脑子里不会只想“前面有辆车”,而是同时判断:

  • 我跟他的 接近速度 还有多少

  • 他是真的守内线,还是准备假动作后切

  • 我能不能更晚刹而不冲出弯

  • 他是不是已经占住 apex(弯心)

  • 我这一把进去,是完成超车,还是直接把自己送出赛道

这也是为什么重刹区是最能体现“感知新鲜度”价值的地方。 这里真正致命的,不是偶尔漏检,而是结果过时。一条 80~100 ms 前的目标状态,哪怕离线看起来很准,一旦进了高速轮对轮博弈,也可能立刻失去价值。

把这个逻辑放回自动驾驶赛车,就会发现一个非常尖锐的结论:

在极限动态下,很多时候不是“精度高一点”更重要,而是“状态新一点”更重要。

这也是为什么 PoliMOVE 2025 的工作会专门强调基于延迟感知的跟踪与融合:他们不是只追求“更好看的检测结果”,而是在解决“更及时的可用状态”。其 LiDAR 跟踪工作面向超过 275 km/h 的自主超车场景,后续的 LiDAR-RADAR 融合工作进一步把雷达的距离变化率、传感器时延补偿、乱序量测重处理等显式写进系统设计里,本质上都在回答同一个问题:高速闭环里,怎么拿到最新且可信的目标状态。

时速 300 km/h 下,100 毫秒约等于 8.3 米;在轮对轮攻防里,这不是小误差,而是整次决策窗口的一大块。

场景二
连续换位,不是识别一次就够,而是三拍都不能丢

如果说重刹区说明了“为什么快很重要”,那 F1 那些经典的连续攻防,则说明了为什么连续稳定比单次识别更重要。

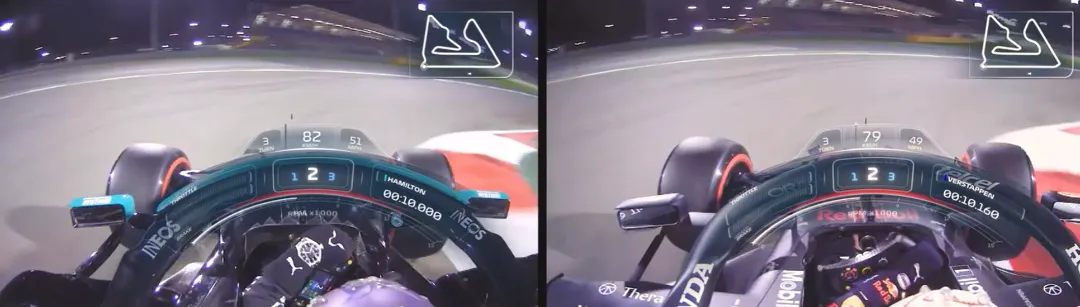
2022 年巴林站,Leclerc 与 Verstappen 的那段经典缠斗,被 F1 官方评价为新规则下轮对轮对抗的代表性场景。Palmer 的分析提到,两人在短短几圈里一共交换了 6 次位置,而这种连续压迫与反压迫,正是新规则想要鼓励的比赛画面。

这件事对自动驾驶赛车的启发非常大。因为在这种场景里,感知系统不是识别一次就结束了,而是必须在一个短时连续博弈链里,稳定跟住目标状态:

第一拍,你判断对手守内线;第二拍,他可能故意刹早,逼你冲过头;第三拍,他利用出弯牵引重新反超;第四拍,双方可能再次进入 DRS 或尾流攻击范围。

所以赛车感知真正的难点,从来都不是“这一帧看没看见”,而是:

能不能在连续三拍、四拍、五拍的状态变化里始终不丢。

这也是为什么单纯把普通自动驾驶里的检测器直接搬到赛车上,往往不够。你要做的不是“识别一辆车”,而是“跟住一个正在博弈的对手”。

轮对轮博弈的关键,不是一帧识别成功,而是在连续攻防中始终跟住对手状态变化。

场景三
并排入弯时,最关键的不是车中心点,而是几何重叠关系

普通自动驾驶里,知道“这有辆车”,很多时候就够了。但在赛车里,这远远不够。

F1 官方 2025 年对驾驶行为规范准则的解释非常适合拿来说明这个问题:在内线超车场景里,超车方如果在入弯前并在 apex 时,其前轴已经至少到达对方后视镜附近的位置,就应当被给予足够空间。换句话说,赛车攻防的合法性和安全性,很多时候取决于一种非常细的几何关系,而不是简单的“有没有车”。

这直接导出一个对自动驾驶赛车特别重要的结论:

赛车感知需要的不是粗粒度 box,而是精细化的车身几何关系。

例如:

  • 对方前轮是否已经和我后轮平齐

  • 车头是否已经探入我的侧后方

  • 哪一侧接触风险更高

  • 我还能不能继续收线

  • 当前最危险的是车头前角、后轮,还是侧箱附近

这也是为什么,面向轮对轮对抗的视觉感知,很值得从“车体级检测”继续往前走到:

  • 轮点估计

  • 车身包络估计

  • 接触风险区域预测

  • 车身重叠/右侧入弯几何关系判定

这个方向现在公开文献还不算特别拥挤,反而是很容易做出赛车特色的地方。

场景四
多传感器不是越多越好,而是谁此刻更可信

A2RL 这类平台之所以有研究价值,一个重要原因就在于它把“多传感器融合”这个词,从论文口号变成了真实压力测试。

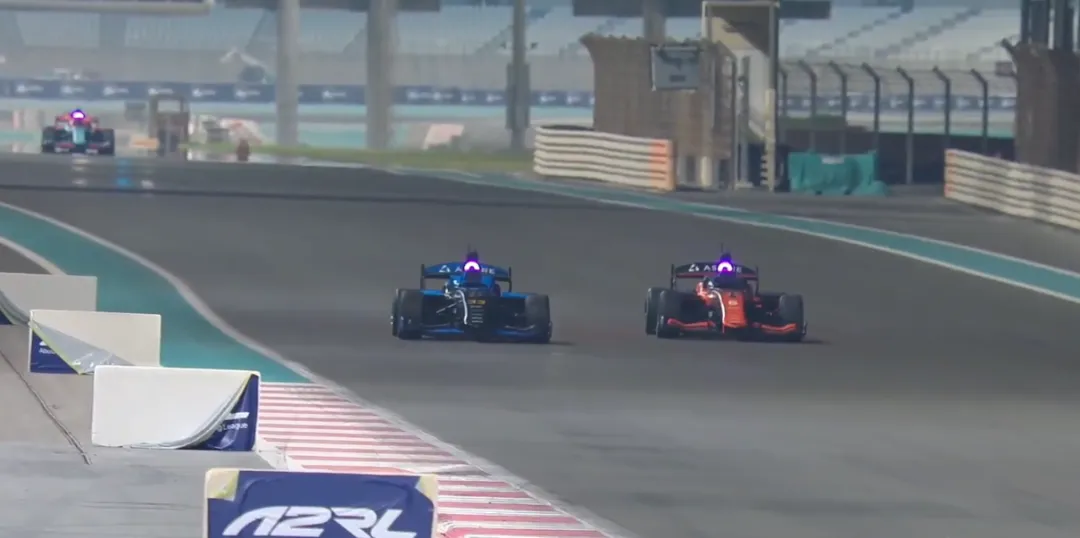
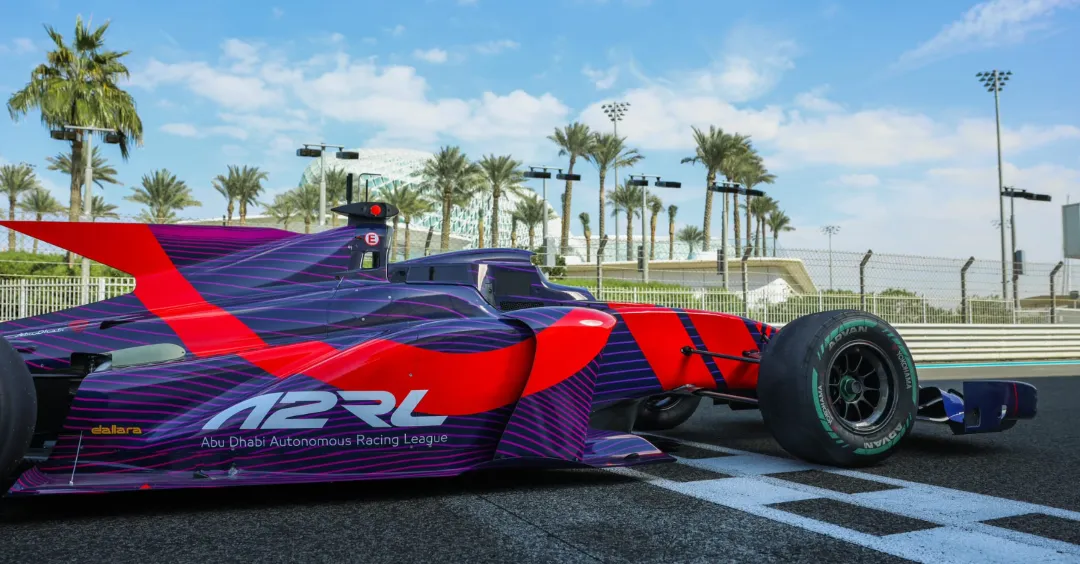
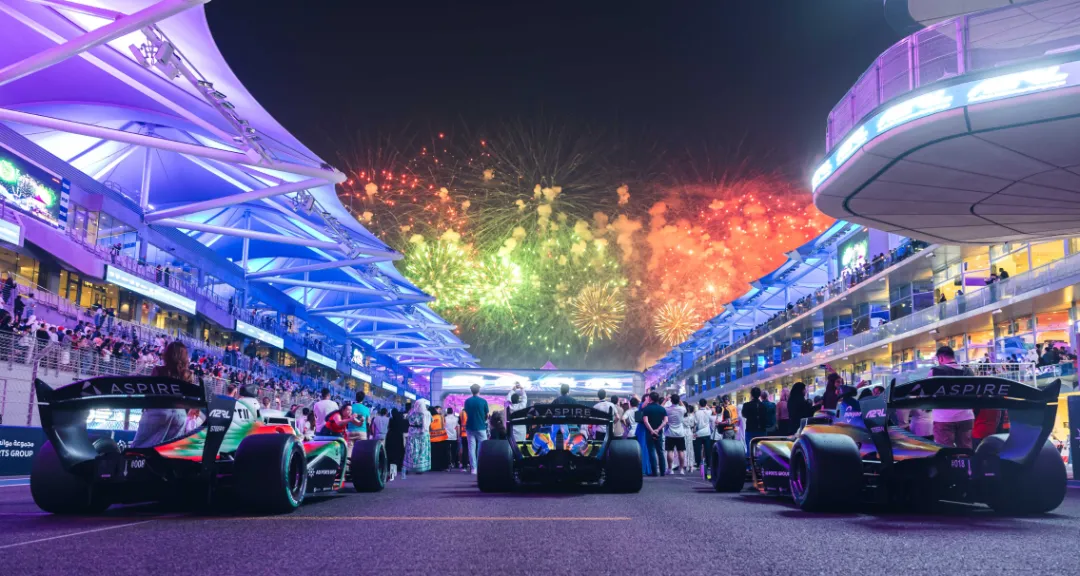
公开资料显示,A2RL 赛车使用了七个摄像头、四个雷达、三个激光雷达,以及 GPS/IMU 和车端计算平台;2025 赛季官方也强调其传感器与计算栈进行了升级,以更好地评估车辆周围条件。与此同时,A2RL 已在 2025 年实现了六车自主总决赛、实时 AI 决策和更激进的超车展示。

但真正难的地方不在于“传感器够不够多”,而在于:

当它们的结论不一致时,你信谁?

比如:

  • 视觉能给出细粒度外形与几何关系,但在逆光、热浪、远距小目标下会掉质

  • LiDAR 几何精确,但在起伏赛道、遮挡、点云稀疏情况下会退化

  • 毫米波雷达分辨率没那么高,但对相对速度非常敏感

  • GNSS/INS 能提供自车稳定定位,却不能直接替代近距对手感知

所以,下一代赛车感知最值得做的一条线,不是把所有模态机械拼接,而是做成可用性感知驱动的选择性融合: 谁在这一刻更可靠,谁就拥有更高的话语权。

PoliMOVE 2025 的 LiDAR-RADAR 融合工作已经体现出这种思路:它没有把多模态简单堆叠,而是显式利用不同传感器的互补特征,把距离变化率、时延和量测乱序问题放到统一跟踪框架里。

A2RL 的价值,不只是让车自己跑,而是把多传感器实时裁决与闭环决策推到高速极限。

二
顶尖团队已经把问题说得很清楚:这不是单模块比赛,而是整栈闭环竞赛

近几年的公开论文很值得一起看,因为它们共同勾勒出了 autonomous racing 的技术主线。

01
PoliMOVE:低延迟跟踪是超车能力的前提

PoliMOVE 2025 的 LiDAR 检测跟踪论文明确指出,高速多车 autonomous racing 中,准确、持续、低延迟的车辆检测与跟踪,是自主超车的必要条件;他们的系统由快速点云分割、姿态估计和 variable-step 多目标跟踪组成,并支撑了超过 275 km/h 的自主超车。

02
PoliMOVE:异步融合不是“锦上添花”,而是高速闭环的基本功

在后续的 LiDAR-RADAR 融合论文里,他们进一步把 latency-aware EKF、雷达径向速度、赛道先验和 OOSM 重处理引入系统,核心不是“多模态更先进”,而是“状态必须更新得够新鲜”。

03
KAIST:高速自动驾驶赛车,本质上是感知—规划—控制协同系统

KAIST 的 head-to-head race 系统论文没有把感知孤立出来,而是将其与高速超车规划、韧性控制和系统状态管理一起设计,并在大约 220 km/h 的自主超车场景中完成验证。

04
TUM:A2RL 的价值,在于把赛道、规则和极限操稳真正接到一起

TUM 2026 的 A2RL 论文则进一步说明,自动驾驶赛车不是“把自动驾驶搬上赛道”,而是要把多车交互、赛道几何、软件部署、极限操稳和对手博弈揉进一个系统里。论文明确把 autonomous racing 描述为推进自动驾驶技术和道路安全的重要研究环境。

这些工作放在一起,其实已经说明了一件事:

未来高速自动驾驶最先被逼出来的,不一定是更大的通用模型,而更可能是更快、更精细、更可信的闭环感知系统。

顶尖团队的公开路线越来越一致:不是做孤立 detector,而是做面向闭环的对手状态估计系统。

三
自动驾驶赛车对行业真正的价值:它提前暴露了自动驾驶最不能妥协的那部分问题

自动驾驶赛车当然是比赛。但它更是一种极限测试场。

因为它把自动驾驶里最不能妥协的几个问题,压缩到了一个异常纯粹的场景里:

  • 高速

  • 高机动

  • 低延迟

  • 多车博弈

  • 强闭环

  • 多传感器冲突

  • 高代价失误

在开放道路上,自动驾驶追求的是广覆盖;在赛车赛道上,自动驾驶追求的是极限能力。而很多真正决定系统上限的能力,恰恰是在这种极限环境下最容易被逼出来的。

所以,这个方向真正重要的地方,并不只是“哪支队伍拿了冠军”,而是它正在逼着整个行业重新认识一件事:

感知的价值,不只在于看得准,更在于看得快、看得稳、看得能直接进入闭环。

换句话说,开放道路最难的是长尾; 而轮对轮赛车最难的,是状态新鲜度。

四
结语

过去几年,自动驾驶领域最热的词是“大模型”“端到端”“世界模型”。这些方向当然重要。

但自动驾驶赛车正在提醒我们另一件同样重要的事:

在极限动态下,真正决定系统上限的,很多时候不是它会不会“理解世界”,而是它能不能在几十毫秒里,把最关键的对象状态看准、看稳、看得足够可控。

从这个角度看,自动驾驶赛车不是自动驾驶的边缘题目,反而可能是最核心问题的一块高压试验田。

谁能先在这里把感知做快、做细、做稳,谁就更有可能提前摸到下一代高动态智能系统的门槛。

五
参考文献
  1. Rob Smedley explains how the new AWS Braking Performance graphic works, and what it will tell us. Formula1.com.

  2. 1950 vs 2020: Cars, drivers, safety and pit stops — how F1 has changed in 70 years. Formula1.com.

  3. PALMER: Why Leclerc and Verstappen’s Bahrain battle heralded a new era of wheel-to-wheel racing. Formula1.com.

  4. EXPLAINED: F1's ‘Driving Standards Guidelines’. Formula1.com.

  5. LiDAR-Based Vehicle Detection and Tracking for Autonomous Racing. arXiv:2501.14502.

  6. Target Tracking via LiDAR-RADAR Sensor Fusion for Autonomous Racing. arXiv:2505.20043.

  7. An Autonomous System for Head-to-Head Race: Design, Implementation and Analysis; Team KAIST at the Indy Autonomous Challenge. arXiv:2303.09463.

  8. Head-to-Head autonomous racing at the limits of handling in the A2RL challenge. arXiv:2602.08571.

  9. A2RL official / TII official materials on sensor stack, season updates, and six-car grand final.

欢迎在评论区聊聊
点点赞
点分享
点喜欢

最新文章

随机文章