预约詹锟GTC2026讲理想下一代自动驾驶基础模型直播
- 2026-11-06 01:53:49
预约詹锟GTC2026讲理想下一代自动驾驶基础模型直播北京时间2026年3月17日14点-14点50分理想基座模型负责人詹锟将在英伟达GTC 2026上介绍理想汽⻋下⼀代⾃动驾驶基础模型MindVLA-o1。 基于统⼀VLA的Omni 架构,在单⼀Transformer中联合建模感知、推理与控制。模型通过离散Action Tokens与MoE实现⾼效、稳定的精准控制;采⽤快慢双系统推理,在实时性与复杂场景推理间⾃适应切换;并结合基于模型的强化学习闭环与软硬件协同设计,实现可量产、拟⼈化的端到端⾃动驾驶。 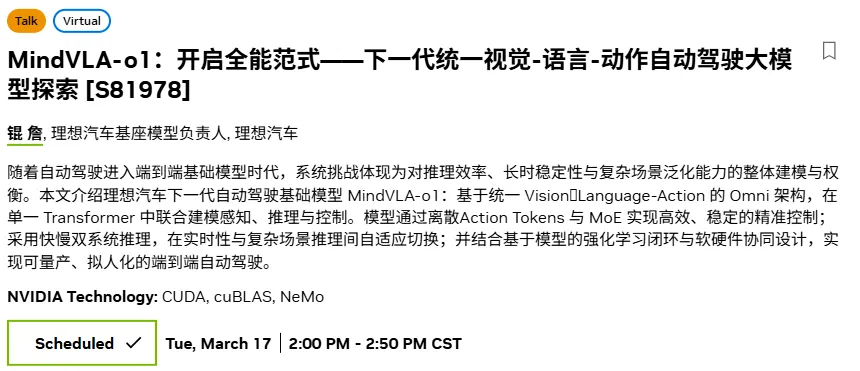
以上为GTC上的介绍。 以下为TOP2的推理,如果有错误理解的地方,欢迎读者随时指出。 TOP2推理詹锟演讲内容不少部分和理想2026年2月10日发布的Hardware Co-Design Scaling Laws via Roofline Modelling for On-Device LLMs[1](下称Hardware Co-Design)与2026年3月2日发布的Unifying Language-Action Understanding and Generation for Autonomous Driving[2](下称LinkVLA)相关。 [1]https://arxiv.org/abs/2602.10377 [2]https://arxiv.org/abs/2603.01441 扫码预约詹锟直播 
加微信,进群深度交流理想实际经营情况与长期基本面。不是技术群,不是官方群,不是车友群。 
Hardware Co-Design讲的是如何在一颗给定的自动驾驶芯片上,找到一个AI大模型的最优架构设计方案。
优化的终极目标是在确保响应速度足够快、内存占用足够小的两个硬性前提下,尽可能地提升模型的智能水平。
模型越深,通常能力越强。宽度和稀疏度并非独立起作用,它们之间存在复杂的耦合关系,需要协同调整才能达到最优。
KV缓存维度对模型最终精度的影响相对较小,对内存占用的影响却很大——这是一个典型的对性能帮助不大但对资源消耗影响很大的参数,在设计时需要谨慎权衡。
在当前的边缘计算芯片上,大语言模型的推理过程大多处于访存瓶颈状态,即内存带宽是主要限制因素。
反直觉但至关重要的结论,在内存受限的边缘设备上,模型设计得越宽,其最佳的稀疏度反而应该越高(即每次激活的专家比例越低)。
即与其把有限的内存预算全部用来增加宽度,不如同时增加总专家数但减少每次激活的数量,用更多但更稀疏的专家来换取更高的模型容量。
更加量化的解释详见理想用四组数学公式分享对自动驾驶芯片软硬协同设计的理解,读者不用被里面的数学公式吓到,TOP2做了详细解释,多看几遍能看懂的。
LinkVLA讲的是将action token定义为离散化的BEV空间坐标,使动作不是LLM的输出结果,而是LLM的原生语言,让LLM具备了直接操纵物理空间的能力。
MindVLA-o1提出的在单一 Transformer 中联合建模感知、推理与控制的Omni 架构。在LinkVLA中,理想通过将语言和动作token统一到一个共享的离散码本(Shared Discrete Codebook)中,并在单一多模态模型中处理。
更细化解读详见没有标题党, 理想系统性重构语言-动作模型理想对VLA的处理思路有可能发生了本质变化
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:596563534@qq.com 。
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- 小轿车托运 1000 公里多少钱 万信 & 同泰物流 1800-3500 元 全国通用 阶梯定价
- 南充:一辆黑色轿车失控撞毁道路中央隔离护栏致交通受阻
- 轿车托运平台推荐 万信 & 同泰物流 四大核心优势 车主首选
- 轿车托运工作调动费用|跨省通勤托运一口价指南
- 轿车托运费用明细 万信 & 同泰物流 逐项列明 清晰透明
- 轿车托运安全吗 万信 & 同泰物流 多重保障 安心托付
- 轿车托运保险多少钱|一文看懂轿车托运保险价格
- SUV豪华运动双面圣手 捷豹F-PACE独家试驾报告
- 常说SUV好 现在就告诉你SUV六大好处
- 3月5日,广汽丰田全新旗舰纯电轿车铂智7正式开启预售,最终预售权益价15.68-20.98 万元.搭载鸿蒙座舱、激光雷达智驾、双腔空悬!