导读
直击自动驾驶视觉语言动作(VLA)轨迹规划的核心瓶颈——显式思维链(CoT)推理延迟高、隐式CoT精度不足、推理缺乏视觉因果 grounding:传统显式CoT因自回归生成导致推理时延随链长激增,无法满足自动驾驶实时部署要求;现有隐式CoT仅压缩语言符号,丢失驾驶场景的时空因果动态,精度始终低于显式CoT。为此,小米具身智能团队提出OneVL统一框架,首次将视觉世界模型与语言隐式推理融合,通过双模态辅助解码器监督紧凑隐式令牌,搭配三阶段训练流水线与预填充推理机制,实现单步隐式推理+视觉语言双可解释+纯答案级延迟。实验表明,OneVL在NAVSIM、ROADWork、Impromptu、APR1四大基准均达SOTA,成为首个超越显式CoT的隐式CoT方法,推理速度与纯答案预测一致,为自动驾驶实时、精准、可解释的轨迹规划提供全新方案。
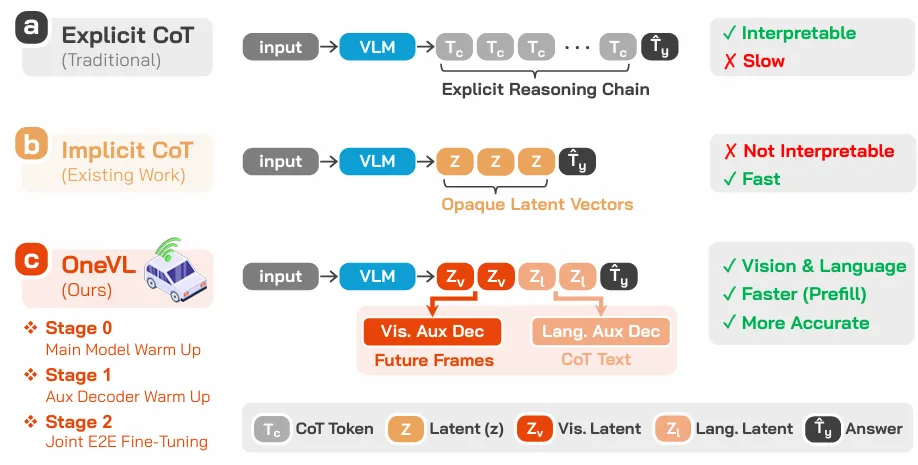
图2 三种思维链范式对比。(a) 显式思维链:模型在给出答案前生成一整串离散的推理标记序列。(b) 隐式思维链:推理过程被压缩为少量不可解析的隐向量Z。(c) OneVL(本文方法):包含两类隐式标记(Zu,红色;语言标记,浅橙色);在训练阶段,双路辅助解码器分别将其解码为未来帧视觉标记与思维链文本,从而提供丰富的文本与世界模型监督信号。推理阶段则舍弃解码器,将隐式标记预填充至提示上下文,在保持仅输出答案的预测速度的同时,于视觉与语言层面均保留(a)的可解释性。
推荐理由
- 核心突破:全球首个隐式CoT超越显式CoT,视觉世界模型监督补上动力学短板,压缩即更强泛化;
- 速度革命:Prefill并行推理,时延追平纯轨迹预测,比显式CoT快1.5–2.3倍;
- 落地极强:MLP轻量化版0.24s时延,4.16Hz满足车规,保留双模态可解释性。
1 业务背景与技术背景
1.0 业务背景:自动驾驶轨迹规划的实时性刚需
自动驾驶端到端轨迹规划依赖精准、实时、可解释的场景推理,是高阶自动驾驶落地的核心环节:
- 安全关键要求:推理结果必须锚定真实场景因果动态,避免幻觉决策;
- 实时部署要求:推理延迟需满足车载毫秒级响应,自回归式显式推理无法适配;
- 可解释要求:需提供语言+视觉双维度推理依据,满足安全审计与人机交互需求。
现有方案面临无法调和的矛盾:显式CoT精度高但延迟高,纯语言隐式CoT速度快但精度低,均无法同时满足自动驾驶的三大核心需求。
1.1 技术背景:现有工作局限与本文突破
当前自动驾驶VLA推理方法存在显著局限,OneVL实现多维度突破:
| | |
|---|
| 显式CoT推理(AdaThinkDrive/LaST-VLA) | 自回归生成推理链,延迟随链长线性增加,无法实时部署 | 隐式令牌预填充并行推理,延迟降至纯答案预测水平,无推理链生成开销 |
| 纯语言隐式CoT(COCONUT/CODI/SIM-CoT) | 仅压缩语言符号,丢失视觉时空因果动态,精度低于显式CoT | 新增视觉世界模型解码器,监督隐式空间学习场景因果动态,精度超越显式CoT |
| 传统世界模型(DriveVLA-W0/DynVLA) | 独立于推理模块,仅用于数据生成/仿真,不直接监督隐式推理 | 世界模型作为训练时辅助解码器,直接优化隐式推理令牌,推理时无额外开销 |
| | 语言+视觉双模态可解释,同时输出CoT文本与未来帧预览 |
2 核心概念:关键定义与技术体系
| | |
|---|
| 核心:单步隐式推理+视觉语言解释的自动驾驶VLA框架;输入:前视图像+自车状态+导航指令+历史轨迹;处理:视觉语言主干→双隐式令牌编码→双辅助解码器监督→三阶段训练→预填充推理;输出:轨迹预测+语言CoT+未来帧预览;核心特性:单步推理、双模态监督、低延迟、双可解释 | 自动驾驶实时轨迹规划、具身智能推理、安全关键场景可解释决策 |
| 核心:训练时监督隐式令牌的两个分支;语言解码器:重构显式CoT文本;视觉解码器(世界模型):预测0.5s/1.0s未来帧视觉令牌;目标:让隐式空间同时编码语言语义与视觉因果动态 | |
| 核心:承载隐式推理的紧凑令牌;视觉隐式令牌:4个,编码时空视觉推理;语言隐式令牌:2个,编码语义推理;特性:固定长度、预填充并行处理 | |
| 核心:推理时将隐式令牌预填入prompt,单并行前向完成推理;特性:无自回归开销,延迟匹配纯答案预测 | |
| 核心:分阶段优化主干模型与辅助解码器,避免梯度冲突;阶段0:主干模型预热;阶段1:辅助解码器预热;阶段2:端到端联合微调 | |
3 核心内容:框架架构与关键技术
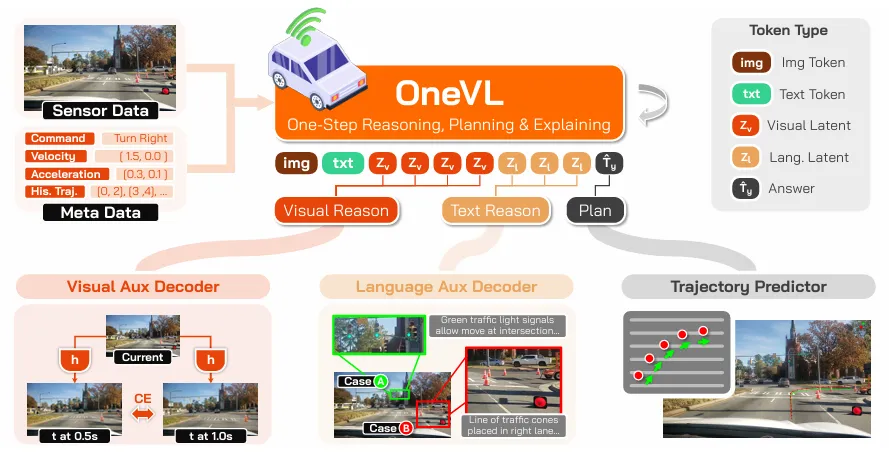
图3 OneVL架构。将图像与结构化文本提示(自我状态、指令、历史轨迹)输入至视觉语言模型中。视觉语言模型交互层下方所示的输出隐状态包含图像标记(Tr)、文本标记(Ti)、视觉隐式标记(Zu)、语言隐式标记(Zi)以及轨迹答案标记(Tt)。训练阶段,隐式位置处的隐状态Ho与He被路由至两个辅助解码器:视觉辅助解码器(左侧)直接预测0.5秒与1.0秒时刻的未来帧视觉标记(Lo),语言辅助解码器(右侧)则预测思维链推理内容(Li)。推理阶段,两个解码器均被弃用;隐式标记被预填充至提示中,以匹配仅输出答案的自回归预测时延。
3.1 整体技术框架
OneVL核心是“视觉语言主干编码→双隐式令牌提取→双辅助解码器监督→三阶段训练→预填充推理”的闭环体系,训练时用双模态信号监督隐式空间,推理时丢弃解码器实现低延迟,整体流程如下:
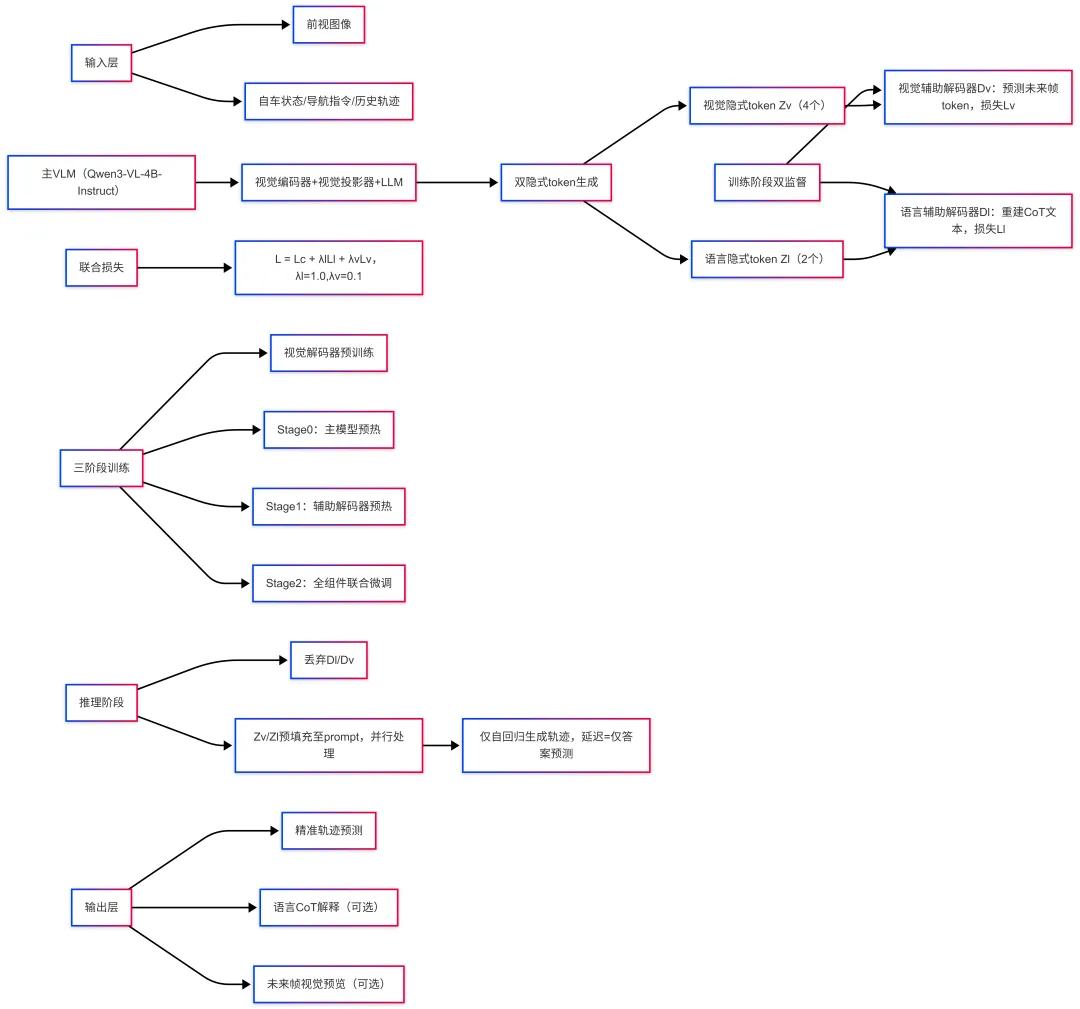
3.2 核心模块技术细节
3.2.1 主干视觉语言模型(VLM)
OneVL以Qwen3-VL-4B-Instruct为主干,包含三大组件:
- 视觉编码器(ViT):提取图像视觉特征,输出视觉令牌;
- 视觉投影器(MLP Aligner):对齐视觉特征与LLM隐式空间;
- 大语言模型(LLM):融合视觉+文本特征,生成隐式令牌与轨迹答案。
主干模型通过标准下一个令牌预测损失优化,同时监督隐式令牌与轨迹答案:
3.2.2 隐式令牌设计
OneVL设计两类固定长度隐式令牌,替代显式CoT的离散推理链:
- **视觉隐式令牌**:4个,位于响应前端,编码场景时空视觉动态;
- **语言隐式令牌**:2个,位于视觉隐式令牌后,编码语义推理逻辑;
- 实现方式:复用原生词汇表,避免新增特殊令牌导致性能下降。
隐式令牌的隐状态、是双辅助解码器的输入核心。
3.2.3 双模态辅助解码器(核心创新)
3.2.3.1 语言辅助解码器
- 功能:从语言隐式令牌重构人类可读的CoT推理文本;
- 输入构造:拼接当前帧视觉嵌入与语言隐式隐状态,经MLP映射:
- 训练损失:交叉熵损失,监督ground-truth CoT生成:
3.2.3.2 视觉辅助解码器(世界模型)
- 功能:从视觉隐式令牌预测0.5s/1.0s未来帧视觉令牌,学习场景因果动态;
- 视觉分词器:采用IBQ量化的Emu3.5分词器,码本大小131072;
3.2.4 联合训练目标
总损失为主干损失+语言损失+视觉损失的加权和:
- :视觉解释损失权重(视觉任务更难,避免主导训练)。
3.2.5 三阶段训练流水线(核心稳定性保障)
三阶段训练解决主干模型、双解码器联合优化的梯度冲突问题,缺一不可:
- 预训练阶段:视觉辅助解码器自监督预训练,仅用当前帧预测未来帧,学习视觉动态先验;
- 目标:让隐式令牌承载有效推理信息,为解码器提供稳定输入;
- 目标:让解码器学会从固定隐式令牌中解码CoT与未来帧;
- 目标:让隐式令牌同时适配轨迹、语言、视觉三大目标。
3.2.6 预填充推理机制(核心低延迟方案)
推理时完全丢弃双辅助解码器,仅保留主干VLM:
- 现代Transformer对预填充序列单并行前向处理,无自回归开销;
- 模型仅自回归生成轨迹令牌,延迟与纯答案预测完全一致。
部署优化:附加轻量MLP头,直接从隐式令牌回归轨迹,延迟降至0.24s(4.16Hz),仅为显式CoT的5.4%。
3.3 关键技术创新点
- 双模态隐式监督:首次将语言CoT监督与视觉世界模型监督结合,让隐式空间同时编码语义与时空因果动态,突破纯语言隐式CoT的性能上限;
- 预填充单步推理:隐式令牌预填充实现并行推理,消除显式CoT的自回归延迟,速度匹配纯答案预测;
- 三阶段稳定训练:分阶段优化主干与解码器,避免梯度爆炸与任务冲突,保证隐式推理质量;
- 双模态可解释性:训练完成后可通过解码器恢复语言CoT与未来帧预览,实现视觉+语言双维度可解释;
- 车载实时适配:可附加MLP回归头,在小幅精度损失下实现车载级低延迟部署。
4 实验验证
4.1 实验设置
- 数据集:NAVSIM(通用驾驶)、ROADWork(施工区)、Impromptu(极端场景)、APR1(因果推理)四大自动驾驶基准;
- 主干模型:Qwen3-VL-4B-Instruct;
- 对比基线:显式CoT(AR CoT+Answer)、纯语言隐式CoT(COCONUT/CODI/SIM-CoT)、传统SOTA(AdaThinkDrive/LaST-VLA/YNet);
- 评估指标:PDM-score(综合性能)、ADE/FDE(轨迹误差)、推理延迟、可解释性指标。
4.2 核心性能结果
4.2.1 主基准SOTA表现
- NAVSIM基准:OneVL PDM-score达88.84,超越8B参数SOTA,延迟4.46s,与纯答案预测一致;
- ROADWork基准:ADE=12.49px、FDE=28.80px,大幅超越YNet,延迟4.71s;
- Impromptu基准:ADE=1.34m、FDE=3.70m,轨迹L2误差平均1.01m,全面最优;
- APR1基准:ADE=2.62m,接近10B参数SOTA,延迟3.23s。
核心结论:OneVL是首个超越显式CoT的隐式CoT方法,四大基准全面SOTA,延迟匹配纯答案预测。
4.2.2 消融实验关键结论
4.2.3 延迟与可解释性
- 延迟:预填充推理延迟与纯答案预测一致,比显式CoT快1.5~2.3倍;MLP版本延迟0.24s,满足车载实时需求;
- 可解释性:语言CoT元动作准确率71.00%,语义相似度78.26%,同时输出未来帧视觉预览,可解释性完整。
4.3 实验核心发现
- 纯语言隐式CoT无法适配自动驾驶,视觉世界模型监督是性能核心;
- 三阶段训练是隐式推理稳定优化的关键,直接联合训练会导致模型崩溃;
- 紧凑隐式压缩比冗长显式推理更易学习通用特征,泛化性更强。
5❓ 核心QA(论文精华)
Q1:为什么以前的隐式CoT都不行?
A1:它们只压缩语言,而驾驶依赖时空因果动力学;语言是抽象符号,无法编码道路几何、车辆运动、障碍物交互,隐空间坍塌失效。
Q2:OneVL凭什么能超越显式CoT?
A2:双监督让隐空间同时编码语义+动力学,紧凑压缩过滤噪声;加上世界模型监督,学到真正因果规律,比逐token生成的冗余CoT更精准。
Q3:Prefill推理为什么能做到和纯预测一样快?
A3:隐令牌全部并行Prefill,无串行推理步骤;现代Transformer一次前向处理所有Prefill令牌,时延几乎与纯轨迹预测一致。
Q4:视觉辅助解码器的作用是什么?
A4:充当世界模型,强迫模型预测未来场景,让隐表示学习物理规律,而非只记文本模式,是精度暴涨的核心。
6 挑战与未来方向
5.1 核心挑战
- 训练内存开销大:训练需同时加载主干与双解码器,内存占用为单模型的3倍;
- 隐式令牌数量人工设定:视觉/语言隐式令牌数量凭经验选择,缺乏自动化搜索机制;
- 轨迹仍自回归生成:预填充仅优化推理,轨迹生成仍为自回归,极限实时性仍有优化空间;
- 单相机输入限制:当前仅支持前视相机,未融合多相机360°感知。
5.2 未来方向
- 实时性进一步优化:采用非自回归轨迹生成,彻底消除轨迹生成延迟;
- 多相机世界模型:扩展视觉解码器至多相机输入,实现360°场景因果建模;
- 隐式令牌自动化设计:通过神经架构搜索(NAS)自动优化隐式令牌数量、维度与结构,提升推理效率与精度;
- 端侧轻量化部署:结合模型量化、知识蒸馏、稀疏化推理,降低边缘车载设备的计算与内存消耗;
- 闭环人机交互系统:基于双模态可解释输出,构建驾驶员与自动驾驶系统的实时交互接口,提升行车安全性与信任度;
- 多场景泛化拓展:将框架适配至雨天、雾天、夜间等极端工况,强化复杂场景的因果推理能力。
7 总结
核心价值
- 范式革新:首创语言+视觉世界模型双监督的隐式推理范式,彻底解决自动驾驶“推理精度-实时性-可解释性”无法兼顾的核心矛盾;
- 技术突破:首次实现隐式CoT精度超越显式CoT,验证视觉时空因果动态对具身智能推理的核心支撑作用;
- 工程落地:预填充推理匹配纯答案延迟,MLP轻量化版本满足车载实时部署,双模态可解释适配安全合规要求;
- 研究引领:建立自动驾驶隐式推理的标准化方案,为具身智能、机器人规划等领域提供低延迟、高可靠的推理思路。
总结金句
👉 “OneVL以双模态监督压缩隐式推理,用视觉世界模型锚定驾驶场景因果动态,通过预填充推理实现实时部署,首次让自动驾驶隐式思维链超越显式方案,打造‘高精度、低延迟、双可解释’的端到端轨迹规划新范式。”
8 原论文信息
- 论文题目:OneVL: One-Step Latent Reasoning and Planning with Vision-Language Explanation
- 作者团队:小米具身智能团队(Jinghui Lu、Jiayi Guan、Zhijian Huang、Guang Li、Lingdong Kong等)
- 发表状态:arXiv preprint(cs.CV领域),2026年4月20日,arXiv编号:2604.18486v1
- 核心创新:双模态辅助解码器监督、三阶段训练流水线、隐式令牌预填充推理、视觉世界模型赋能隐式CoT
- NAVSIM基准:PDM-score 88.84(SOTA),推理延迟4.46s;
- 四大自动驾驶基准均超越显式CoT与传统隐式CoT方法;
- 车载轻量化版本:推理延迟0.24s,帧率4.16Hz;
- 语言可解释性:元动作准确率71.00%,语义相似度78.26%;
- 技术特性:统一VLA与世界模型、训练时双监督、推理时低延迟、视觉+语言双可解释、车载实时部署适配。
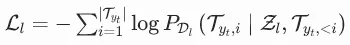
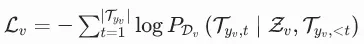
 10个月宝宝每天需要喝多少奶粉?