接上篇文章,本文我想聊一下关于数据质量和数量的问题。
后续还会继续根据作者的经验补充一系列关于AI与智能驾驶的知识与经验分享。
欢迎关注!
往期文章回顾:
为什么自动驾驶真正难的不是模型,而是数据体系
智能驾驶数据闭环团队到底在闭什么环
--------------------------
先抛个结论:
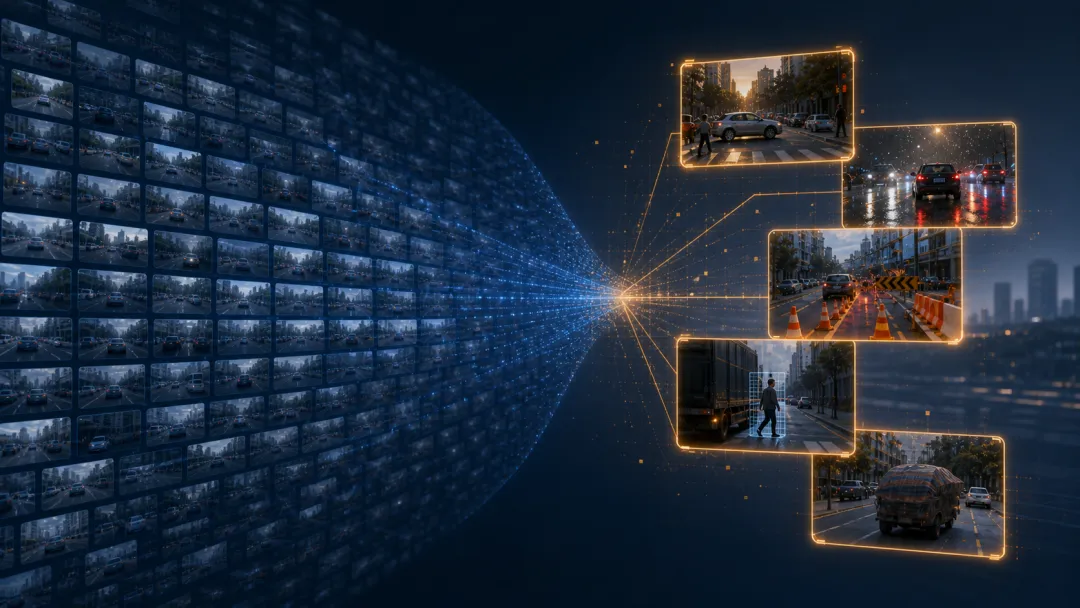
自动驾驶真正缺的,往往不是更多数据,而是更高价值的数据。
更准确一点说,不是缺“海量数据”,而是缺那些真正能推动系统进步的高价值场景。
因为普通数据可以把仓库堆满,却不一定能把模型喂聪明。
真正决定系统上限的,往往不是那 99% 的正常直行,而是那 1% 让系统犹豫、犯错、退化、甚至暴露边界的场景。
这也是为什么很多团队明明已经积累了非常多数据,模型还是会在一些关键问题上原地打转。
不是因为数据不够多。
而是因为真正值得优先处理的数据,还没有被系统性地找出来、定义出来、组织起来。
为什么行业总容易迷信“更多数据”
因为“更多数据”听起来很自然。
在很多 AI 任务里,数据量上来,模型效果确实会提升。
所以大家很容易把这个经验直接套到自动驾驶上:
车越多,里程越多,采集越多,系统就该越强。
这个逻辑不能说错,但它只对了一半。
因为自动驾驶不是一个只靠扩大样本量就能稳定提升的任务
它面对的是开放世界
你今天遇到的是正常车流
明天可能是施工改道
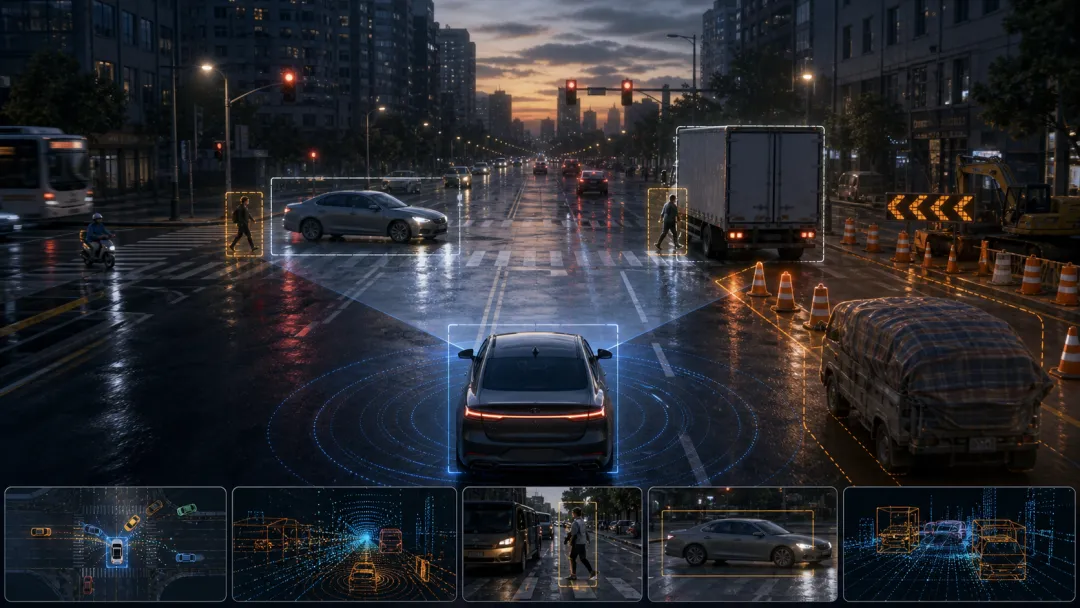
后天可能是异形货车、逆行电动车、贴边行人、夜雨反光和临停遮挡同时出现。
问题就在这里
开放世界里,数据不是均匀有价值的
有些数据会重复强化模型已经很熟悉的模式
有些数据只能增加存储和处理成本
还有些数据看起来很多,但对系统边界几乎没有贡献
所以“更多数据”这件事,本身并不会自动转化成“更强能力”。
自动驾驶里最不缺的,其实是普通数据
如果把真实路采数据摊开看,你会发现绝大多数内容都很像:
正常道路、正常跟车、正常红绿灯、正常车道保持、正常行人通行、正常城市主路巡航
这些数据有没有价值?
当然有
它们构成了系统的基础分布,也决定了模型的日常稳定性。
但问题是,它们的边际价值会越来越低。
当模型已经在大量类似样本上反复训练过之后,再继续喂入高度重复的普通场景,收益通常不会线性增长。
这有点像考试复习。
你已经把最基础的题做了很多遍,再多刷一百道同类型简单题,可能只会让你更熟练,却不一定能解决真正会丢分的难题。
自动驾驶也是一样。
真正拉开系统能力差距的,不是“日常能不能一直正常开”,而是:
遇到少见但关键的问题时,系统能不能做出可靠判断。
真正稀缺的,是那些能暴露系统边界的场景
我自己越来越倾向于把“高价值场景”理解成一句话:
它不是稀有就够了,而是它既能暴露系统边界,又值得被系统性修复。
这两个条件缺一不可
有些场景很少见,但业务价值不大
有些场景很危险,但暂时无法规模化表达
有些场景很典型,但只是一次偶发噪声
有些场景看起来复杂,其实模型早就学会了
真正高价值的场景,往往有几个共同特征:
模型反复犯错
安全风险高
对用户体验影响明显
代表一类可复现的问题
修复后能带来稳定收益
能被进一步拆解成训练和评估对象
比如这些场景,通常就比普通直行更值得优先处理:
无保护左转、施工绕行、临停遮挡后的突然横穿、异形障碍物、雨夜反光、复杂路口的人车博弈。
规则允许但机器不敢走的场景。
人类驾驶觉得自然、机器却反复犹豫的场景。
这些场景之所以重要,不是因为它们听起来“高级”,而是因为它们往往正好卡在系统能力的薄弱点上。
为什么海量数据常常喂不出真正的提升
很多团队已经有了不少车,也采了很多数据,但效果还是不如预期。
这里面常见的误区,不是“数据没回来”,而是“回来的数据不够聚焦”。
最典型的情况有三种。
1. 数据很多,但问题密度太低
一整天回传的数据里,真正值得进入闭环的片段可能只占很小一部分。
如果没有有效的场景挖掘和问题筛选,大量处理资源就会被普通样本吞掉。
最后看起来生产规模很大,实际上高价值样本沉淀得并不多。
2. 数据回来了,但没有变成结构化问题
很多团队会说:
“我们知道这些 case 很重要。”
但“知道重要”不等于“能进入训练”。
如果一个场景只是被看见、被讨论、被截图,却没有进一步拆成稳定的问题定义、标签表达和评估口径,它依然只是一个令人焦虑的案例,而不是能推动系统变好的资产。
3. 数据进了训练,但没有命中能力短板
还有一种情况更隐蔽。
样本也做了,训练也跑了,指标也有波动,但模型真实能力并没有发生你期待的变化。
这往往不是训练不努力,而是样本没有精准命中系统真正的薄弱点。
说到底,模型提升靠的不是“样本数量感人”,而是“学习信号有效”。
什么样的场景,才算真正的高价值场景
如果只讲“高价值”三个字,其实很容易空。
真到工程现场,还是得落到判断标准。
我自己更愿意把高价值场景看成一个四维判断。
第一维:风险
这个场景一旦处理不好,后果有多严重?
是轻微体验问题,还是安全边界问题?
很多低频场景之所以重要,不是因为少见,而是因为它们一旦出错,代价会很高。
第二维:频率
它是一次偶发,还是一类可重复出现的问题?
频率不一定要求很高,但至少要能证明它不是完全不可复现的随机噪声。
第三维:能力相关性
这个场景到底是不是模型或系统真正的薄弱点?
有些问题看上去像数据问题,实际上是规则问题、产品策略问题,甚至是评价口径问题。
如果归因错了,再高频的数据也未必有用。
第四维:可闭环性
这个场景能不能被批量发现、稳定表达、进入训练、并被评估验证?
这是最容易被忽略,但也最关键的一维。
因为一个场景再重要,如果只能靠人工记忆、个别复盘和临时讨论来推动,它的闭环效率就很难真正起来。
真正的高价值场景,不只是“重要”,而是重要且可闭环
数据团队真正要做的,不是收集更多,而是筛出更值钱的少数
很多人会把“数据工作”理解成生产工作。
采集、回传、清洗、标注、入库。
这些当然都是必要动作。
但如果从系统进步的角度看,数据团队真正稀缺的能力,其实不是把流程跑得更快,而是:
有没有办法从海量普通数据里,稳定找出那一小撮真正值得优先投入的场景。
这背后至少有三层能力。
第一层,是场景感知能力。
团队要知道什么问题值得被关注,什么问题只是表面热闹,什么问题是系统短板,什么问题只是偶发噪声。
第二层,是问题抽象能力。
不能只停留在“这个 case 很典型”,而要进一步回答:
它典型在哪?
它属于哪一类问题?
能不能批量挖?
能不能定义成可训练、可评估的对象?
第三层,是资源分配能力。
因为闭环资源永远有限
标注产能有限
训练资源有限
评估窗口有限
团队注意力更有限
所以真正成熟的团队,不会默认“能做的都做”,而是会持续追问:
现在最值得闭的环,到底是哪几个?
为什么“高价值场景优先”会成为长期壁垒
因为它本质上不是一个简单的数据规模问题,而是一个体系能力问题。
谁能更早发现真正重要的问题
谁能更快判断它是不是值得投入
谁能更稳地把它转成训练和评估资产
谁就更有机会把有限资源变成更真实的模型进步
这也是为什么我越来越觉得,自动驾驶公司的差异化,不会只体现在模型结构上。
长期来看,更难复制的能力,往往是:
你是否知道该优先解决什么
你是否有能力把正确的问题持续喂给系统
你是否能避免被大量“看起来很忙”的普通数据拖住
模型会越来越强,工具会越来越多,基础能力也会越来越开放
但什么是高价值场景,为什么它重要,怎么把它闭起来,这些认知和方法,反而会越来越稀缺。
最后几句
很多人以为自动驾驶的数据竞争,拼到最后一定是“谁的数据更多”。
但我越来越觉得,真正拉开差距的,可能不是谁的数据仓库更大,而是谁更知道:
哪些数据只是经过,哪些数据才是资产
海量数据当然重要
但如果没有高价值场景意识,海量数据更像背景噪声
而一个真正成熟的数据体系,最终追求的从来不是“拥有最多数据”,而是“找到最值得让模型学习的数据”。