NVIDIA 把自动驾驶模型开源了,但真正开源的是一整条开发流水线
- 2026-10-29 09:00:24
很多人看到“自动驾驶模型开源”时,第一反应仍然是下载权重。
权重当然重要。它决定了开发者能不能把模型拿到自己的机器、自己的数据和自己的基础设施里继续改造。
但对自动驾驶来说,权重只是入口,不是完整产品。
一个模型要从“会看摄像头”走到“可以参与驾驶系统开发”,中间还要回答一串更麻烦的问题:它能不能生成轨迹?能不能解释为什么这么走?能不能给数据自动打标签?能不能在仿真里接受闭环测试?能不能把云端的大模型蒸馏成车端实时运行的版本?
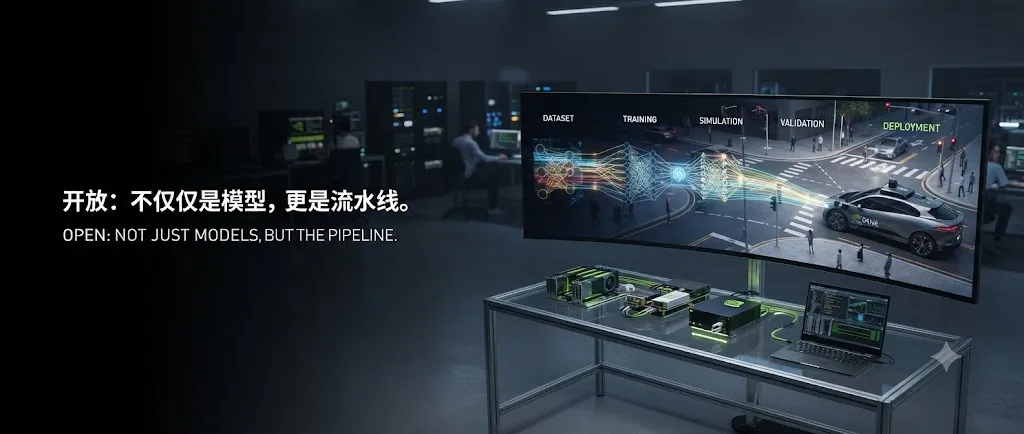
NVIDIA 最近发布 Alpamayo 2 Super,表面上是在开源一个 340 亿参数的自动驾驶 Vision-Language-Action 模型。真正值得注意的,却是它把模型、数据、自动标注、评估、仿真和部署路径放进了同一个开放开发栈。
这不是“又一个模型被放出来”,而是自动驾驶的开发流水线开始被当成开源对象。
NVIDIA 官方博客
本文使用 NVIDIA 的产品公告和工程说明核对 Alpamayo 2 Super 的模型能力、许可、评测和开发工具;这些材料属于厂商自述,性能数字不等同于独立道路安全结论。
NVIDIA Alpamayo2 开源仓库
这是模型推理代码、示例 notebook 和验证流程的公开入口,本文用它核对“开放”是否越过了模型权重,进入可运行的开发环节。
一、自动驾驶最难的不是识别物体,而是把判断变成可验证动作
传统自动驾驶系统通常被拆成多个模块:感知负责识别车辆、行人和道路;预测负责估计其他交通参与者下一步怎么走;规划负责决定自车路线;控制负责把路线变成转向、加速和制动。
拆分有工程上的好处。每个模块边界比较清楚,问题也容易定位。
但它也会制造一个新问题:不同模块使用不同表示,输出之间难以相互检查。负责轨迹的模型不知道负责标注的模型看到了什么,负责评估的工具又未必理解规划模型为什么选择这条路线。
NVIDIA 的工程说明把 Alpamayo 2 Super 设计成一个多任务基础模型。它接收多摄像头视频、语言上下文和车辆运动历史,输出的不只是一条未来轨迹,还包括:
车辆接下来要走的轨迹; 一个 Chain-of-Causation,也就是因果链解释; “让行、变道、停车”等高层 meta-action; 针对场景的视觉问答; 带二维视觉定位的回答; 可以用于训练和验证的自动标签。
这些输出不是简单地把一段文字附在模型后面,而是让同一个模型进入开发流程的不同位置。
轨迹是“车要怎么走”;meta-action 是“它打算做什么”;因果链是“它认为哪些场景因素导致了这个动作”;视觉问答和二维 grounding 则帮助开发者检查模型究竟看到了哪辆车、哪个行人或哪一侧的道路。
这套设计的核心变化,是把“模型输出”从一个结果,变成一组可以彼此对照的工程对象。
如果轨迹说要让行,meta-action 却说要加速,开发者至少有机会发现不一致;如果因果链提到一个摄像头里不存在的行人,错误也更容易被定位;如果模型在某类场景上反复给出相同错误,自动标签可以把这些片段筛出来,进入下一轮训练和验证。
这不是证明模型真的理解了因果关系。
可检查的解释,首先是一种工程接口;它是否是真实内部推理,仍然需要另外验证。
二、真正开放的第一层,是让模型进入自己的数据和许可体系
Alpamayo 2 Super 的模型卡显示,它是一个 340 亿参数的基础模型,由 320 亿参数的视觉语言模型骨干和约 20 亿参数的扩散动作专家组成。
模型权重通过 Hugging Face 发布,采用 OpenMDW-1.1 许可。NVIDIA 的公告称,这一许可覆盖微调、衍生模型和商业再分发,开发者可以把自己的车队数据、驾驶策略和部署条件带进模型,而不需要从零训练所有能力。
这件事对自动驾驶尤其重要。
真实车队数据往往是企业最重要、也最不愿意外流的资产。不同城市、车型、摄像头配置和驾驶政策,会产生不同的数据分布。一个只允许云端调用的黑盒模型,无法轻易吸收这些差异;一个可以拿到本地基础设施中继续微调的开放模型,才有机会成为企业自己的系统部件。
当然,“商业可用许可”不等于“可以直接上路”。
Hugging Face 模型卡也明确要求,开发者需要在具体用例数据上继续测试,并按照 V-model 进行单元和系统级验证。仓库要求 Linux、CUDA、较新的 PyTorch 和 Transformers,并且公开验证主要基于 NVIDIA GPU。模型还需要访问受控的模型和数据资源。
所以这里的“开放”有两个边界。
第一,它开放了改造和再分发的经济路径,企业不必把所有能力锁在 NVIDIA 的服务里。
第二,它没有消除基础设施门槛、数据门槛和安全认证门槛。一个 340 亿参数模型,即使权重公开,也不是普通开发者下载后就能放进汽车的轻量插件。
开源降低的是进入和改造的门槛,不是把复杂系统变成了简单软件包。
三、第二层开放,是让同一个模型同时扮演教师、评审员和数据工程师
NVIDIA 工程博客里有一个比“开源权重”更重要的词:workflow。
Alpamayo 2 Super 可以作为云端的 policy teacher,用更大的推理能力生成轨迹和因果链;也可以作为 evaluation critic,检查已经部署的策略;还可以作为 data engine,为长尾驾驶片段生成结构化标签;最后,它还可以成为新任务定制的起点。
这实际上改变了模型在自动驾驶组织里的角色。
过去,训练数据、规划模型、评测工具和部署模型往往由不同团队维护。每次迭代都要在模块之间搬运数据、转换格式、重新定义指标。
现在,NVIDIA 试图让一个基础模型贯穿这些环节:
从多摄像头场景生成轨迹和解释; 用轨迹与真实未来做 open-loop 对比; 用 meta-action 检查高层意图和轨迹是否一致; 用视觉问答与二维定位检查场景理解; 用自动标签扩大训练和验证数据; 用蒸馏把云端能力压缩到更适合车端的模型。
这里最有价值的不是减少了几个模型,而是减少了开发团队之间的翻译损耗。
同一段道路视频,可以同时成为训练材料、评测样本、错误分析对象和下一代模型的蒸馏输入。一个难例不必先被人工翻译成多个团队各自理解的格式,而可以在相对统一的表示中流动。
这会让自动驾驶的迭代更像一个反馈回路:
场景进入系统,模型做出判断,判断被拆解和评估,错误形成新数据,新数据再回到模型。
AI 系统真正的壁垒,往往不只是模型参数,而是这条反馈回路是否足够快、足够稳定、足够可审计。
四、第三层开放,是把“开环分数”推进到“闭环后果”
自动驾驶评测里有一个经常被忽略的区别:open-loop 和 closed-loop。
Open-loop 评估把模型放在一段已经录好的驾驶场景里,看它预测的轨迹和真实记录有多接近。它适合测模型在固定样本上的预测质量。
但它有一个根本限制:模型的第一次动作不会改变后面的世界。
如果模型预测向左变道,录制中的旁车仍然按照原来的轨迹移动。现实里,旁车可能减速、加速或改变车道;录制数据却不会因为模型的选择而重新反应。
NVIDIA 的工程文章因此把 Alpamayo 2 Super 接入 AlpaSim,提供闭环仿真。仿真系统反复渲染观察结果、调用策略、执行动作,再把动作带来的新状态交给下一轮模型。
在 NVIDIA 公布的测试中,模型在 913 个重建场景上得到 1.50 ± 0.13 的 AlpaSim 分数;同一篇文章也报告了 1434 个挑战样本上的 0.911 米 minADE_6,以及 LingoQA 上 79.2 的分数。
这些数字有用,但都必须带上边界:
它们来自 NVIDIA 选择的模型、数据和评测流程; open-loop 指标不能替代闭环安全测试; 闭环仿真依赖环境重建质量和其他交通参与者的反应模型; benchmark 第一名不等于真实道路部署许可。
不过,闭环本身仍然是一个重要方向。
自动驾驶真正危险的错误,往往不是“第一帧看错了一个物体”,而是第一次动作改变了场景之后,错误继续放大。一个看似合理的变道会让旁车避让,一个错误的加速会压缩行人反应时间,一个不合适的停车位置会把下一次决策推入更糟的状态。
只有让模型的行动进入世界,评测才开始接近真实系统。
五、这条流水线的核心,不是替代模块,而是把模块接成回路
Alpamayo 2 Super 当然没有消灭传统自动驾驶架构。
它的轨迹仍然需要被下游系统消费,车端部署仍然受到延迟、功耗和算力限制,仿真仍然不能完整复制城市交通,安全认证也不会因为模型开源就自动完成。
它更像是在传统模块之间增加一层共同的“开发语言”。
过去,团队可能分别讨论感知准确率、规划误差、标签质量和仿真得分。现在,同一模型可以把场景、意图、轨迹、解释和标签放在一组输出里,让这些指标互相校验。
这带来一个更值得关注的竞争转移:
自动驾驶的竞争,不只是谁的端到端模型更强,还在于谁能把数据、模型、仿真和验证组织成更短的学习回路。
这也是 NVIDIA 选择开放整条流水线的商业逻辑。
单独开放一个模型,可能帮助开发者试用一项能力;开放模型、数据集、训练配方、自动标注和仿真工具,则是在争夺开发者的工作方式。一旦团队用这套工具生成数据、训练模型、分析失败并完成蒸馏,迁移到另一套栈的成本就会上升。
开源在这里不是放弃控制,而是把控制点从“谁拥有权重”转移到“谁定义开发循环”。
NVIDIA 仍然保有硬件、CUDA、仿真基础设施和企业支持等优势。开放模型可能扩大生态,却不等于开放了所有基础设施依赖。
六、Chain-of-Causation:可解释输出很有用,但不能被误读成因果理解
Alpamayo 2 Super 的一个醒目输出是 Chain-of-Causation。模型不仅生成轨迹,还生成一段解释,描述它观察到了什么、哪些因素影响决策,以及为什么选择让行、变道或停车。
对工程团队来说,这种输出很有吸引力。
它可以帮助人类快速筛选难例,检查模型是否把真正重要的交通参与者纳入判断,比较教师模型与蒸馏模型的差异,也可以为自动标签提供结构化文本。
但“可检查”需要和“真实”分开。
一段解释可能是模型在生成动作之后,为动作组织出的连贯叙述;它也可能遗漏了真正影响决策的因素。即使解释与轨迹经常一致,也不能仅凭语言上的合理性证明模型内部拥有一套可迁移的因果世界模型。
更稳妥的使用方式,是把 CoC 当作一种可审计接口,而不是最终证据。
它需要与轨迹、视觉 grounding、反事实测试和闭环后果一起检查。例如,把解释中提到的行人位置改掉,模型的轨迹是否随之变化?把“让行”场景改成“无障碍直行”,它是否会改变 meta-action?如果解释说某个车辆导致减速,移除这辆车后,行为是否真的变化?
真正的因果能力,不是解释说得像因果,而是干预条件之后,行为也按照因果关系改变。
七、开源的终点不是下载,而是让更多人能发现它的错误
NVIDIA 把 Alpamayo 2 Super 发布出来,最值得肯定的地方不是它宣称自己在多个 benchmark 上领先,而是它把开发过程中的多个环节暴露出来:模型权重、推理代码、notebook、数据接口、自动标注方式、open-loop 与 closed-loop 评估路径。
这让外部开发者至少有机会检查:
模型使用了什么输入; 输出的轨迹和解释如何生成; 哪些数据被用于验证; 哪些指标来自开环,哪些来自闭环; 车端蒸馏前后损失了什么; 模型在哪些长尾场景中仍然失败。
当然,公开代码不等于公开了全部训练数据,公开模型卡也不等于公开了全部安全证据。真正有意义的开放,仍然要继续向失败案例、数据覆盖、反事实测试和独立复现推进。
但方向已经变了。
过去讨论自动驾驶模型开源,容易把问题简化成:参数有多少,权重能不能下载,许可证是否允许商用。
现在更应该问:
开发者能不能从一段真实场景开始,经过标注、训练、评估、仿真和蒸馏,最终得到一个能够被验证的车端策略?
如果答案是肯定的,开放的就不再只是一个神经网络,而是一条能够产生新数据、暴露新错误、支持新迭代的工程流水线。
自动驾驶不会因为一个模型开源就变得安全。
但如果开放真的让更多人能够重现决策、干预条件、运行闭环、检查失败,并把错误重新送回训练系统,那么它至少改变了安全改进的参与方式。
物理 AI 最稀缺的资源,可能不是又一个更大的模型,而是一条允许模型在现实后果面前不断被验证的开发回路。
延伸阅读

随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- 奥迪Q5L一口价23.98万,豪华中型SUV的门槛真的被拉低了
- 2026纯电轿车续航Top10
- 2026年还在买燃油SUV的人,到底图什么?
- 劳斯莱斯银云—英伦豪华轿车的经典代表
- 15岁少年“偷开”轿车致2死3伤…公安部通报多起涉未成年人交通事故,家长务必警惕
- 20 万级硬派越野 SUV!开 16 年老司机实话实说,坦克 300 家用越野两兼顾吗?
- 红旗H9一口价跌到18万级,曾经的行政轿车如今卷到这个位置
- 纯电SUV价格战迷局:20万内四款车横评,保值率真相
- 10万以内买插混轿车,就这3台馈电油耗全低于4L,综合续航全破1200km
- 合资SUV一年真要花多少?保险折旧是隐形杀手