当前位置:首页>自动驾驶>DriveVLM:自动驾驶*VLM,解锁认知驱动新可能

DriveVLM:自动驾驶*VLM,解锁认知驱动新可能

  • 2026-09-08 14:01:57
DriveVLM:自动驾驶*VLM,解锁认知驱动新可能

摘要

本研究旨在解决自动驾驶系统在面对现实世界中复杂、前所未见场景时的泛化能力不足问题。传统模块化范式依赖人工定义的规则,难以应对由于语义理解缺乏导致的信息丢失和误差累积。本文提出了DriveVLM 系统,它利用基础视觉语言大模型(VLM)强大的概括和推理能力,通过一个层次化的思维链(Chain-of-Thought, CoT)过程来进行场景描述、分析和规划。

此外,为了解决 VLM 推理速度慢且缺乏空间精度的局限性,我们设计了DriveVLM-Dual 混合系统,它将 VLM 处理非结构化长尾场景的高阶推理能力与传统自动驾驶管线的低阶精确规划能力相结合。实验表明,该方法在 nuScenes 数据集和我们新提出的 SUP-AD 长尾场景数据集中达到了最先进(SOTA)水平。

研究背景

自动驾驶行业正从高速/封闭场景向复杂的城市城市场景进化。然而,传统系统往往存在以下痛点:

1.黑盒泛化难题: 端到端深度学习模型往往缺乏可解释性,且难以应对训练数据之外的突发工况(长尾效应)。

2.信息丢失与误差累积: 传统的感知、预测、规划模块之间接口僵化,容易导致上游感知的语义信息(如前方路面湿滑的隐含风险)在传递到下游规划时丢失,导致决策失误。

3.缺乏常识推理: 例如,人类司机看到前方有道路施工标志,会自动联想到可能需要减速、并线,而传统算法往往只能“看到”一个检测框,无法深度理解其对驾驶行为的长期影响。

因此我们需要一种新的系统结构,能够同时具备人类级别的场景理解和推理常识能力,以及自动驾驶等级的操作精度。

解决方案

为了解决传统模块化范式中“语义理解缺失”的痛点,研究团队提出了一套极其精巧的架构。系统不仅引入了视觉语言大模型(VLM)来构建符合人类认知直觉的“思维链(CoT)”,更创新性的提出了DriveVLM-Dual 混合架构,极大的弥补了大模型在空间坐标精度和推理速度上的先天缺陷 。

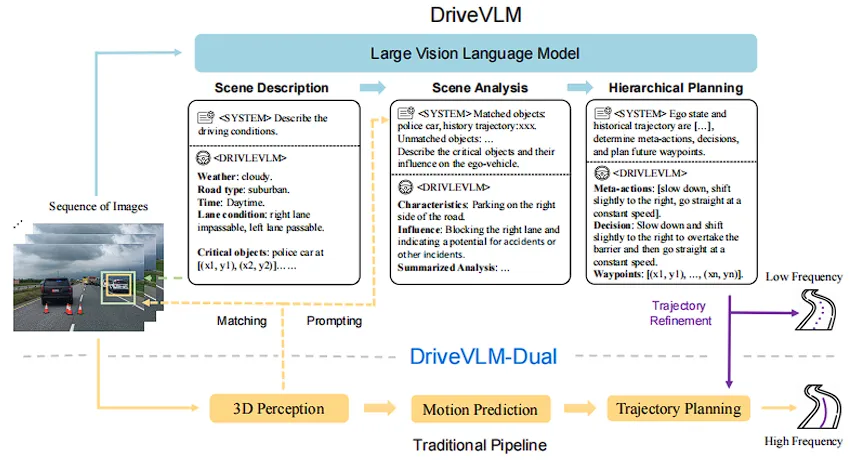
图1 DriveVLM与DriveVLM-Dual模型核心框架图

核心层级一:DriveVLM 的慢思考推理链 (Chain-of-Thought)

如图一的上半部分所示,DriveVLM 通过视觉编码器和 LLM,在内部展开了极其细致的三段式逻辑推理:

第一步:场景描述 (Scene Description)

不同于传统感知模块无差别地输出所有检测框,DriveVLM 模仿人类驾驶员的注意力机制,首先对环境进行结构化描述:

环境描述 (Environment Description):系统会输出包含天气、时间、道路类型以及车道条件的结构化语言描述 。

关键对象识别 (Critical Object Identification): 模型专注于识别最有可能影响当前驾驶的“关键对象” 。每个关键对象都会输出类别及其在图像上的 2D 边界框坐标。得益于预训练视觉编码器的优势,它能够识别出传统 3D 检测器极易漏检的长尾对象(如道路散落物、奇形怪状的动物等)。这些坐标和类别随后会被映射为语言模态中的token_id。

第二步:场景分析 (Scene Analysis)

在看清环境后,模型需要像人类一样去“理解”这些关键对象。DriveVLM 会从三个维度对关键对象进行深度剖析:

静态属性:描述对象固有的属性,例如路边广告牌的视觉提示,或者卡车装载了超宽/超限的货物 。

运动状态:描述对象在一段时间内的动力学特征,包括位置、方向和动作 。

特定行为:这是传统网络极难做到的——识别对象的特殊动作或手势(例如交警的指挥手势),这些会直接影响自车的下一步决策 。结合以上分析,模型会预测出每个关键对象对自车的潜在影响。

第三步:分层规划 (Hierarchical Planning)

最终,模型将场景级摘要、自车位姿和速度等信息作为提示词 (Prompt),逐步生成三个层级的驾驶规划:

元动作 (Meta-actions): 输出短期的驾驶策略。原文定义了 17 个具体类别,包括加速、减速、左转、变道、微调位置等 。

决策描述 (Decision Description): 输出更细粒度的策略文本。包含三个核心要素:动作 (Action)、交互主体 (Subject,如特定的行人或交通灯) 以及持续时间 (Duration) 。

轨迹航点 (Trajectory Waypoints):结合自车位姿、速度和路线信息,输出未来设定时间间隔的二维物理航点坐标集合 W = {w_1, w_2, ..., w_n},这些数值坐标同样被映射为语言token进行自回归生成。

为了让大模型学会上述细粒度的思维链,研究团队针对面向规划的场景理解(SUP)任务,构建了包含场景描述、分析、驾驶规划全维度标注的 SUP-AD (Scene Understanding for Planning) 长尾场景数据集。

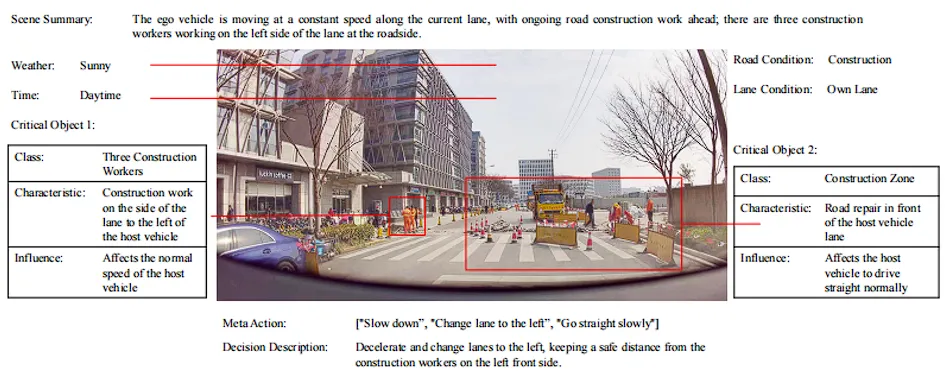
如图2的真实标注样本所示,在面对道路施工场景时,数据集不仅给出了常规的“晴天(Sunny)”和“白天(Daytime)”标注 ,还进行了极其严谨的逻辑推理标注:

识别关键对象与影响:准确标注了“三名施工工人(Three Construction Workers)”和“施工区 (Construction Zone)”,并写明了它们的影响(Influence)是“影响了主车的正常直行 (Affects the host vehicle to drive straight normally)” 。

推导决策: 数据集直接给出了包含三个步骤的元动作序列:["Slow down", "Change lane to the left", "Go straight slowly"] 。并在决策描述中给出了人类级别的原因:“减速并向左变道,与左前侧的施工工人保持安全距离” 。这就从根本上教会了模型“知其然,更知其所以然”。

图2 SUP-AD数据集的注释样本

核心层级二:DriveVLM-Dual 混合系统 (Hybrid System)

大模型虽然在认知上表现出众,但将3D世界映射为语言token导致其空间坐标精度不足,且庞大的参数量导致推理延迟高(低频)。为了在真实车辆上部署,团队在 Figure 1 下半部分设计了DriveVLM-Dual 混合架构 。

该架构通过两条核心策略将VLM 与传统自动驾驶管线缝合:

1. 融入3D感知(Integrating 3D Perception)

为了让 VLM 拥有精确的空间概念,系统引入了传统的3D检测器。

传统检测器输出 3D 边界框,系统将其反向投影到2D图像空间。

接着,将这些投影框与 VLM 识别出的关键对象 2D 框进行 IoU (交并比) 匹配 。

对于匹配成功的关键对象,系统会将其在 3D 空间中的中心坐标、朝向角、历史运动轨迹及 3D 边界框信息,全部转化为文本提示词 (Language Prompts) 喂给 VLM。这使得大模型瞬间戴上了“3D眼镜”,能够极其精准地理解关键对象的空间位置和运动趋势 。

2. 高频轨迹微调(High-frequency Trajectory Refinement)

这部分模拟了人类大脑的慢思考与快思考 。

异步运行: VLM 作为“慢思考”分支,以较低的频率输出包含高阶语义理解的参考轨迹。

高频求解: 传统的规控器 (Planner) 作为 “快思考” 分支以高频运行,它将 VLM 输出的参考轨迹与实时环境特征结合,作为优化求解器的初始解(或神经网络的输入 Query),结合实时的环境特征,最终解码输出高频且符合车辆物理约束的精准轨迹。

通过这一融合,车辆既保留了对抗长尾场景的高级认知能力,又满足了毫秒级的底层控制安全需求 。
实验验证与性能分析

为了验证 DriveVLM 及其混合架构(DriveVLM-Dual)的实际效果,研究团队在极具挑战性的公开数据集(nuScenes)、自建长尾数据集(SUP-AD)以及真实的量产车上进行了全方位的测试。

1. 核心数据霸榜:用真实数据超越现有 SOTA 模型

在定量的性能评估中,DriveVLM-Dual 展现出了极佳的性能:

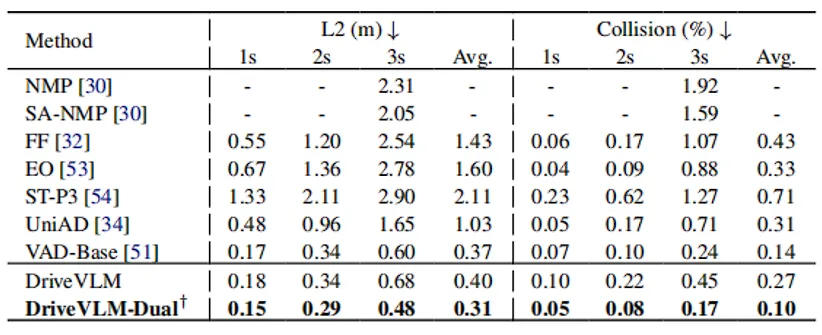
传统底层规控指标的突破(nuScenes 数据集): 根据论文的规划结果,DriveVLM-Dual 在轨迹质量和安全性上全面碾压了现有的端到端大模型 :

表1 nuScenes验证数据集上的规划结果

UniAD 的平均 L2 误差(轨迹偏移量)为 1.03m,平均碰撞率为 0.31% ;VAD-Base 的平均 L2 误差为 0.37m,平均碰撞率为 0.14% 。与 VAD 协同的 DriveVLM-Dual + 将这两项核心指标分别降至 0.31m(L2 误差) 和 0.10%(碰撞率)。

原理解析: 论文指出,这证明了即使 DriveVLM 是为复杂长尾场景设计的,但在配合 VAD 等传统管线后,它在日常普通场景(Ordinary scenarios)中依然能达到 SOTA(当前最佳)的极高水准 。

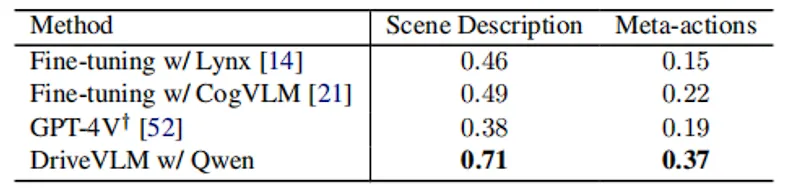
表2 SUP-AD数据集测试集上的结果

认知与决策能力优越(SUP-AD 数据集): 在考察“场景理解与推理”的表二中,团队对比了多种视觉语言模型 :

即使是闭源的 GPT-4V+,在场景描述(Scene Description)和元动作规划(Meta-actions)上也仅获得 0.38 和 0.19 的低分 。论文分析认为,这是因为 GPT-4V 无法进行微调(仅能依靠上下文学习),在驾驶场景中极易产生幻觉(Hallucination),输出多余的干扰信息从而被扣分 。

相比之下,经过微调的 DriveVLM(基于 Qwen-VL) 凭借其强大的视觉问答和灵活交互能力,分别斩获了 0.71 和 0.37 的全场最高分,实现了认知层面的领先。

2. 复杂场景定性分析:看得懂,更躲得开

大模型的威力不仅体现在表格的数字上,更体现在应对复杂路况的“驾驶常识”中。

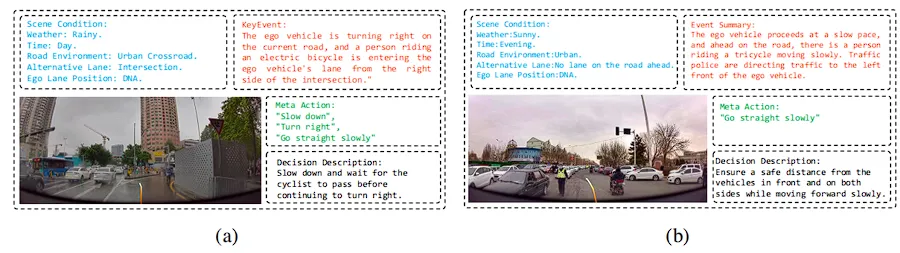
如下图所示,图三直观地展示了 DriveVLM 在遇到棘手场景时的规划轨迹(图中的橙色曲线表示未来3秒的规划轨迹)。

精细的物体交互(图3(a)): 模型不仅识别出了前方有自行车,还在决策描述中明确指出:“减速并等待骑行者通过后再继续右转” 。

理解人类手势意图(图3(b)): 传统模型极难理解人类的手势。而 DriveVLM 成功识别了前方交警示意自车可以继续前进的手势 。同时,模型也注意到了右侧的三轮车,最终给出了“保持安全距离,缓慢直行”的完美决策 。

 图3 DriveVLM的定性结果

很多大模型研究仅停留在算力无穷的仿真服务器中,而 DriveVLM 最具突破性的工作之一,是团队成功将其部署到了真实的量产车型(Production Vehicle)上 。

由于车端算力和显存极其有限,团队进行了一系列极致的工程优化:

双系统异步协同: 系统部署在搭载两颗 OrinX 芯片的平台上。一颗运行高频端到端系统,另一颗运行 DriveVLM,两者异步高效协同。

系统提速:通过引入LDPNetv2将视觉Token数量压缩75%(仅保留 25%),并采用 Eagle 投机采样技术实现了 2.7 倍的解码提速,最终 DriveVLM-Dual 混合系统在 OrinX 平台上达到了平均 410 毫秒的推理延迟,打破了大模型上车的实时性壁垒。

结语

DriveVLM 标志着自动驾驶从“感知驱动”向“认知驱动”跨出的关键一步。通过在 VLM 中设计细粒度的驾驶思维链(CoT)和构建 SUP-AD 数据集,系统能够深度理解复杂场景并进行可解释的常识推理。而DriveVLM-Dual 混合架构则巧妙地平衡了 VLM 的通用推理能力和传统控制管线的高精度要求。

实验表明,DriveVLM-Dual 在 nuScenes 和长尾场景数据集上均达到了最先进(SOTA)水平。这一成果不仅为解决自动驾驶泛化难题提供了新思路,更为未来大模型上车、构建真正智能且安全的交通系统奠定了坚实基础。

文章来源

X. Tian et al., “DriveVLM: The convergence of autonomous driving and large vision-language models,” arXiv preprint arXiv:2402.12289, 2024. [Online]. Available: https://arxiv.org/abs/2402.12289

END

文案:陈超

排版:张洋、刘宇杰

审核:周坤

新能源动力实验室

公众号:新能源动力实验室 VPSL

微信:VPSL_cqu

绿色动力创造美好未来

长按二维码关注

最新文章

随机文章