自动驾驶『路线之争』,VLA和世界大模型,谁才是未来?
- 2026-08-27 16:28:08
上一篇用最通俗的话讲懂,『自动驾驶』目前发展到哪了,我们了解到,以小鹏VLA 2.0为代表的下一代自动驾驶,正在从会开车进化到理解世界。
有朋友私信问我:小鹏不是主打VLA吗,怎么又说是世界模型,两者是什么关系?
确实,行业内关于VLA和世界模型(World Model)的路线之争愈演愈烈,甚至被外界当成非此即彼的对立关系,到底谁才是终局?
做VLA,是不是就不做世界模型?押注世界模型的,是不是在否定VLA?
今天这篇,就把这件事彻底讲透。
先说核心结论:
VLA和世界模型,不是二选一,而是同一套智能系统的左手与右手,二者缺一不可。
1丨行业大会上的“口水战”
如果你关注自动驾驶的技术动态,会发现今年3月英伟达GTC大会上,智驾圈技术路线的讨论热度极高。
小鹏宣布:“我们的VLA端到端大模型已经量产上车。”——小鹏在2026年3月正式推送第二代VLA,取消语言转译环节,实现视觉到动作的端到端直连,是全球率先落地量产的物理世界大模型方案。
华为直言:“真正的未来是世界模型,能预测未来才能自动驾驶。”——华为车BU CEO靳玉志公开评价VLA偏向工程捷径,认为自家的WEWA架构(World Engine + World Action),才更贴近终极自动驾驶模式。
蔚来笑而不语:在2026年1月推送了NWM 2.0世界模型,搭载自研5nm神玑芯片,可在毫秒级完成上百种场景并行推演,要把世界模型做到车端闭环。
理想大声喊道:“听我讲完!我两个都要。”——理想在2026年GTC大会上发布了MindVLA-o1,对外主打VLA架构,同时内置预测式隐世界模型,在隐空间推演未来数秒场景演化。李想直言,这套架构正在向通用物理世界智能体演化。
听起来,像极了两条技术路线在争夺终局门票。
但真相是,这两套话语体系,从一开始就不是在同一个维度上说话。
几家大厂,本质都在解决同一件事:
如何让AI像人一样理解并驾驶车辆,只是切入角度不同。
就像有人从导演视角聊电影调度,有人从摄影棚搭建聊拍摄。听起来是两个话题,但拍的是同一部电影。
2丨通俗拆解:二者到底是什么关系
任何能自主行动的智能体,都必须包含两大核心模块:
Agent(智能体)=司机的大脑,负责看路、思考、打方向、踩刹车,核心是当下该做什么决策。
Environment Model(环境模型)=司机脑子里的路况模拟器,负责预判:前面那辆车3秒后会不会变道?超车时盲区会不会窜出电瓶车?核心是推演周边环境接下来会发生什么。
小鹏的VLA:成熟的Agent智能体
小鹏的VLA,本质就是Agent的成熟量产方案。
它解决的是:怎么看(Vision)、怎么理解指令(Language)、怎么执行(Action)。
2026年3月推送的VLA 2.0,最大的升级就取消传统V‑L‑A架构的语言转译,实现视觉信号直连动作指令,何小鹏直播实测可应对广州早高峰这种地狱级路况。
但小鹏的VLA有没有世界模型的能力?
肯定有的,只是它不叫这个名字——
第二代VLA宣称具备物理世界理解能力,本质上就是在做轻量级的环境推演,只是被整合进了端到端模型里面。
华为的WEWA:极致的环境世界模型
华为的WEWA架构,是Environment Model的工程化极致形态。
华为乾崑ADS 4.1的架构分两层:
云端世界引擎(World Engine):通过海量仿真与实车数据训练世界模型,生成极端场景,实现AI训练AI。
车端世界行为模型(World Action):感知直连控制,跳过语言解析,减少信息损耗。
华为的思路很明确:云端先 “沙盘推演” 无数交通场景,再把能力OTA到车端,让车辆基于物理理解直接行动。
但华为的WEWA有没有Agent的能力?
当然也有。
车端的World Action,本身就是Agent决策执行模块,可以理解为从叙事上弱化了。
理想MindVLA-o1:明确的融合路线
理想的技术迭代速度很快:2024年端到端+VLM双系统→2025年VLA司机大模型→2026年MindVLA-o1。
MindVLA-o1最聪明的地方在于:不站队,直接融合。
引入了预测式隐世界模型,不像华为那样在云端用高清图像推演,而是把感知数据压缩成抽象向量,在隐空间里预判路况,类似人脑的直觉画面——不是高清视频,而是对路况的直觉预判。
再通过Unified Action Generation模块,用VLA‑MoE混合专家模型输出稳定轨迹。
所以你看,理想嘴上说的是VLA,身体却很诚实地把世界模型融入了进去。
蔚来NWM 2.0:车端闭环的世界模型
蔚来在2026年1月推送的NWM 2.0,从生成‑筛选,升级为直接输出最优解。
1.0时代,模型生成多条轨迹再人工筛选,容易出现 “小路战神、大路拉胯”。
2.0引入世界模型 + 闭环强化学习,训练阶段完成沙盘推演,配合自研神玑芯片,毫秒级完成多场景并行推演,车端直接输出唯一最优轨迹。
同时横纵向控制全权由模型一体化输出,Agent能力完全闭环。
所以VLA和世界模型,二者不是对立,而是互补闭环:
VLA智能体(司机大脑)负责决策输出动作→世界模型(路况模拟器)推演这个动作带来的后果→更新环境状态→反馈给VLA做下一轮决策,循环往复。
没有世界模型的VLA:只是模仿动作的高级复读机,不懂预判,极端场景易失效。
没有VLA的世界模型:只会推演无法执行,只是云端的纸上谈兵。
3丨为什么会误以为它们对立?根源是“命名通胀”
明明技术上是一体两面,为何行业炒作成路线之争?
原因可以总结为四个字:命名通胀。
同一套技术能力,不同厂商用不同概念宣传:
做端到端量产的,叫它VLA(小鹏、理想)
做学术研究推演,叫它World Model(华为、蔚来)
做工程强化学习,叫它End-to-End++(Momenta)
做泛化具身智能,叫它 Foundation Driving Model(小米)
技术讨论,逐渐被标签之争替代。
大家不再讨论“你的系统有没有决策模块、有没有环境推演模块”,而是争论“你站VLA还是站世界模型”。
然后今年3月的英伟达GTC大会,把这种标签化推向了高潮:
Momenta曹旭东称VLA提升有限,世界模型+强化学习才是未来;
吉利发布WAM世界行为模型,并指出VLA三大局限;
华为靳玉志认为 VLA 偏向工程取巧,世界模型才是长期方向。
然而被讨论的VLA阵营,其实全都在默默增强世界模型能力。
比如理想的隐世界模型、小鹏的物理世界理解,本质上都是在提高推演的能力。
不得不说,自动驾驶赛道太卷了。
资本市场和消费者都喜欢听故事,必须造出“A路线比B路线更先进”的冲突感,才能拿到融资和高估值。
车企必须让自己看起来是“唯一正确的答案”,才能让消费者在买车时多被看一眼。
再加上人才、芯片算力、数据资源都在抢,拉踩对手技术路线,也是行业竞争的一部分。
所以这场路线之争,技术层面是一体两面,商业层面却是一场精心设计的叙事战争。
4丨真正的技术终局,长什么样?
如果把所有营销噪音和概念泡沫去掉,自动驾驶的终局架构其实非常清晰:
多模态感知(看)→Agent Model / VLA(理解 + 决策)→Action(执行动作:转向、加减速)→Environment Model / 世界模型(推演动作带来的路况变化)→Next State(更新路况)→回到 Agent Model→进入下一轮决策并循环往复
这就是上一篇我们说的第三代自动驾驶的真正底层结构:
不再是 “看见什么做什么” 的单向流水线,而是感知—理解—推演—决策—执行—迭代的闭环智能体。
看看2026年头部玩家的实际动作,你会发现大家其实都在往这个终局走,只是路径不同:
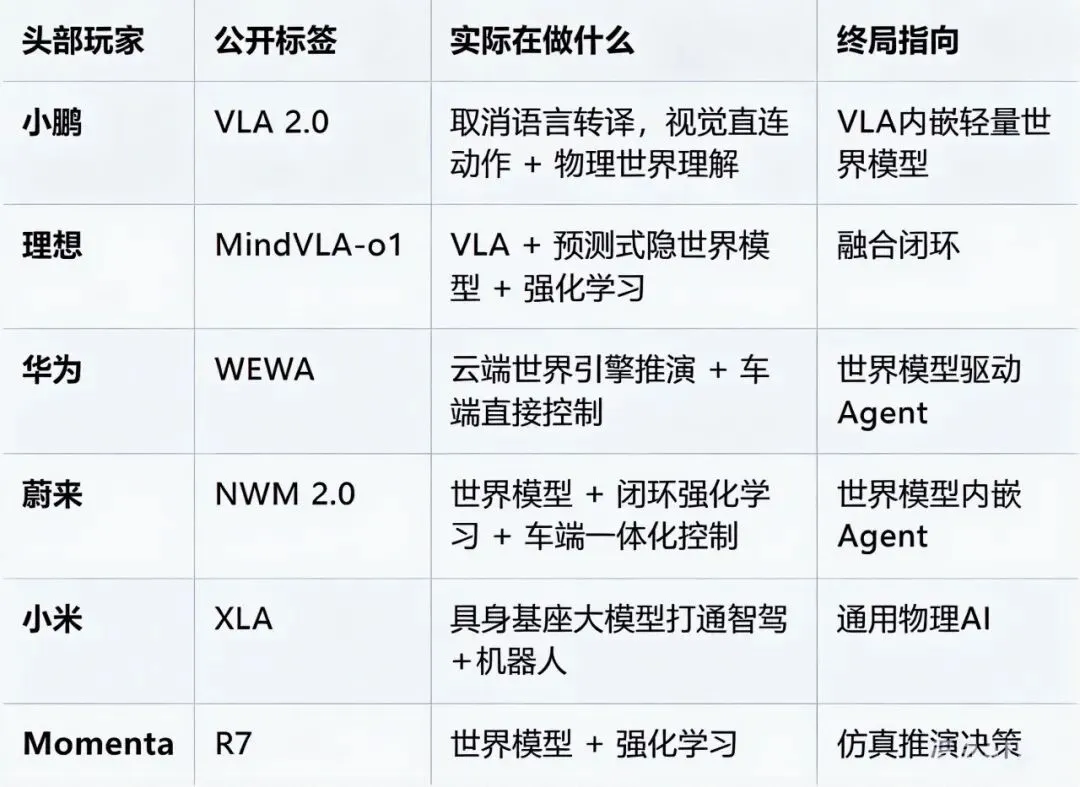
所以终局肯定不存在VLA赢了,或者世界模型赢了,而是两者融合,形成完整闭环智能体。
5丨一个穿透噪音的简单判断方式
以后看到车企吹自己的技术,不用管它叫VLA还是世界模型,也不用管“端到端”、“Foundation Model”这些大词。只需要追问三个问题:
1. 它能不能真正看懂复杂路况?比如能不能听懂“前面那辆白车好像要变道”这种模糊的话?能不能在被大货车挡住时,猜到盲区里可能有电瓶车?
2. 它能不能预测未来几秒会发生什么?比如能不能提前知道前车可能要急刹?能不能在变道前,预判后车会不会加速顶上来?
3. 它是不是先预测再行动,而不是看见什么才反应?真正的聪明车,不是“看到红灯才刹车”,而是“远远看到红灯倒计时,提前松油门滑行”。
三者全满足,不管叫什么名字,技术就是靠谱的。
反过来,如果只会吹一辆车“反应快”,但无法回答“如果前车急刹,3秒后会发生什么”——那它就是闲扯淡,本质上还是上一篇说的“死记硬背的新手司机”或者“高级复读机”,没有真正跨越到第三代。
写在最后
上一篇我们了解到,自动驾驶正在从会开车进化到理解世界。
这一篇想讲透:
理解世界这件事,从来不是靠某一个单点技术突破就能完成的。
它需要一双能看清世界的眼睛(摄像头/雷达等感知),一个能预判未来的脑子(世界模型),和一套能主动决策、执行动作的神经中枢(VLA/Agent)。
技术终局,不是什么名词之争,而是能力的融合与闭环。
本篇属于「能力引擎」合集之技术认知篇。
能力引擎——驱动复杂问题解决,构建长期竞争力。
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- 奥迪A8L霍希:150万级豪华轿车,低调不是借口,后排才是硬账
- 方程豹钛7把价格打进20万内,家用插混SUV买它前先想清楚一件事
- 优惠倒计时!【梦幻草原,全程SUV】海拉尔-莫日格勒河-恩和-黑山头-满洲里,呼伦贝尔5天4晚!
- 林肯冒险家油电混动:想买第一台豪华SUV,别只看车标,也要看它省下来的日常成本
- 暑假活动开始了:第一波福利,轿车充500送200,可以洗23次,每次单价21.7…
- 奥迪Q8不是给所有家庭的豪华SUV,90万预算前先想清楚这件事
- 100 万预算:买顶配豪华家用轿车?还是买优质股权?
- 十万出头!奇瑞这台插混,直接把家用SUV的底裤卷掉了
- 好看更好开的复古SUV 马来西亚车媒试驾iCAR V27
- 20-30万,3款大六座SUV,配置技术都很高,家用很香