当前位置:首页>自动驾驶>自动驾驶的"E2E 时代"——从Tesla FSD到NVIDIA COSMOS

自动驾驶的"E2E 时代"——从Tesla FSD到NVIDIA COSMOS

  • 2026-08-26 16:15:00
自动驾驶的"E2E 时代"——从Tesla FSD到NVIDIA COSMOS
自动驾驶的路线之争正在收官。

不是激光雷达赢了,也不是高精地图赢了——是数据规模赢了。

悉尼大学机器人学教授 Eduardo Nebot 与团队本月发表的综述论文,系统梳理了自动驾驶从规则驱动向端到端(E2E)学习的全面转型。本文截取其中最核心的部分:特斯拉FSD V12到V14的架构演进,以及Robotaxi两种路线的深度对比。

01
范式转变:为什么模块化架构走到头了

传统自动驾驶用的是"感知→预测→规划→控制"的分模块流水线。每个模块独立开发、单独调参,通过明确接口串联。

优点: 好排查、好替换、好解释。

致命缺陷: 长尾问题。

真实道路的corner case数量几乎是无限的——异常天气、鬼探头、逆向电瓶车、工地逆行——工程师们花多年补充的规则,在另一个场景里仍然失效。

端到端学习的思路完全不同:用一个神经网络直接从原始传感器输入映射到驾驶动作,省去所有手工规则,让模型自己发现什么才是好的驾驶行为。

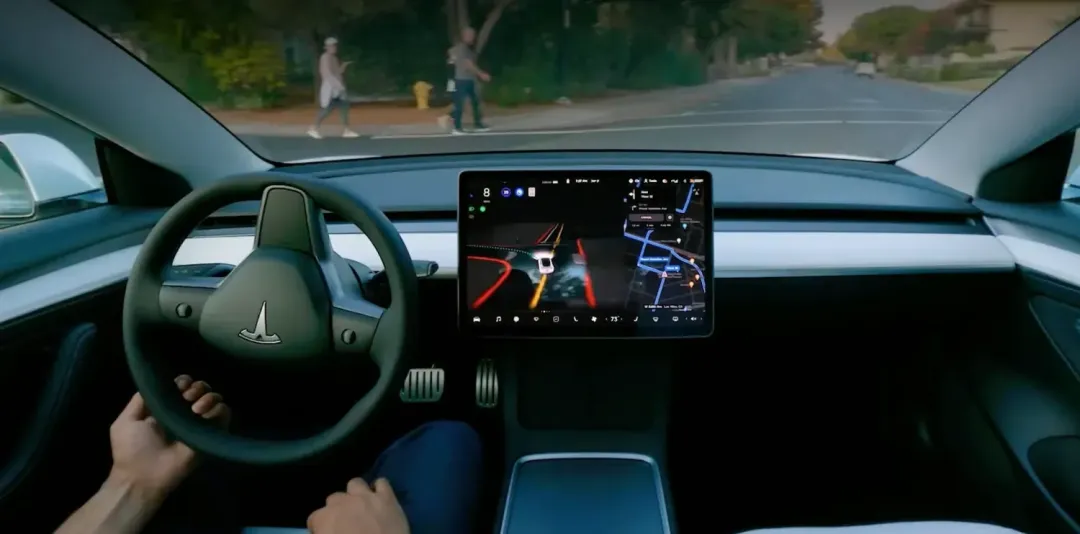
特斯拉FSD V12是行业转折点:整个驾驶栈替换为单一神经网络,删除了数千行C++规则代码。

02
特斯拉FSD V12→V14:三代迭代核心差异

版本

核心变化

关键能力

V12

首个真·端到端系统

整个栈神经网络化,删除所有规则代码;训练信号来自人类司机干预数据

V13

规模与分辨率升级

视频采样率提升至36Hz,更好地追踪快速移动物体;扩大地理/天气/交通分布;初步用于Austin robotaxi试点

V14

架构代际跃升

参数量较V12提升约30倍;引入音频感知(警笛、工地噪音);支持多秒时序推理;干预提示频率大幅下降

V14最值得关注的三个细节:

  1. 混合专家架构(MoE): 据传采用"mixture of models"路由机制,根据当前场景动态调用专业子网络,在城市场景和高速超车场景间高效切换

  2. 音频模态: 麦克风成为第N+1个传感器,能听见的东西对驾驶决策同样关键——警笛、工地噪音都是摄像头看不到的关键信号

  3. 时序推理:维持压缩的驾驶历史潜表示,支持"预判未来几秒交通状态"这类需要多帧上下文的任务

V14已在美国、加拿大、韩国部署,欧洲多国演示中,并已适配右舵。

03
其他玩家的监督学习策略

Rivian:融合优先、数据驱动进化

Rivian为什么坚持多传感器融合?答案藏在它的产品逻辑里。

Rivian的判断是:纯视觉方案在数据规模达到临界点之前,感知可靠性存在系统性盲区——低光环境、恶劣天气、复杂地形,这些场景下摄像头的物理局限无法靠算法弥补。因此Rivian选择**"融合优先、数据驱动进化"**的路线,用硬件冗余换取感知可靠性下限,同时依托车队数据飞轮持续提升模型上限。

技术维度

具体方案

硬件冗余

11颗摄像头(65百万像素)+ 前向激光雷达 + 5颗毫米波雷达(1前向成像 + 4角雷达),360°全向感知覆盖

自研芯片

垂直整合计算层,摆脱供应商依赖,支撑越来越大的模型迭代周期

LDM大驾驶模型

端到端训练,强化学习对齐目标为安全、性能、舒适度,训练成"比好司机更安全",而不只是"像好司机"

数据飞轮闭环

ADR自动记录边缘案例→筛选上传→RL专项强化→OTA推送更新→车队能力提升

Rivian计划2026年推进个人L4能力。与大众的合资则服务于同一目标:从分布式ECU走向集中计算,一个软件平台覆盖所有车型,大幅加快OTA迭代速度。


NVIDIA:世界模型驱动强化学习

NVIDIA走的是物理AI路线,核心判断是:端到端系统的能力上限,最终由训练数据的分布和质量决定;而真实道路永远无法覆盖足够的边缘场景——必须在仿真中合成它们,并用它来训练模型。

产品

定位与功能

Cosmos世界基础模型

学习物理定律,构建"无限仿真"引擎——在计算机内行驶万亿英里。更关键的是,Cosmos同时承担强化学习训练任务:仿真中生成的边缘案例直接回流用于RL训练,让模型在真实部署前就已经学会处理极端情况

Alpamayo(~10B参数)

开源端到端驾驶智能体,传感器输入直接映射到转向/制动,任何人都能用它构建自己的自动驾驶系统

双栈安全架构

E2E策略 + 确定性规则兜底栈并行运行,置信度下降时自动切换到规则兜底——兼具E2E的高性能和规则系统的可追溯安全保障

NVIDIA与奔驰合作,计划2026年在乘用车部署L2++。

04
Robotaxi两种路线:Tesla vs Waymo正面交锋

毋庸置疑,自动驾驶的终极答案是Robotaxi。2025年6月,Waymo和Tesla先后在德克萨斯州奥斯汀上线商业Robotaxi服务。两个技术路线第一次在同一座城市、同一时间维度上正面竞争。

这是理解当前自动驾驶格局最好的切片。


Waymo:传感器融合的防御战

Waymo于2025年3月在Austin上线,是当地首个L4商业运营。

维度

Waymo方案

硬件方案

激光雷达+摄像头+毫米波雷达三重冗余,感知有物理下限保障

ODD管控

从地理围栏起步,数据验证后才逐步扩展,每步扩张均有量化安全指标门槛

运营积累

旧金山、凤凰城已有大规模运营记录,安全、可靠性、乘客满意度均优于传统网约车

核心结论:Waymo代表成熟、稳健、可量产的L4路线。代价是硬件成本高出特斯拉一个数量级,扩张速度受限于成本约束。


Tesla:纯视觉的首秀

Tesla于2025年6月在Austin启动Robotaxi试点,采用纯视觉+端到端FSD方案,初期配备安全员。

维度

Tesla方案

传感器

零激光雷达,仅靠摄像头+毫米波雷达,硬件成本大幅低于Waymo

安全机制

远程监控+干预,后台操作员可实时监控并必要时介入(非Waymo那种完全无人值守模式)

迭代速度

同日发布的FSD V13已在Austin部署,模型能力随OTA快速提升

核心结论: Tesla的目标不是做一个比Waymo更安全的Robotaxi,而是证明纯视觉+数据驱动的路线可以Scale——硬件成本低、复制速度快,这是Waymo路线无法比拟的优势。


两种路线的根本分歧

维度

Waymo

Tesla

传感器

激光雷达+摄像头+雷达

仅摄像头(+毫米波)

安全架构

传感器冗余兜底感知下限

数据规模提升感知上限

扩张逻辑

ODD验证→逐步扩展

软件定义,硬件一致

当前挑战

成本过高,扩张速度慢

证明纯视觉安全性仍需时间

两者共同面对的问题:极端天气、异常交通行为、公众接受度。但Tesla的商业压力更小——FSD Supervised(L2++)已经大规模商用,Robotaxi只是能力溢出;Waymo则必须在L4维度上证明自己。
05
个人观点

1. 数据规模已超越传感器方案成为核心竞争力。

V12证明纯视觉在足够数据规模下可以匹配甚至超越传感器融合方案。2026年FSD Supervised的大规模部署将最终验证这一判断。国内玩家正在逐步抛弃毫米波,从5R减到3R,最后仅剩前向毫米波。而Lidar如果无法实现与视觉的融合,迟早也会被撤下。

2. 安全评估框架是最后的监管瓶颈。

端到端系统的决策过程不可解释,传统的基于场景的测试方法无法覆盖长尾分布。NVIDIA的世界模型仿真+双栈安全架构是目前最接近回答"如何证明它足够安全"的工程方案。

3. "L3"将激活真正的智驾大模型上车。

随着未来1-2年中国L3/L4系统安全法规的落地,将迎来L3的爆发。天然的,L3要追求更高的安全,这就要求在车端使用更大的推理模型。这个智驾大模型将达到100B以上,需要的车端算力将达到2000-4000Tops。

论文原文:The Era of End-to-end Autonomy: Transitioning from Rule-Based Driving to Large Driving Models,arXiv:2603.16050v1,2026年3月,悉尼大学。

最新文章

随机文章