自动驾驶开始生成未来:一篇新论文给智驾换了条路
- 2026-08-19 16:22:06
📅 2026-08-06 · 编辑:信息源点 · 汽车 AI
自动驾驶系统每天都在看路。
摄像头负责识别车辆、行人和车道线,算法判断它们接下来可能怎么动,规划模块再决定车辆应该刹车、加速还是转向。
这套流程已经发展了很多年,但最近一篇论文提出了一个更大胆的方向:与其分别识别眼前的目标,不如让模型先生成未来几秒的道路视频,再从这段“未来画面”里规划车辆轨迹。
8月4日,研究团队在 arXiv 发布了名为 SUV 的端到端驾驶框架。
这里的 SUV 不是汽车品牌,而是 Future Scene Understanding as Video Generation 的缩写。
论文试图用一个预训练视频模型,同时预测未来道路的外观、语义、相对深度和交通参与者动态,再由动作模块据此生成车辆轨迹。
如果这条路走通,自动驾驶的核心问题就会从“我看到了什么”,变成“接下来世界会怎么变化”。
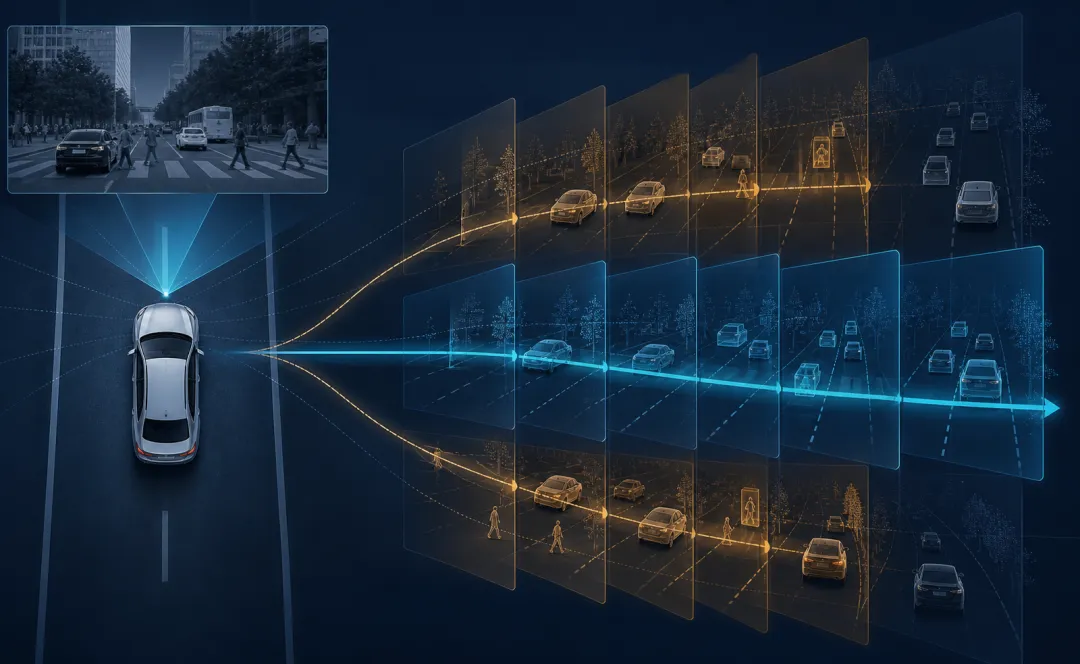
自动驾驶系统根据当前道路生成多个未来场景并选择行驶轨迹
传统智驾为什么要拆成很多模块
而传统自动驾驶系统为了方便训练和验证,往往把任务拆开:感知模块识别物体,预测模块预测轨迹,规划模块生成路线,控制模块负责执行。
这样做的好处是每个模块都比较清楚,出了问题也容易定位。
坏处是模块之间的信息会被切割。
感知模块可能只告诉规划模块“前方有一辆车”,却没有把车辆姿态、遮挡关系和周围交通参与者的变化完整传过去。
尤其在复杂路口,真正影响决策的不是某一个物体,而是所有物体如何一起变化。
论文提出的视频生成方法,试图用一个统一的未来场景表达把这些信息重新合在一起。
生成未来,不等于拍一段电影
这里的“生成视频”不是给用户看的画面,也不是为了让车辆拥有更炫的可视化界面。
模型生成的是一种面向决策的内部预测。
它需要回答:几秒后前方车辆可能在哪里,行人会不会走入道路,路口的可行驶区域会不会变化,当前动作会不会把车辆带进危险位置。
SUV 框架把未来外观、语义、相对深度和实例动态作为多条视频流进行预测,再让动作专家读取这些未来信息,生成车辆自身的行驶轨迹。
换句话说,视频不是最终结果,而是帮助规划模块理解未来的中间语言。
单摄像头的结果很有吸引力
论文摘要里有一个容易被注意到的结果:在只使用单个前视摄像头、没有候选轨迹选择的情况下,SUV 在 NAVSIM-v2 的两个测试划分上超过了多项近期方法,在 navtest 上取得 91.0 的 EPDMS,在 navhard 上取得 36.9。
这并不意味着“一颗摄像头就能解决自动驾驶”。
论文使用的是公开数据集和仿真评测,结果也不等同于真实道路上的量产能力。
摄像头在夜间、逆光、雨雪和严重遮挡环境下仍然有天然限制,视频生成模型也可能产生看起来连贯、实际上错误的未来画面。
生成式预测提供了另一个观察角度:传感器数量重要,但模型如何把有限信息组织成对未来的判断,同样重要。
自动驾驶的难题从识别转向想象
以前我们经常问,一个系统能不能识别行人、红绿灯和车辆。
下一步的问题可能是:它能不能理解道路上每个参与者的行动关系,并且提前想象几种可能的未来?
这种能力听起来很像“想象”,但工程上必须非常克制。
模型不能只生成最像历史数据的一条未来,还要考虑低概率、高风险的情况。
比如一辆停在路边的车突然开门,一个被遮挡的行人突然出现,或者前方车辆在没有明显信号的情况下急刹。
对自动驾驶来说,最危险的不是预测不够漂亮,而是把不确定性藏起来。
一个生成式模型如果对未来过于自信,规划模块就可能做出激进动作。
因此,未来的生成式自动驾驶需要同时输出场景预测和不确定性评估:哪些部分比较确定,哪些部分只是可能,什么时候必须减速、等待或交给人类接管。
从论文到量产还有很长的路
SUV 这样的研究,真正的价值不在于立刻改变一辆车,而在于给行业提供了一种新的系统组织方式。
它把视觉理解、未来预测和动作规划放在一个更紧密的闭环里,可能减少模块之间的信息损耗,也可能让模型通过更丰富的未来监督学到新的驾驶规律。
但量产车需要面对的事情远比公开数据集复杂:训练数据是否覆盖极端场景,生成结果能否解释,系统如何验证每次更新,出现错误后谁来负责,芯片是否能在车端实时运行。
如果这些问题没有解决,生成式自动驾驶很容易变成一个漂亮的研究演示。
真正的门槛,是把它变成可验证、可回退、可长期维护的安全系统。
说句真心话
我觉得这篇论文最有意思的地方,不是它又刷新了某个数据集分数,而是它改变了一个问题的问法。
自动驾驶不应该只盯着眼前的道路,也要理解道路正在变成什么样。
这并不意味着汽车真的需要“想象力”,而是说明未来的智驾模型可能越来越像一个世界预测器:先模拟几种可能,再选择风险更低的动作。
从识别物体到预测场景,再到理解不确定性,这条路线比单纯堆传感器和参数更难,但也更接近真正的驾驶决策。
你愿意接受一套“看不见它如何思考,但能提前预测风险”的自动驾驶系统吗?如果它能解释为什么减速或绕行,你会更信任它吗?评论区聊聊。
往期推荐
百度的文心助手拿下Agent高分:AI开始从“会回答”走向“能交付”
小米澎程增程器引发争议:92/95/98都能加,是技术突破还是营销噱头?
参考链接
1. arXiv:SUV: Future Scene Understanding as Video Generation for End-to-End Driving
2. SUV 官方代码仓库
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- 想买“大车”的再等等,3款全新“9系SUV”即将上市,2款是方盒子
- 邹平5-55座轿车商务车中巴大巴包车租赁|旅游团建商务接送机场高铁全覆盖价格表
- 10万买轿车别急着下单,长安逸达这车我必须跟你唠唠
- 从首款SUV到科迈罗,雪佛兰的传奇不是偶然
- 莱西全市包车租赁:5-55座轿车商务车中巴大巴,旅游团建商务接送机价格一览
- 想买8缸SUV代步?这三款既有排面又能野,老司机实话实说
- 荣成包车:5-55座轿车商务车中巴大巴租赁,旅游团建商务接送威海大水泊机场烟台蓬莱机场荣成站高铁接送
- 首部L3L4级自动驾驶强制国标落地,高阶智驾迈入合规量产新周期
- 2027款丰田世纪SUV:它卖的不是张扬,而是日式豪华的分寸感
- 余姚全市包车租赁:5-55座轿车商务车中巴大巴,旅游团建/商务接送/机场高铁全覆盖价格表