端到端自动驾驶之小鹏VLA2.0深度解读干货:去掉语言层,是技术突破还是概念妥协?
- 2026-09-09 08:06:11
端到端自动驾驶之小鹏VLA2.0深度解读干货:去掉语言层,是技术突破还是概念妥协?同时对比华为鸿蒙乾崑WEWA架构,小鹏VLA2.0在底层设计上更先进、整体性更强,但两者只是技术路线取舍不同,不存在谁全面碾压谁。本文通俗拆解这套技术的真实实力、优缺点和行业格局。 旧版智驾需要经过「视觉看画面→语言翻译理解→输出驾驶动作」三步流程,问题非常明显: 反应慢:全程时延约200ms,突发险情留给系统的反应时间很短 信息失真:复杂路况翻译成文字会丢失细节,容易判断出错 算力浪费:实时生成文字消耗大量算力,硬件成本高、难普及 数据成本高:需要大量人工图文标注,海量实拍视频无法直接复用 小路能力弱:乡村、城中村、无修路场景容易卡顿、不敢通行 驾驶不顺滑:指令生硬,频繁急刹、顿挫,不像人类开车 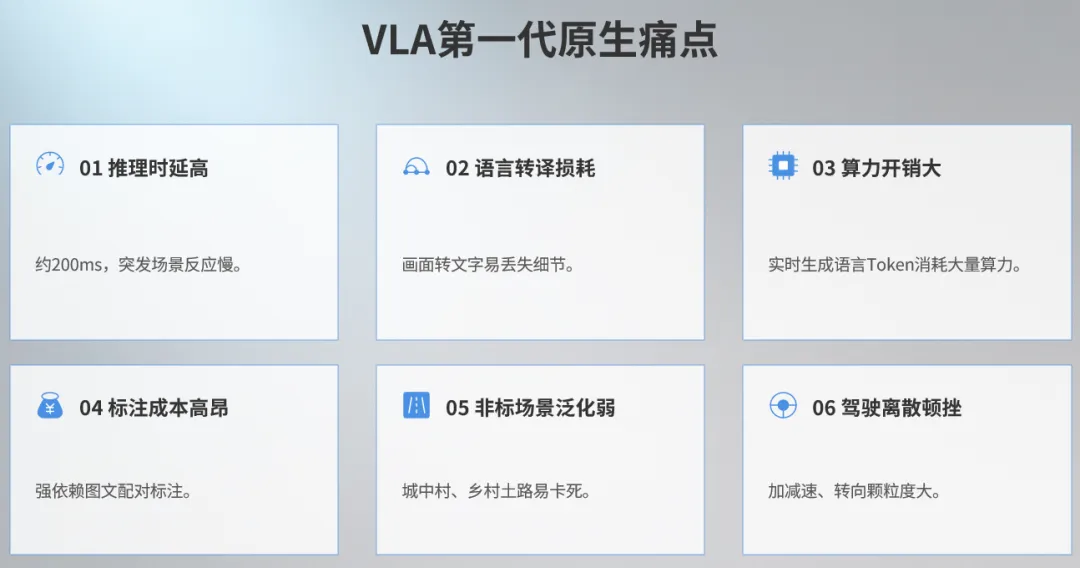
新版核心逻辑:训练时学懂语言和交通规则,开车推理时不再生成文字,视觉画面直接变成车辆操控指令。
注:仅取消行车决策的实时文字生成,车内语音、导航语言功能完全保留。 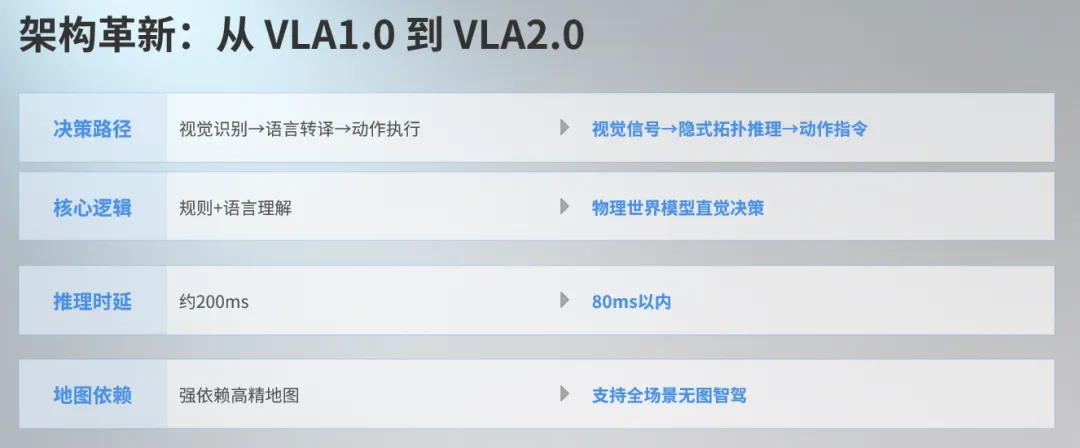
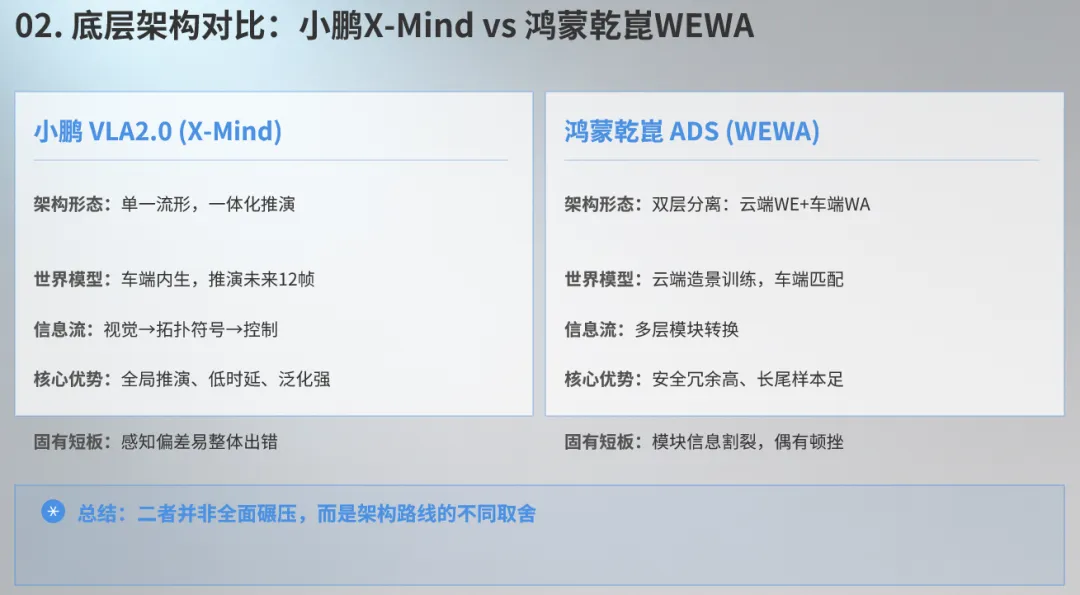
从智驾底层逻辑来看,两家走了完全相反的路线:小鹏是一体化全局思考,华为是云端训练+车端执行的分层模式。 整体统一认知:把看路、预判、规划路线、控速全部整合在同一个模型体系里,没有模块割裂,信息零损耗 主动预判未来:能提前推演未来12帧路况变化,预判车辆、行人动向,主动规避风险 链路极简高效:跳过文字翻译,视觉信号直接控车,响应更快、行驶更顺滑 华为采用「云端世界引擎+车端行为模型」双层架构:云端负责学习海量极端场景、搭建场景库,车端只负责落地执行。 缺点是车端缺少自主深度推演能力,更多靠“匹配学过的场景”开车,模块之间存在信息断层,部分场景容易出现驾驶突兀、顿挫。 华为WEWA优势:更稳、容错更高 多激光雷达多重感知备份,恶劣天气、视线差时不会整体失效,安全冗余更强 云端海量极端场景储备,遇到陌生路况,靠场景匹配稳定性更好 小鹏VLA2.0短板:一体架构容错低 全套智能依赖单一核心模型,一旦视觉感知出错,整体路况判断容易连带偏差,这是极致一体化架构的固有代价。
全场景无图通行:乡村土路、城中村、夜市人车混行、无导航道路都能开,可识别交警手势、规避开门杀、礼让非机动车 安全性大幅提升:障碍物识别数量提升124%,复杂道路无干预里程提升13倍,80km/h时速刹车距离缩短近3米 驾驶更像老司机:跟车、减速、转向顺滑,小区、学校自动降速,不频繁急刹,乘坐体验舒适 通行效率更高:综合行车效率提升23%,智能优选车道,减少无效变道和拥堵卡顿 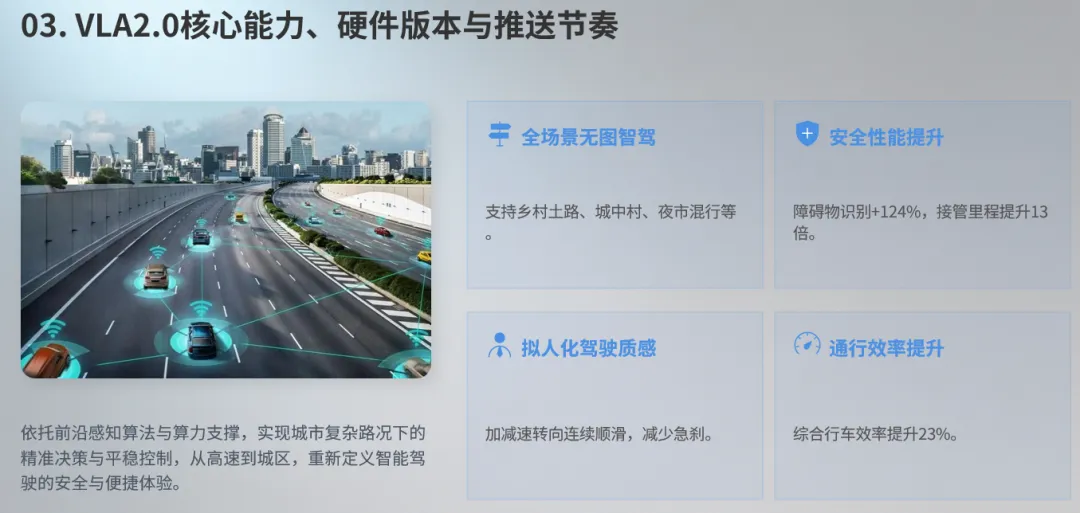
Ultra/Ultra SE版:搭载完整VLA2.0高阶能力,支持全场景无图智驾 Max版:阉割蒸馏版本,缺失窄路、无导航漫游等核心高阶功能 3月19日优先推送P7 Ultra,陆续覆盖G7、X9 Ultra;4月拓展至全系Ultra车型;Max版本高阶能力将于下半年更新。 小鹏&北大联合研发视觉剪枝技术,过滤无效画面信息,降低算力消耗 自研5nm图灵芯片软硬协同,算力利用率大幅提升 扩散模型精细化控车,实现连续顺滑的转向、加减速操作 无语言层导致可解释性差,车辆异常决策没有中间推理记录,故障排查、车规认证难度大;大模型识别偏差会直接变成操控动作,缺少文字校验缓冲;陌生长尾场景存在判断失误风险。 光影、倒影容易误判触发刹车;暴雨、逆光、大雾等极端天气智驾易降级退出;低矮平躺障碍物识别偏弱,大多仅减速、无法百分百刹停。 匝道、分岔路口偶尔选错车道;部分场景变道、超车逻辑保守,原地等待时间过长;匀速跟车存在轻微速度波动,部分转向角度不足。 地库、园区漫游功能暂时下线;施工路段容易犹豫蠕行;超窄老街、集市复杂场景容易卡停;高速超大车、匝道变道仍有优化空间。 高低配版本能力差距大,用户预期落差明显;高度绑定自研芯片,海外落地存在监管壁垒;能力迭代高度依赖海量路测数据。 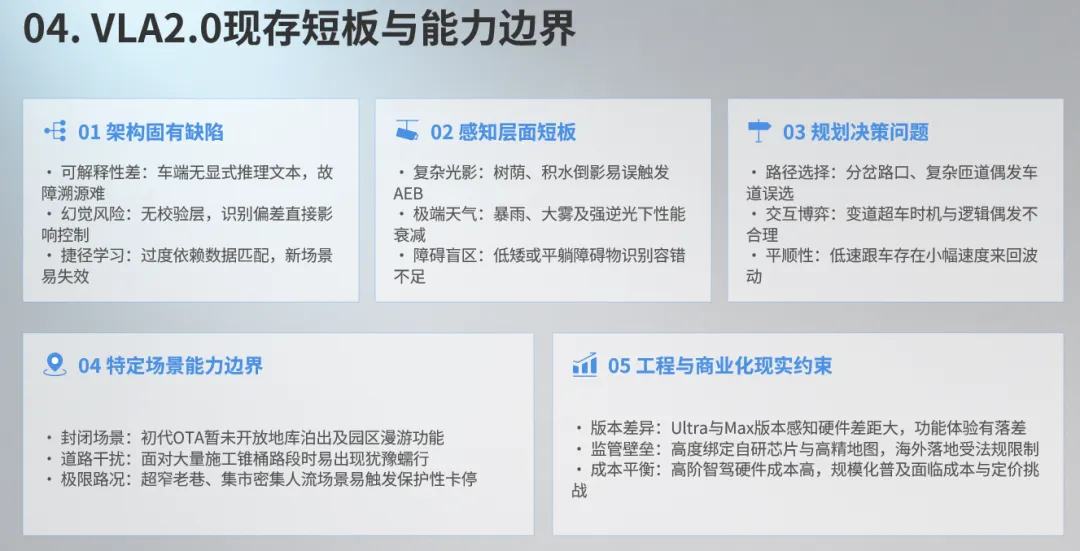
注:大部分体验问题可通过后续OTA优化,架构层面的黑盒短板无法彻底解决。 目前行业两大主流VLA路线,取舍非常鲜明:
简单总结:理想为了稳妥和可溯源,保留完整逻辑;小鹏为了速度、体验和量产,砍掉冗余环节。 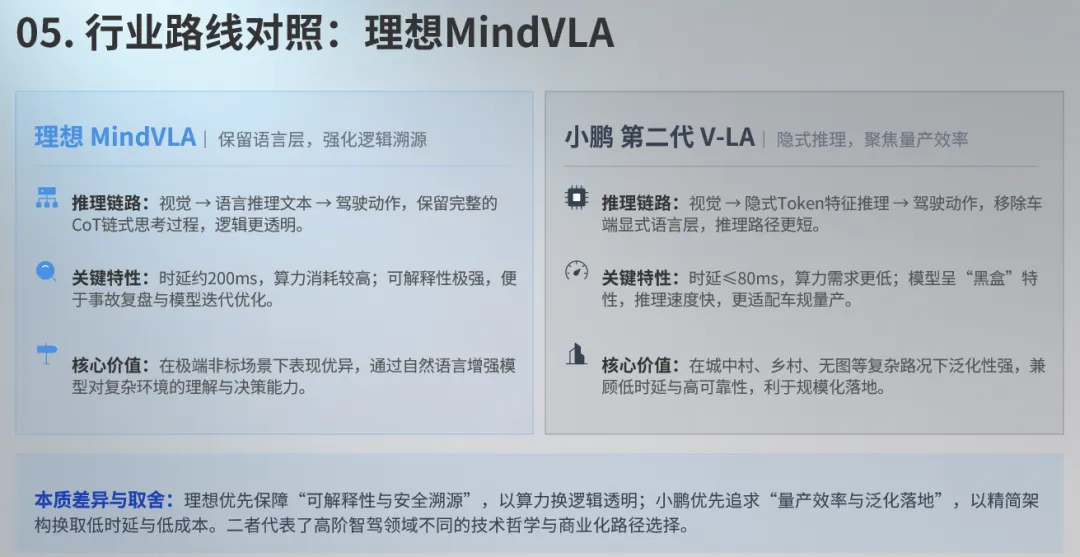
人类开车靠本能反应,不需要逐帧“心里默念路况”,实时文字翻译本身就是冗余步骤 紧急场景毫秒级差距决定安全,80ms超低时延,大幅降低险情接管率 并非丢掉语言能力,只是训练学规则、行车不用翻译,核心认知能力还在 无需人工图文标注,海量实拍视频可直接迭代,大幅降低研发成本、加速进化 摆脱高精地图束缚,适配国内复杂非标路况,同时可对外技术授权,商业化价值更高 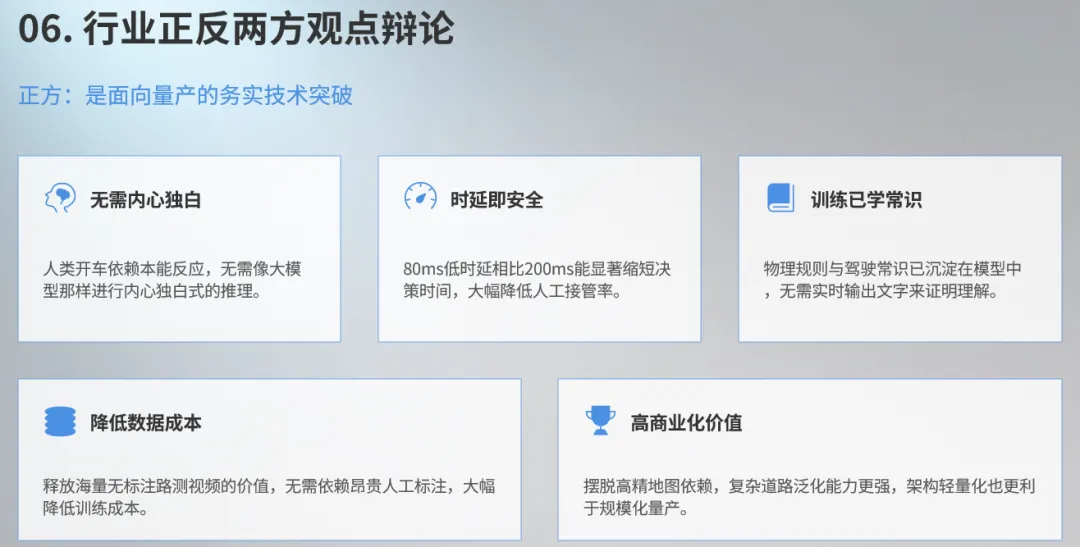
黑盒推理无法溯源,故障排查、车规认证、事故定责难度极大,不利于长期合规发展 大模型幻觉问题仍存在,没有语言层前置校验,误判会直接变成车辆危险动作 极端罕见场景缺少文字链式思考兜底,陌生高危场景容错率更低 车端无实时语言推理,严格来说不再是完整VLA架构,存在概念包装嫌疑 现阶段存在导航偏离、极端天气降级、低矮障碍物识别不足等实打实的落地短板 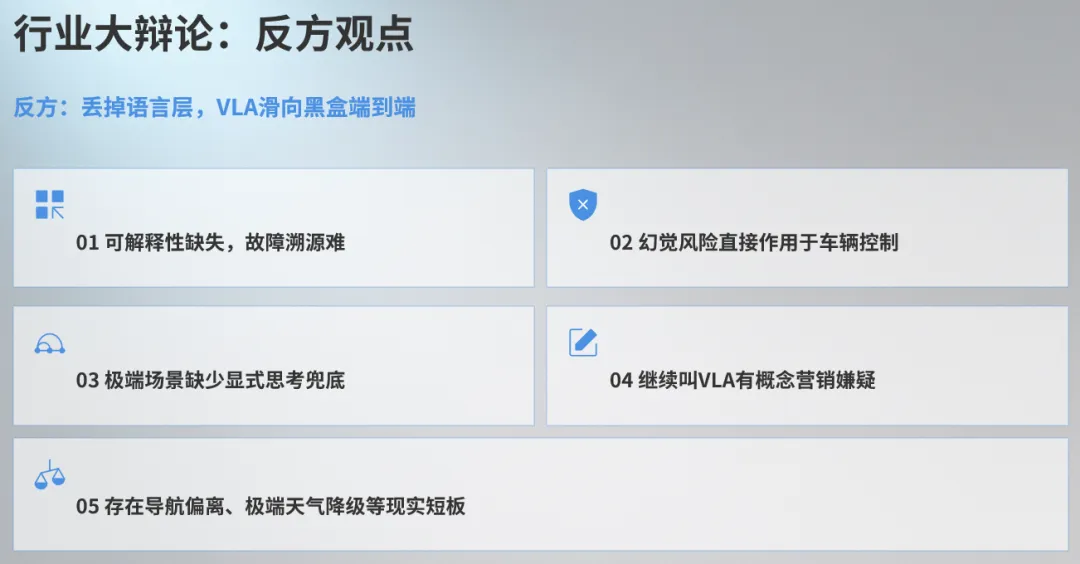
目前行业不存在绝对完美的技术路线,未来大概率走向混合双模式架构: 日常普通路况,采用小鹏式隐式推理,保证低时延、高流畅度;遇到高危、极端陌生场景,自动唤醒语言链式思考,做一层安全校验兜底,兼顾体验、速度与安全。 小鹏VLA2.0推动智驾从“数据匹配”升级为“物理世界认知”,代表行业新方向;华为、理想的保守路线也具备合规、稳健的独特优势,国内智驾正式进入多技术路线百花齐放的阶段。 小鹏第二代VLA砍掉车端实时语言层,不是单纯的功能升级,也不是纯粹的概念妥协,是量产体验与安全合规的精准取舍。 它用“放弃部分可解释性”的代价,换来了更低时延、更强的复杂路况泛化能力、更顺滑的驾驶体验和更低的量产成本,是面向普通用户、面向大规模普及的务实技术革新。 但黑盒推理的先天短板、特殊场景的能力不足,也客观存在。孰优孰劣无需定论,最终所有技术路线,都会由长期实车体验、安全数据和行业法规来验证。 互动留言 互动话题:你觉得小鹏第二代 VLA 删掉语言层,是技术突破还是概念妥协?欢迎在评论区留言讨论! 喜欢硬核智驾干货,欢迎关注AI研习干货、点赞、转发、收藏,后续持续更新自动驾驶、具身智能技术前沿内容! 文章整理不易,如果认可内容可任意打赏,点击下方👇喜欢作者,您的认可,是我们更新的动力❤️❤️❤️ 关键词标签:#小鹏VLA2.0#X‑Mind#鸿蒙乾崑ADS#WEWA架构#V‑LA架构#VLA一代二代对比#理想MindVLA#自动驾驶VLA#端到端智驾#城市NOA#物理AI#图灵芯片#FastDriveVLA
小鹏第二代VLA(X-Mind)作为全球首款量产级物理世界智驾大模型,最大的改动就是砍掉了车端实时语言翻译环节。这一操作引发行业巨大争议:有人认为是智驾代际升级,也有人质疑是单纯的概念炒作。
一、从VLA1.0到2.0:砍掉语言层,解决了老版本诸多痛点
1、传统VLA1.0的核心短板
2、VLA2.0核心升级:无语义中转,视觉直接控车
对比维度 | VLA1.0 | 小鹏VLA2.0 |
|---|---|---|
决策流程 | 视觉→语言转译→动作执行 | 视觉画面→直接输出操控指令 |
推理时延 | 200ms | 80ms以内,反应速度快3倍 |
决策逻辑 | 固定规则+文字理解 | 物理世界预判,接近老司机直觉 |
地图依赖 | 高度依赖高精地图 | 全场景无图智驾,小路、野路也能走 |
二、底层架构对决:小鹏X-Mind vs 华为WEWA
1、小鹏VLA2.0(X-Mind):单一体全域智能推演
2、华为乾崑WEWA:上下分层、云端赋能
3、两者取舍:没有绝对输赢,各有优劣
对比维度 | 小鹏VLA2.0 | 华为WEWA |
|---|---|---|
架构模式 | 单模型一体化全域推演 | 云端+车端双层分离协作 |
核心能力 | 自主预判、低时延、复杂小路更强 | 场景储备足、恶劣天气更安全 |
主要短板 | 感知出错易连锁失误 | 模块割裂,部分工况驾驶不流畅 |
三、VLA2.0实测能力、版本区别与推送节奏
1、四大核心能力升级
2、硬件版本差异(重点)
3、OTA推送节奏
4、三大核心技术支撑
四、客观短板:VLA2.0现阶段无法规避的问题
1、架构天生缺陷
2、感知识别短板
3、决策行驶问题
4、特殊场景不成熟
5、工程落地局限
五、行业路线对比:小鹏极简V-A vs 理想完整V-L-A
对比维度 | 理想MindVLA(保留语言层) | 小鹏VLA2.0(去除车端语言层) |
|---|---|---|
推理流程 | 视觉→文字推理→控车 | 视觉→直接控车 |
响应时延 | 约200ms,反应偏慢 | 80ms内,响应更快 |
可解释性 | 强,便于故障溯源、合规认证 | 弱,纯黑盒推理 |
算力消耗 | 高、硬件门槛高 | 低、更利于量产普及 |
优势场景 | 极端罕见场景,逻辑推演更严谨 | 国内复杂城市、乡村小路,驾驶更顺滑 |
六、行业大辩论:是技术突破,还是概念妥协?
正方:去掉语言层,是量产最优解(真突破)
反方:舍弃语言层,是妥协与营销包装
请在微信客户端打开
七、行业未来展望:两条路线终将融合
全文总结
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:596563534@qq.com 。
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- 15-30万2026年上市轿车怎么选?
- 老司机唠车:宝马SUV从X1到X7怎么选,一篇给你捋明白
- 魏牌9系旗舰SUV,车长5299mm,搭载双电机四驱,功率大幅提升
- 一切为了孩子的家庭SUV市场,终于出现了人性化觉醒
- 宝马7座SUV:直降18.3万!3.0T六缸发动机
- 15万内纯电SUV怎么选?银河E5和示界06,老刘说句实话
- 湖北宜城包车租赁全覆盖: 5-55座轿车商务车中巴大巴,旅游团建商务接送机场高铁一站搞定
- 世界模型:自动驾驶先跑通,机器人卡在哪?
- Uber曾卖掉自动驾驶业务,如今为何砸100亿美元杀回Robotaxi?
- 别克全新纯电动轿车上市,并且有702公里的续航