前言:自动驾驶的"大脑"里有一环特别容易被忽视——预测。前面讲感知篇讲了车"看到"什么、讲规控篇讲了车"怎么开车",但中间漏了一个关键问题:车"猜"周围的车/行人接下来会怎么动?这一步听起来简单,做起来是 PNC 三大模块里最难、最耗算力、对数据最饥渴的一环。本篇就来拆解预测这件事,欢迎大家一起探讨~
一、预测在自动驾驶里是个什么角色
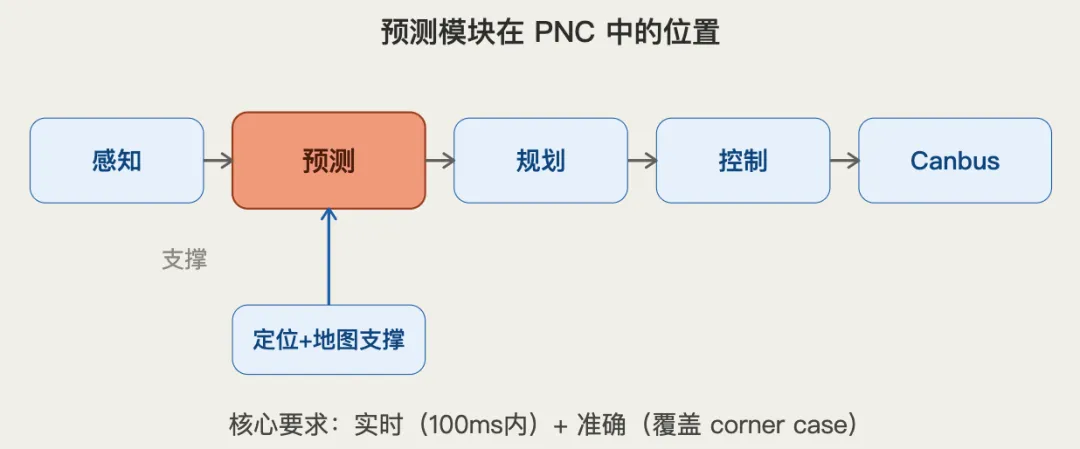
自动驾驶的核心决策链路可以抽象成一条流水线:感知(Perception)→ 预测(Prediction)→ 规划(Planning)→ 控制(Control)。前面规控篇把这个链路高度概括成PNC(Planning and Control),但 PNC 内部其实还包含三个层级——预测、路径规划、决策+控制。1.1 PNC 的完整构成
模块 | 英文 | 主要职责 |
预测 | Prediction | 预测周围车辆/行人未来 3-8 秒的运动轨迹 |
路由 | Routing | 从导航地图选路(和地图篇讲的导航链路对应) |
规划 | Planning | Decision(让/停/绕)+ Path(路径)+ Speed(速度)三层 |
控制 | Control | 把轨迹变成油门/刹车/方向盘指令 |
预测接收感知送来的障碍物轨迹和地图信息,输出每个障碍物未来一段时间的可能轨迹;规划拿到这些预测结果后才决定自己怎么走。1.2 一个反直觉的事实
你以为"自动驾驶的核心是规划控制"?其实行业里有个数据可能让你意外——2018 年美国 DMV(车管局)自动驾驶接管报告里,Waymo 平均跑了17000 公里才需要一次人工接管,GM Cruise 是 8000 公里,第二梯队只有几百公里。Waymo 的领先不只是感知和规划做得好,预测占了相当大的功劳。预测失败的最典型场景是——拥堵时的"幽灵刹车"和无保护左转时对向来车速度估计错误。前者是因为预测模块对前车切入太敏感,后者是因为横向车辆的速度预测误差大。这两个场景恰好也是城市 NOA 最难的两个 corner case。
二、为什么需要预测——1 帧 100 毫秒的稀缺
预测模块的核心要求只有两条:实时性(Real time)和准确性(Accuracy),但这两条要求在自动驾驶里都极端苛刻。2.1 实时性的硬约束
自动驾驶的决策链路是流水线作业。以典型的10Hz系统为例:10 Hz = 100 ms / 1 帧
感知:约100 ms(接收到一帧传感器数据)
预测:约100 ms(推算障碍物未来轨迹)
规划:约200 ms(重新规划自己路径)
控制:约200 ms(执行到机械层)
合计:约600 ms
也就是说,每 100 毫秒就要完成一次"感知→预测→规划→控制"的循环。如果预测这 100 毫秒不省着用,整个链路就卡了。2.2 准确性的矛盾
预测准确性要求高,但路况预测几乎不可能 100% 准确。这就像一个有经验的老司机也只能"猜"前车下一步动作,而不能保证一定对。多种预测类型并存:单一轨迹不够用,所以预测模块通常输出概率分布——未来 3 秒可能在哪 5 个位置,每个位置概率多少。多角色预测不一致:行人、自行车、机动车各自行为模式完全不同,必须分别建模。2.3 需要更多 corner case
感知靠摄像头能识别 90% 的常规物体,但剩下 10% 的 corner case(施工锥桶、异型车辆、临时改道)往往决定生死。预测也一样——常规工况预测准确率 95% 没用,corner case 才是决定上限的地方。这也是为什么行业现在的共识是:学完所有人类司机的做法(Data-driven)+ 结合人类常识和物理规律(Model-based)。两者只能往上叠,不能互相替代。
三、预测的两大方法论
行业里做预测的方法分两条路线:Model-based(基于模型)和Data-driven(数据驱动)。前者是人类把规则告诉机器,后者是机器从数据里自己学规则。3.1 两条路线对比
维度 | Model-based | Data-driven |
核心思路 | 人工建模 + 物理规则 | 深度学习 + 海量数据 |
优势 | 解释性强、能覆盖 corner case | 覆盖常见模式准确率高 |
劣势 | 规则多到爆炸、写不过来 | 偏置于训练数据、长尾场景乏力 |
典型工具 | 卡尔曼滤波、运动学模型 | LSTM、CNN、Transformer |
数据需求 | 少量 | 大量 |
代表应用 | Apollo 早期 Lane Model | Waymo ChauffeurNet |
3.2 Data-driven 的产业化挑战
Waymo 招聘"行为预测工程师"的要求里,LSTM、Machine Learning、Real-time、Data engineering都被列为硬性技能。这个岗位要求你既要懂 ML 算法,又要能部署到实时系统,还要处理海量数据 pipeline——这就是行业现实:Data-driven 不是装个模型就跑。3.3 两条路线的融合
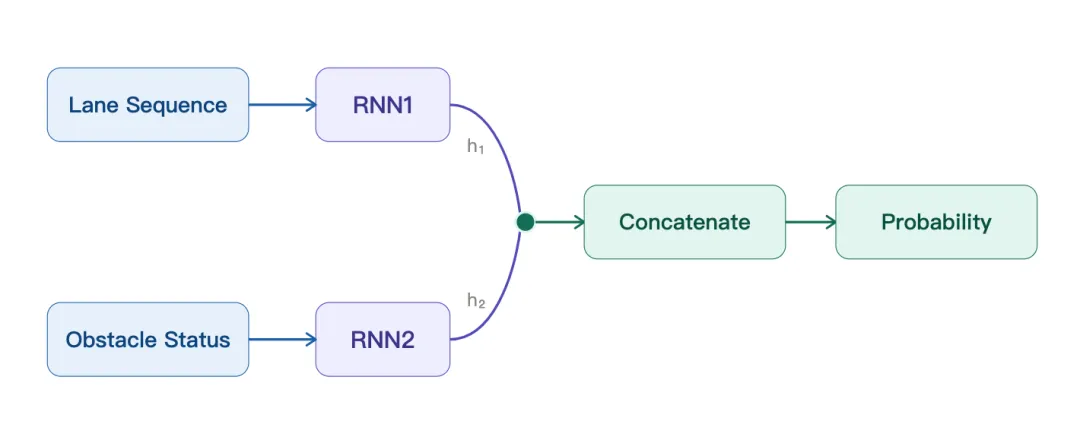
Apollo 的做法是Model-based 打底 + Data-driven 提升——Model-based 给出概率车道(lane sequence)+ Data-driven 的 RNN 网络对其重新打分。这种"先验 + 后验"的两段式预测,是当下最主流的工业方案。
四、Apollo 的预测实战
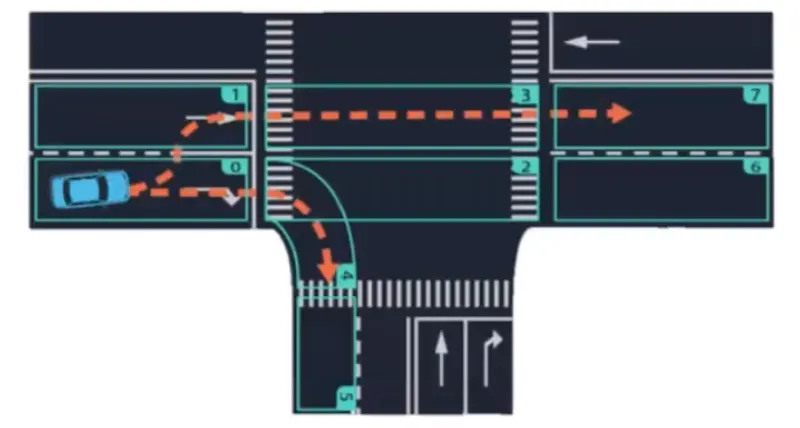
Apollo R3.5.0(GitHub 开源)的 prediction 模块是一个典型的"Model + Data-driven"两段式系统。下面我们按流水线拆解。4.1 车道序列模型(Lane Model)——预测的基础
Apollo 把 "车在路上走" 抽象成Lane Sequence(车道序列):车从当前车道出发,能走到哪几个目标车道。元素 | 含义 |
HD Map | 高精地图里提取的车道连接关系 |
Junction | 路口(车可以选择直行/左转/右转) |
Off lane | 离开正常车道(如临时停车/违停) |
Lane0 → Lane1 → Lane3 → Lane7 (左变道直行) Lane0 → Lane2 → Lane6 (直行) Lane0 → Lane4 → Lane5 (右转)Apollo 通过遍历高精地图的 lane graph,穷举出所有可能的 lane sequence,然后用分类器对每条路径打概率。4.2 车道特征(Lane Feature)
每个车道序列需要带一些"交通规则"信息作为输入特征:- Traffic law:交通规则(限速、是否可驶入)
4.3 车辆状态(Vehicle State)
4.4 环境信息(Environment)
4.5 神经网络结构
网络 | 用途 | 输入特点 |
MLP(多层感知机) | 处理静态特征(车辆状态、车道特征) | 一维向量 |
CNN(卷积) | 处理栅格化图像(鸟瞰图) | 二维图像 |
RNN(循环神经网络) | 处理时序序列(历史轨迹) | 序列数据 |
LSTM / GRU | RNN 改进版,缓解长序列梯度消失 | 序列数据 |
Attention | 关注关键帧/关键障碍物 | 序列+特征 |
TCN(时序卷积) | 并行处理时序,比 RNN 快 | 序列数据 |
RNN 及其改进版(LSTM、GRU)的核心思想是:用"门"控制历史信息的保留和遗忘。对自动驾驶来说,"前车 3 秒前开始减速"这个信息很重要——LSTM 的"门"机制能保留这种长距离依赖。4.6 Apollo 模型融合
Apollo 把 Lane Sequence 和 Obstacle Status(障碍物状态)分成两条 RNN 子网络,分别处理后Concatenate(拼接)一个概率向量:4.7 Data Pipeline(数据流水线)
离线(训练):Record 数据 → 样本清洗 → Label(人工标注) → RNN Model在线(推理):Channel 消息 → 特征提取器 → 原始特征 → 在线高阶特征生成 → 模型推理 → 行为预测环节 | 作用 |
Auto labelling | 自动打标(基于历史数据 + 数据挖掘 + 主动学习) |
Label data | 标注数据(含正/负样本) |
Label cleaning | 清洗错误标签 |
Label balance | 正负样本均衡(避免"几乎不变道"导致模型偷懒) |
4.8 轨迹生成(Trajectory Builder)
预测模块最终输出的是具体轨迹——轨迹由三部分组成:Kalman filter(卡尔曼滤波):平滑历史轨迹,去除抖动Polynomial(多项式):用多项式表达未来轨迹的形状(直线/抛物线/曲线)Velocity(速度):结合物理限制和交通规则生成速度曲线
五、车辆预测 SOTA
Apollo 的预测框架是 2018 年的工业范本,但这几年行业又有了新进展。下面看两个代表方案。5.1 Uber:基于 CNN 的短期运动预测
Uber 的方案是 "Short-term Motion Prediction of Traffic Actors for Autonomous Driving using Deep Convolutional Networks"(基于深度卷积网络预测交通参与者的短期运动)。阶段 | 作用 |
Raster input | 把道路、车辆、行人栅格化(生成图像) |
Base CNN | 提取鸟瞰图特征 |
Concat | 栅格特征 + 状态特征拼接 |
Fully connected | 全连接层输出回归预测 |
Trajectory generate | 输出未来轨迹点(回归问题) |
亮点:把预测转成回归问题(而非分类问题),直接输出连续轨迹坐标。5.2 Waymo ChauffeurNet:模仿学习新范式
Waymo 的 ChauffeurNet 提出一个全新的思路——Mid-to-mid learning(中间到中间的学习)。传统方案是Perception → Prediction → Planning → Control(端到端从感知到控制),或者Modular(每个模块独立训练)。ChauffeurNet 提出一个折中:把中间几个模块(感知 → 预测 → 规划)整体训练,输入中间表示(场景渲染图),输出中间表示(轨迹)。ChauffeurNet 发表于 RSS 2019(Robotics: Science and Systems),作者包括 M. Bansal、A. Krizhevsky、A. Ogale。维度 | ChauffeurNet 做法 |
训练数据 | 模仿"最好的司机"(Imitation learning) |
Corner case 补偿 | 合成"最坏的工况"(Synthesizing the Worst) |
多任务损失 | 碰撞损失 + 偏离道路损失 + 进度损失,多重损失共同约束轨迹 |
多任务整合 | 把预测和规划合并训练(Combine prediction and planning) |
ChauffeurNet 论文全称是 "ChauffeurNet: Learning to Drive by Imitating the Best and Synthesizing the Worst"——"学习最好的,合成最坏的",这是它在数据层面非常有开创性的做法。资料来源:Waymo 官方介绍页(https://sites.google.com/view/waymo-learn-to-drive)
5.3 Uber vs Waymo 的对比
维度 | Uber CNN | Waymo ChauffeurNet |
数据形式 | 鸟瞰图栅格 | 场景渲染图 |
学习范式 | 监督学习 | 模仿学习 + corner case 合成 |
输出 | 轨迹点回归 | 轨迹 + 多任务预测 |
预测+规划 | 分离 | 融合训练 |
代表意义 | 工业稳定的范式 | 下一代端到端范式 |
六、行人预测——和车辆预测不一样
行人预测是预测模块里最特殊的一类任务,因为行人行为规律和车辆完全不同。6.1 行人预测的三大难点
特点 | 说明 |
High randomness(高随机性) | 行人可能突然变向、停下接电话、回头看 |
Low traffic constraints(低交通约束) | 不像车必须沿车道走,行人可穿马路、绕障碍 |
No kinematics model(无运动学模型) | 车的运动可由物理公式建模,行人几乎不行 |
6.2 业界基准数据集
6.3 Social LSTM——解决"人-人交互"
李飞飞团队的Social LSTM(论文 "Human Trajectory Prediction in Crowded Spaces")是行人预测的经典模型。核心创新:Social Pooling(社交池化)传统 LSTM 只考虑自身轨迹。Social LSTM 让周围每个行人也跑一个 LSTM,所有 LSTM 的隐藏状态通过"社交池化"互相共享。这模拟了真实场景中:"我看到前面那个人让我,我也会绕开他。"
S-Pooling 层把一个行人周围多个邻居的隐藏状态网格化后聚合(基于行人之间的相对距离做空间 bin),再合并到主 LSTM 的输入。资料来源:Social LSTM 开源实现(https://github.com/xuerenlv/social-lstm-tf)
6.4 Social GAN——生成"合理"的多条轨迹
Social LSTM 能预测单条轨迹,但行人行为本身有随机性(同一个起点,5 分钟内可能走 5 种不同路径)。Social GAN 引入Generative Adversarial Networks(生成对抗网络):Generator(生成器):用 LSTM Encoder-Decoder + Pooling Module 生成多条候选轨迹Discriminator(判别器):判断生成的轨迹是否"真实"GAN 的好处是:一次性生成多条"看起来都合理"的轨迹,覆盖行人可能的多样行为。资料来源:Social GAN 开源实现(https://github.com/agrimgupta92/sgan)
6.5 多任务学习——预测未来行为和位置
李飞飞团队后续的 "Peeking into the Future: Predicting Future Person Activities and Locations in Videos" 提出多任务学习:同时预测行人未来的位置和活动(如走路、骑车、挥手)。模块 | 作用 |
Person Behavior Module | 行为预测(活动类型) |
Person Interaction Module | 交互建模(人-物交互) |
Visual Feature Tensor Q | 视觉特征张量 |
Trajectory Generator | 轨迹生成(结合 Focal Attention) |
Multi-task learning | 同步输出位置 + 活动 |
意义:行人预测从"只有位置"升级到"位置 + 行为",对自动驾驶的"我要不要让这个行人"决策帮助更大。6.6 行人预测 vs 车辆预测
维度 | 车辆预测 | 行人预测 |
建模方法 | 车道序列 + 物理模型 | 社交交互 + 行为模式 |
不确定性 | 较低(车道约束) | 较高(自由行动) |
数据来源 | 高精地图 + 感知 | 视觉 + 行人检测 |
代表模型 | Lane Model + RNN | Social LSTM / Social GAN |
输出 | 车道序列概率 + 轨迹 | 多条候选轨迹 + 活动 |
七、总结
预测是 PNC 链路里承上启下的一环——承接感知输出的轨迹,输出规划可用的轨迹。本篇把预测这件事拆成了三个层级:7.1 三大关键认知
维度 | 核心要点 |
方法论 | Model-based(先验规则)+ Data-driven(数据学习)必须融合 |
工程挑战 | 离线训练(Auto labelling + Label balance)+ 在线推理(特征工程) |
未来方向 | 端到端(端到端→中间到中间)、多任务、corner case 合成 |
7.2 行业现状速览
Waymo:17000 公里/次接管,ChauffeurNet 把预测+规划融合训练Apollo:Model-based(Lane Sequence)+ Data-driven(RNN),开源工业范本行人预测:Social LSTM → Social GAN → 多任务学习,逐步逼近真实行为说到底,预测就是把"现在"翻译成"未来 3-8 秒"。这个翻译做得准,自动驾驶才能从"看见"走到"理解",再到"推理"。下一篇我们会在这个基础上展开讲规划,欢迎大家探讨~
谢谢观看,码字不易。如果觉得文章对您有帮助,感谢您点个在看,转发分享!
 10个月宝宝每天需要喝多少奶粉?