端到端自动驾驶新框架!PrismAD把规划器拆成三位专家,转弯碰撞率降低83.3%!
- 2026-10-11 05:51:49
点击下方卡片,关注「3D视觉工坊」公众号选择星标,干货第一时间送达
来源:3D视觉工坊
3D视觉硬件汇总,包括结构光3D相机(支持室内外,焊接,机械臂抓取等场景),相位偏折术、散斑、机械臂抓取和焊接软件,手持扫描仪(支持定位、重定位、稠密建图)、四足狗和小车定位和导航,底盘。点击->查看详情:大盘点!3D视觉硬件汇总!涵盖科研级和产品级!包括3D相机、机械臂抓取软件、手持扫描仪、小车、无人机等!
周围车辆决定“会不会撞”,车道几何决定“能不能走”,导航指令决定“到底往哪走”。传统端到端规划器却把三类 token 全塞进同一个表示空间。PrismAD干脆拆成互动、几何、意图三位规划专家,再让路由器按场景投票。
端到端自动驾驶规划器每天都在处理三种完全不同的问题。
前方车辆突然减速,需要判断交互和碰撞风险;
车辆进入弯道,需要沿车道边界调整曲率;
导航命令要求左转,需要压制直行候选,选择符合路线意图的轨迹。
这些因素最终共同决定自车轨迹,但它们的语义角色并不一样。
现有 SparseDrive、DiffusionDrive 等查询式规划器,通常把目标 token、地图 token、自车 token 和命令信息汇入同一个规划分支。统一表示简单直接,却也让一个网络同时学习动态交互、静态几何和高层意图。
结果可能是:最强的目标交互信号主导了表示,车道几何与命令只在最后轻轻修正;或者不同因素在同一个参数空间里互相干扰,复杂转弯场景尤其容易暴露问题。
清华大学、东南大学、武汉理工大学和上汽通用五菱团队提出的 PrismAD,把 Mixture-of-Experts 从普通 FFN 层提升到了完整规划分支:
先按语义把场景 token 拆成互动、几何、意图三组,再交给三个参数独立的 motion-planning expert;最后由语义感知路由器分别为运动预测和自车规划分配权重。
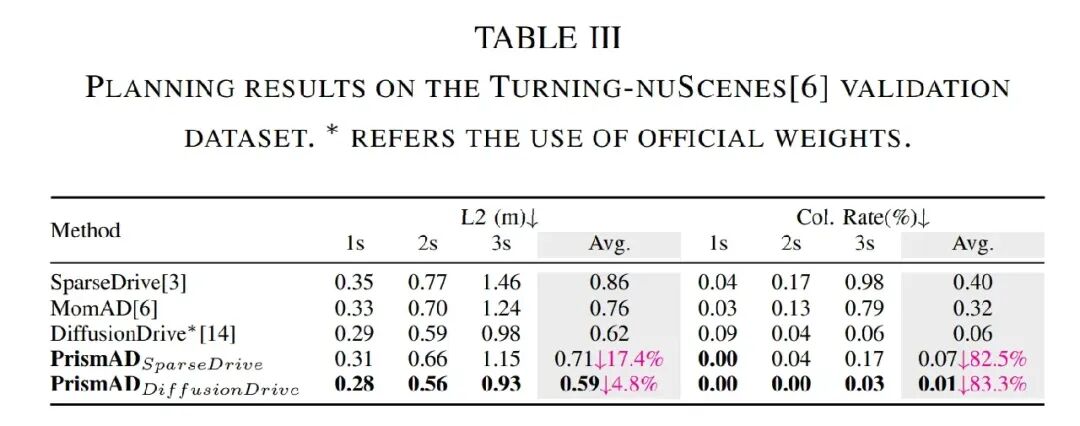
在 Turning-nuScenes 上,PrismAD 将 SparseDrive 的平均碰撞率从0.40% 降到 0.07%,相对下降82.5%;基于 DiffusionDrive 时,从0.06%降到 0.01%,相对下降83.3%。
📄 论文标题:PrismAD: Decoupled Planning via Semantic Mixture-of-Planners for End-to-End Autonomous Driving👥 作者:Kang Ding、Zhigui Lin、Hongsong Wang、Jie Gui、Qi Liu、Zhe Wang、Luqi Tang、Lei He🏫 单位:清华大学、东南大学、武汉理工大学、上汽通用五菱等🔗 论文链接:https://arxiv.org/abs/2607.10336💻 代码状态:论文称将于后续公开
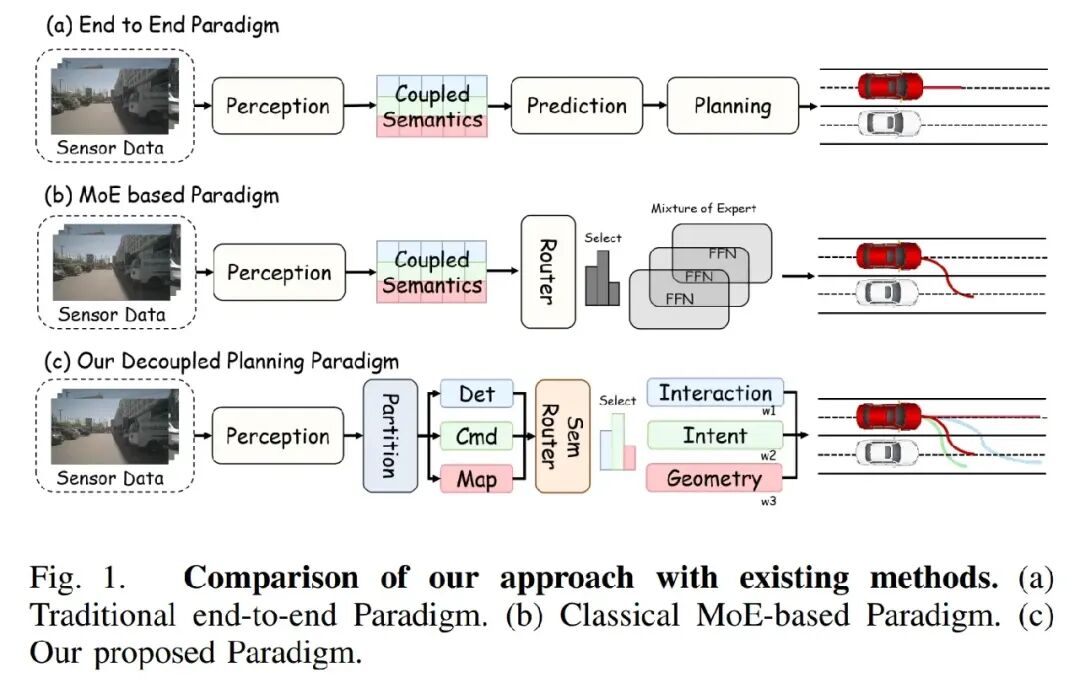
传统方法先混合所有语义,经典MoE在中间层分专家;PrismAD直接把完整规划器按语义拆开。
一、问题不是 token 太多,而是不同 token 被迫在一个空间里说同一种“语言”
动态目标、地图元素和导航命令并不是同质信息。
目标查询主要编码位置、速度、类别和交互关系,决定避碰与让行;地图查询描述车道中心线、边界、可行驶区域和路口结构,决定轨迹是否符合道路几何;导航命令与自车状态则负责高层决策,例如直行、左转、右转和当前运动状态。
传统规划器把它们拼在一起,再用同一套注意力和 FFN 处理。网络当然可以学习不同作用,但所有因素共享参数,模型必须自己在隐空间里完成语义分工。
这会带来两个问题。
第一,因素专门化不充分。一个在车流密集场景里很擅长处理 agent-agent 关系的表示,不一定同样擅长解析复杂道路拓扑。
第二,可解释性较弱。最终轨迹发生变化时,很难知道是前车交互、弯道几何还是导航意图起了主导作用。
已有自动驾驶 MoE 研究常按场景类型、运动模式、任务需求、相机视角、驾驶技能或奖励目标分专家。PrismAD认为,这些划分仍没有直接对准“轨迹由哪些语义因素决定”这个问题。
于是,它选择最直接的三分法:
Interaction:周围动态目标与自车之间的交互; Geometry:道路拓扑、车道边界与可行驶约束; Intent:导航命令与自车状态表达的高层意图。
这里的幽默点很技术:不是让三个专家分别处理晴天、雨天和夜晚,而是让他们分别回答“别撞谁”“沿哪条路”“到底去哪”。
二、第一步:先把场景token按语义硬拆开
设感知模块输出的场景 token 集合为 。PrismAD将其划分为:
互动 token 从高置信度动态目标查询中选择,主要携带周围参与者的运动状态与潜在交互。
几何 token 来自地图元素查询,描述局部道路结构、车道边界和可行驶区域。
意图 token 由导航命令 embedding 与自车状态构建,表达高层驾驶方向。
每一组 token 都会拼接同一个 ego token:
这样,三个专家都以自车为共同参考系,但只接收与自身职责相关的语义信息。
论文用 t-SNE 可视化了三条分支中的 ego token。未做语义拆分时,特征混在一起;拆分后,互动、几何和意图分支形成明显不同的簇。
t-SNE当然不能单独证明专家真的学会了完整规划能力,但至少说明硬分区确实把三类表示推向了不同特征空间,而不是复制出三个几乎一样的分支。
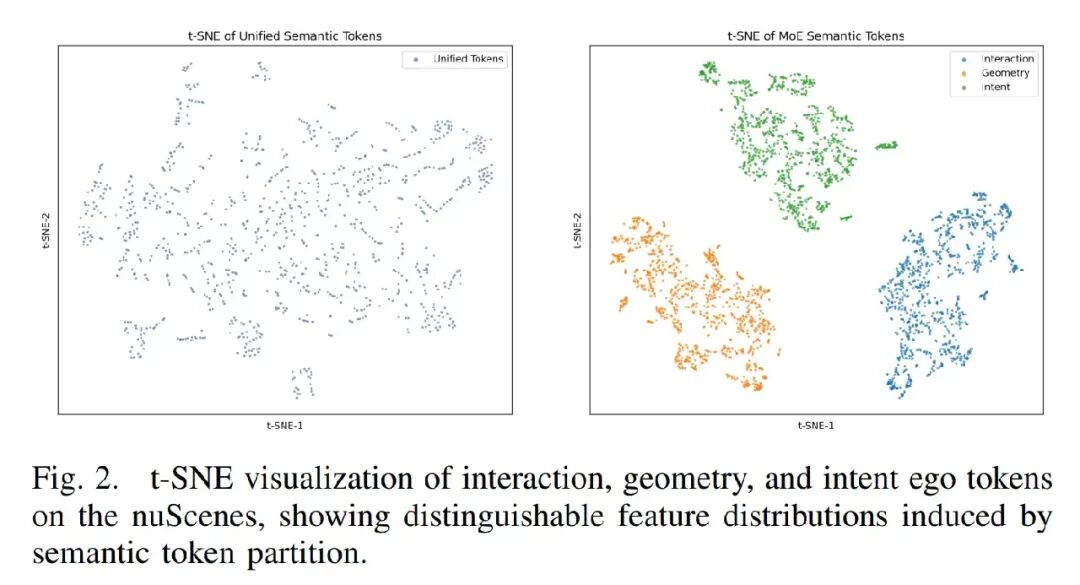
语义分区后,互动、几何、意图ego token形成清晰分离的特征分布。
三、它不是普通MoE:每个expert都是一套完整的运动预测+规划器
普通 Transformer MoE 往往把 FFN 替换为多个小专家。输入先经过共享注意力,再按 token 或样本选择部分 FFN。
PrismAD的尺度更大。
每个专家都拥有相同的规划网络结构,但参数完全独立。它会读取对应语义 token 与历史特征,先进行时间注意力,再在分支内部建模 token 关系,经过归一化、FFN 和 refinement,最终同时输出:
周围 agent 的运动预测 ; 自车规划候选 。
形式上:
三位专家职责明确。
互动专家重点处理 agent-agent、ego-agent 关系;几何专家强调道路拓扑与地图约束;意图专家学习命令条件下的规划行为。
更关键的是,专家表示学习阶段没有 cross-expert attention。三个分支不会在中间特征层互相交换信息,避免几何信息重新流回互动分支、意图信息再次被混合。
这是一种很强的归纳偏置:
先让专家真正独立学会自己的因素,再在输出层融合,而不是一边分工一边串门。
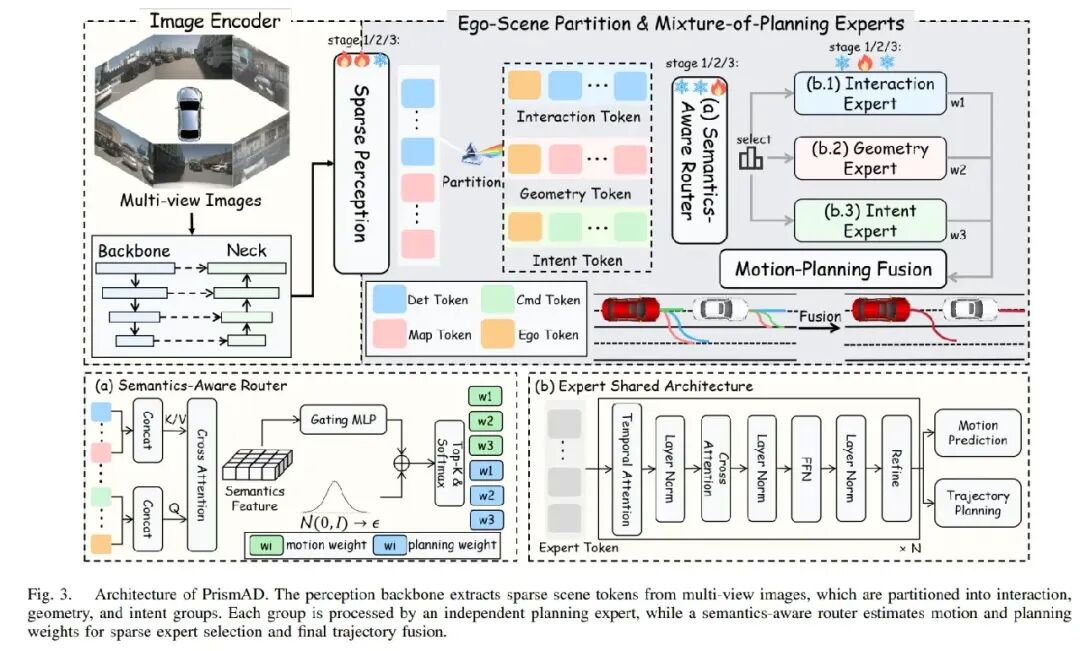
三个专家共享结构但不共享参数,分别输出运动预测与自车轨迹,路由器只在最终阶段决定如何组合。
四、路由器不是只给一组权重:运动预测与自车规划各投一次票
三位专家都输出结果后,最简单的方法是平均融合。
但场景不同,语义因素的重要性显然不同。
密集交通中,互动专家应占更大比重;弯道或复杂路口,几何专家的重要性上升;导航命令变化时,意图专家必须及时拉回轨迹方向。
PrismAD设计了一个 semantics-aware router。
路由器先把 ego token 与 command/status 拼成自车中心查询,把检测 token 与地图 token 作为 key/value,通过 cross-attention 汇总决策相关上下文:
随后,MLP输出 6 个 routing logit:前三个对应运动预测专家,后三个对应自车规划专家。
为什么要分两套权重?
因为预测别人的运动,通常更依赖互动信息;规划自己的轨迹,则可能更受道路几何和导航意图影响。若共用同一组权重,相当于假设“预测前车怎么走”和“决定自己怎么走”需要完全相同的专家偏好,这并不合理。
训练时,路由 logit 会加入高斯噪声,再分别执行 Top-K 与 softmax:
最终分别融合:
互动专家始终保持激活,因为它包含时间传播的 agent 信息,是运动预测的基础分支;几何与意图专家再根据场景得分选择性开启。
噪声门控的作用类似于给路由器一点受控扰动,避免它训练早期永远押注同一位专家,造成 expert collapse。
五、三阶段训练:先把每位专家练明白,再教路由器怎么选
端到端同时训练三个专家和路由器,很容易出现一个问题:某位专家因为早期稍微占优,路由器开始持续偏向它,其他专家收不到足够梯度,最终全体退化成“互动专家加两个摆设”。
PrismAD用三阶段训练降低这种竞争。
第一阶段,按 SparseDrive 或 DiffusionDrive 的原始流程训练强基线,先得到可靠的感知、在线地图与基础规划 token。
第二阶段,替换原规划头,训练互动、几何、意图三个独立专家。此时路由器不启用,每个专家都用自己的 motion 与 planning loss 单独监督,确保它先获得专门能力。
第三阶段,冻结感知骨干和所有专家,只训练路由器与融合模块。最终损失只作用于融合结果,路由器学习的是“如何组合已经训练好的专家”,而不是边选边改专家内部表示。
这套训练流程更稳定,但也带来明显工程成本:模型训练不再是一条端到端脚本,而是多 checkpoint、多冻结策略的分阶段管线。
还有一个容易漏看的实验细节:虽然方法描述允许 intent 分支融合 command 与 ego status,论文在 nuScenes 实验中遵循既有协议,明确不使用 ego status 输入,以避免模型通过自车状态走“捷径”。因此,表格结果里的意图专家更主要依赖导航命令与相应语义表示。
六、开环结果:不是巨幅刷点,但两种基线都稳定改善
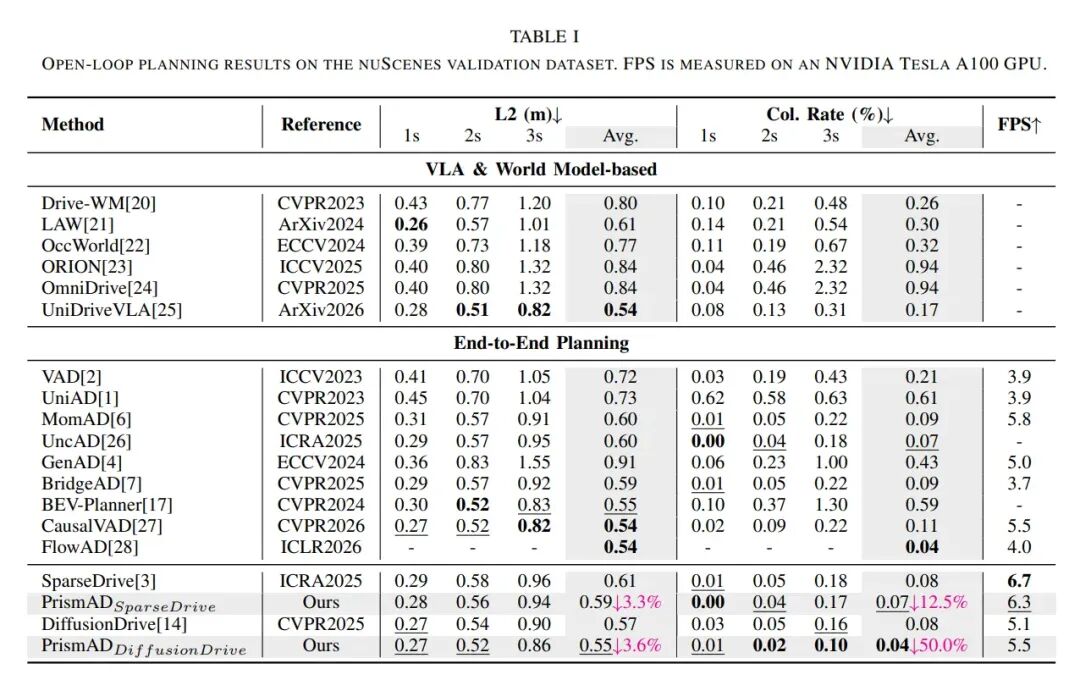
在 nuScenes 开环规划上,PrismAD兼容 SparseDrive 和 DiffusionDrive 两个基线。
基于 SparseDrive 时,平均 L2 误差从 0.61 米降到 0.59 米,平均碰撞率从 **0.08% 降到 0.07%**,推理速度从 6.7 FPS 变为 6.3 FPS。
基于 DiffusionDrive 时,平均 L2 从 0.57 米降到 0.55 米,平均碰撞率从 **0.08% 降到 0.04%**。论文表中报告的速度为 5.5 FPS,基线为 5.1 FPS。
从绝对值看,L2 只下降约 0.02 米,提升不算夸张;安全指标的变化更值得关注,尤其 DiffusionDrive 版本碰撞率减半。
这也符合方法逻辑:几何与意图专家未必让轨迹中心点大幅靠近 GT,但可能在道路边界、转向选择和危险间距上做出关键校准。
七、闭环安全结果更有说服力,但绝对碰撞率仍然不能回避
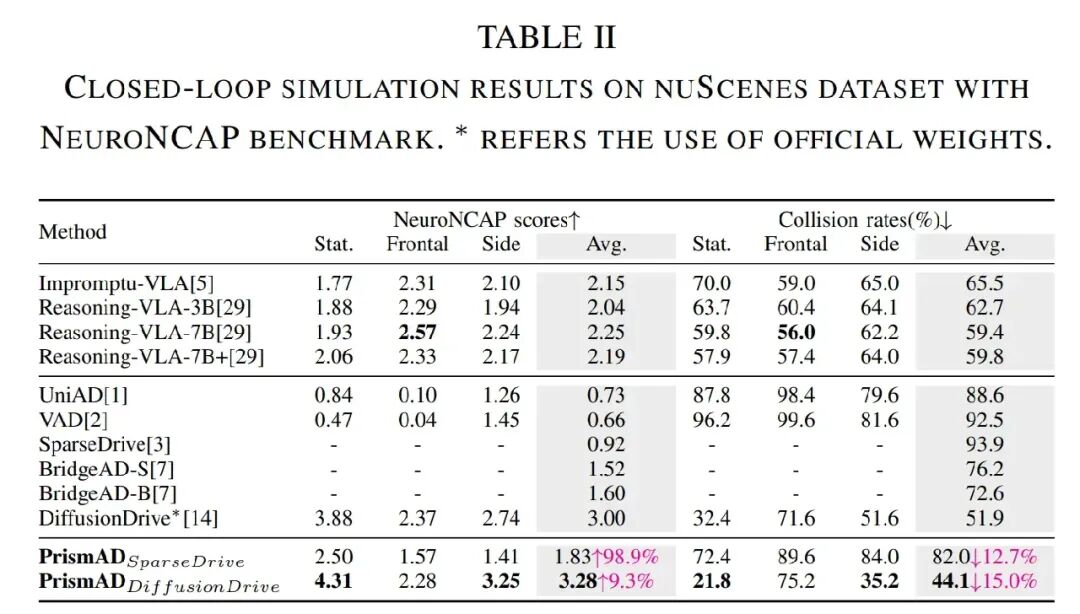
在 NeuroNCAP 闭环安全评测中,PrismAD对两种基线都有明显改善。
SparseDrive 的平均 NeuroNCAP score 从 0.92 提升到 1.83,相对提升 98.9%;平均碰撞率从 **93.9% 降到 82.0%**。
DiffusionDrive 的平均 score 从 3.00 提升到 3.28,平均碰撞率从 **51.9% 降到 44.1%**。
这些数字证明语义专家融合在执行轨迹的闭环环境里确实有作用,尤其在 stationary、frontal 和 side 三类碰撞场景中,模型能更好地调整避障行为。
但必须把绝对值说清楚:
82.0% 和 44.1% 依然是很高的闭环碰撞率。
NeuroNCAP本身就是专门构造的安全关键困难场景,不能直接等同日常道路事故率;即便如此,这些结果仍说明 PrismAD 是“显著改善强基线”,而不是已经解决闭环安全。
八、最对路的考场是Turning-nuScenes:几何和意图终于不再只是配角
标准 nuScenes 中有大量相对简单的直行样本,复杂几何和导航意图的重要性容易被平均指标稀释。
Turning-nuScenes专门筛选转弯场景,共 17 个 scene、680 个 sample,更适合检验几何与意图专家。
结果非常明显。
SparseDrive 的平均 L2 从 0.86 米降到 0.71 米,平均碰撞率从 **0.40% 降到 0.07%**。
DiffusionDrive 的平均 L2 从 0.62 米降到 0.59 米,平均碰撞率从 **0.06% 降到 0.01%**。
两组基线的碰撞率相对下降分别达到 82.5% 和 **83.3%**。
这说明 PrismAD最适合的不是所有因素都简单、互动专家一枝独大的场景,而是道路曲率、导航命令与周围车辆共同决定轨迹的场景。
九、消融实验揭示了一个很有意思的结论:几何和意图主要在“保安全”,不是单独刷L2
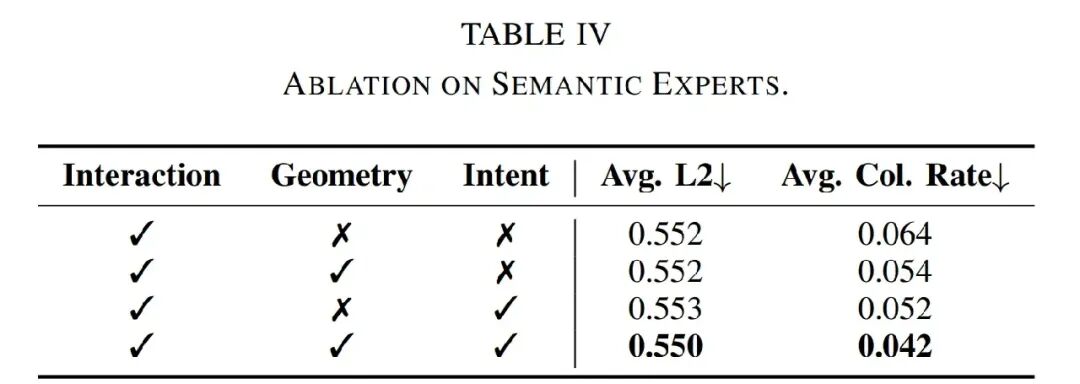
只使用互动专家时,平均 L2 为 0.552,碰撞率为 **0.064%**。
加入几何专家后,L2 仍是 0.552,但碰撞率降到 **0.054%**。
加入意图专家时,L2 为 0.553,碰撞率进一步降到 **0.052%**。
三个专家全开时,L2 才小幅降到 0.550,碰撞率达到最低的 **0.042%**。
这组结果很关键:几何与意图专家单独加入后,位移误差几乎不动,却持续降低碰撞率。
它们更像轨迹校准因素,而不是主轨迹生成器。互动专家先给出大致合理的运动方案,几何和意图再防止轨迹压线、转错方向或在关键位置留不够间距。
十、不是“多专家平均一下”就行:路由器才是把三位专家用活的关键
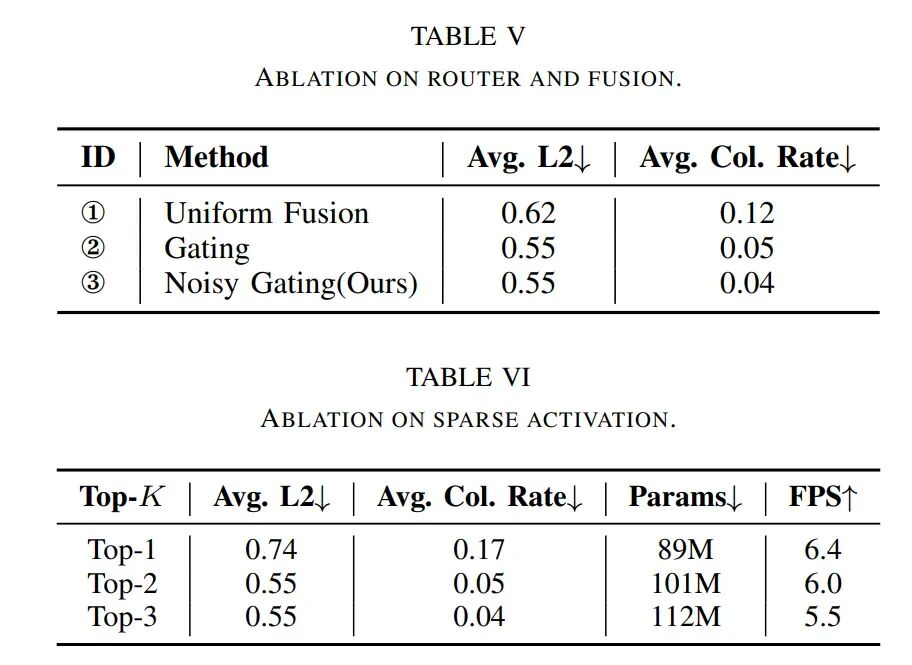
Uniform Fusion直接平均三个专家,平均 L2 为 0.62,碰撞率为 **0.12%**,反而是最差配置。
加入学习门控后,L2 降到 0.55,碰撞率降到 **0.05%**;再加入 noisy gating,L2不变,碰撞率进一步降到 **0.04%**。
这说明专家之间不是简单集成关系。几何专家在直行场景里可能只需极小权重,意图专家在命令稳定时也不应持续主导。平均融合会让不相关因素反复干预轨迹。
Top-K 消融同样说明了计算与性能的边界。
Top-1 速度最高,为 6.4 FPS,但 L2 恶化到 0.74,碰撞率升至 **0.17%**。只让一位专家工作,信息损失过大。
Top-2 达到 0.55 L2、0.05%碰撞率、6.0 FPS,是较好的折中。
Top-3 将碰撞率进一步降到 **0.04%**,但速度下降到 5.5 FPS。安全收益已经较小,计算量继续增加。
十一、小权重不等于没作用:有时专家只需要把轨迹推开十几厘米
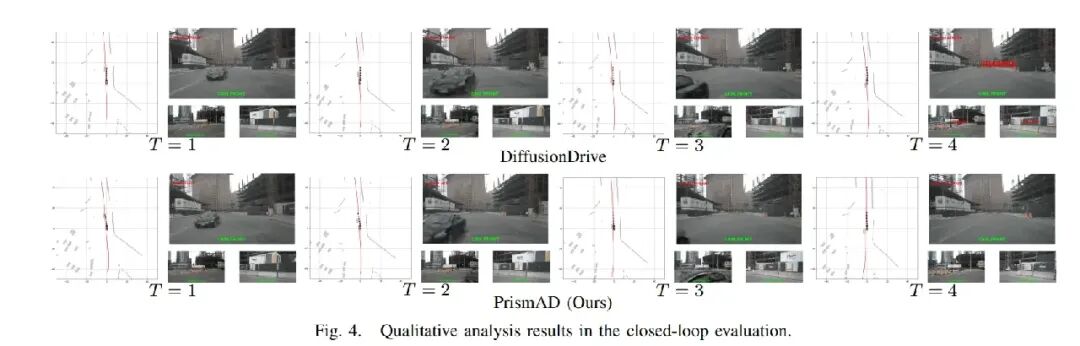
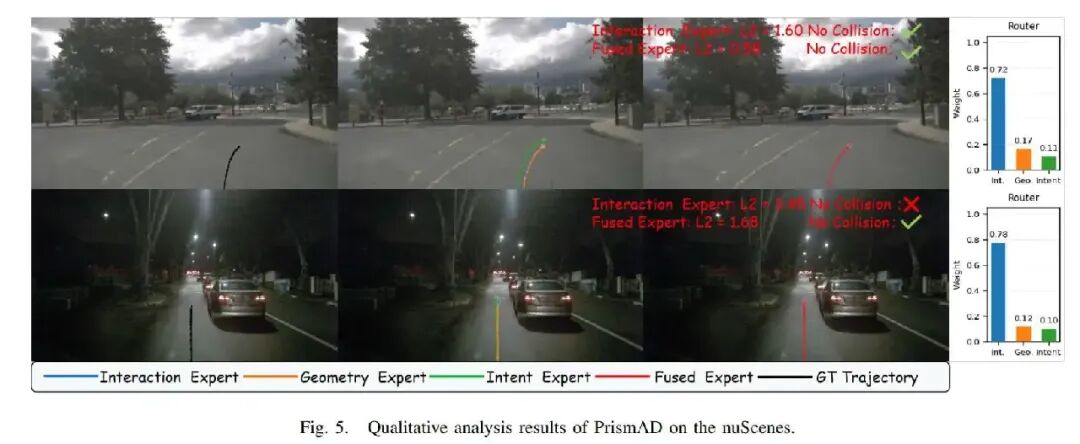
定性结果中,路由器给几何和意图专家的权重明显小于互动专家,但融合轨迹仍成功避免了互动专家单独输出时的碰撞。
这是规划任务里很常见的现象:轨迹主体可能已经正确,安全失败只来自某个局部位置偏了少量距离。几何或意图专家无需接管整条轨迹,只需要在关键时间步给出方向校正。
因此,分析 MoE 不能只看谁权重大。一个 0.1 权重的专家,也可能在弯道边界或路口选择上完成决定性修正。
写在最后:PrismAD不是让规划器更“大”,而是让不同信息先各自想清楚
端到端规划的一条常见路线,是把感知输出越来越统一:目标、地图、命令全部变成 token,再交给一个强 Transformer。
PrismAD提出了相反的提醒:
统一 token 形式,不代表所有语义都必须在同一个规划空间里推理。
互动、几何和意图对轨迹的作用不同,运动预测与自车规划对专家的需求也不同。PrismAD用三条完整规划分支保留因素专门化,再通过两套路由权重做自适应融合。
从结果看,它的最大收益并不是让平均 L2 突然下降很多,而是在转弯和闭环安全场景里持续减少碰撞。这与方法设计高度一致:
互动专家负责给出主动作,几何和意图专家负责在危险边界上把轨迹拽回来。
对于越来越复杂的端到端驾驶系统,这篇工作留下了一个值得继续追的问题:
当所有信息都已经被 token 化之后,下一步究竟应该继续混合,还是应该重新按决策语义拆开?
PrismAD给出的答案很明确——至少在规划层,分工可能比一锅端更有效。
本文仅做学术分享,如有侵权,请联系删文。
一、 课程背景
随着智能制造、三维检测、数字孪生等领域的飞速发展,高精度、高效率的三维形貌与尺寸测量技术已成为工业质检、逆向工程、医疗影像及科研探索中的核心需求。散斑投影三维测量技术,作为一种非接触、高精度的光学测量方法,在复杂表面重建和动态测量等场景中展现出不可替代的优势。
然而,该技术涉及相机标定、散斑设计、立体匹配、点云重建等多个交叉学科知识,体系庞杂且实践门槛高。市面上相关资源多集中于学术论文或零散的理论讲解,缺乏一套从硬件系统搭建、核心算法实现到完整系统集成的全流程实战指南。许多工程师和研究者希望掌握并构建自己的测量系统,却常常在理论模型与工程实现之间遇到障碍,难以完成从“理解原理”到“获得精准三维数据”的完整闭环。
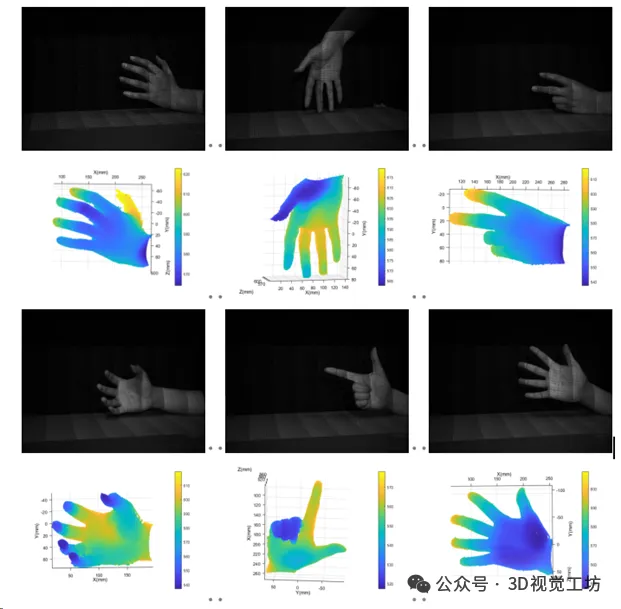
为此,我们精心打造了《从零开始搭建一套双目散斑3D重建系统[理论+源码+实践]》实战课程,旨在帮助学员从零开始,系统性地掌握散斑投影测量的全链路技术。通过深度的理论剖析与手把手的项目实践,本课程将引导学员不仅理解技术的数学与物理本质,更能亲自动手搭建软硬件系统,编写核心算法代码(散斑生成代码+立体匹配串行版本的代码),最终实现对待测物体的高精度三维重建,完成从知识到能力的实质性跨越。
二、 课程内容
最新的立体匹配方法与散斑生成技术:2025年以来见刊的方法!便于论文写作中与最新方法比较。 良好的科研思维:授人以鱼不如授人以渔,教授如何发现问题,解决问题,培养独立科研的能力。 从基础原理到核心算法:深入讲解结构光三维测量基本原理、散斑图设计、相机标定、立体匹配方法以及从图像到三维点云的坐标计算等关键知识体系。 全流程覆盖从理论到实践:课程将完整涵盖测量原理、软件框架设计、核心算法代码(散斑生成代码+立体匹配串行版本的代码)实现(使用Python、C++、MATLAB)、仿真环境搭建以及测量精度评估。 理论紧密结合实践:每个核心知识点均配套编程实践。在仿真环境中验证算法,杜绝纸上谈兵,确保学完即能动手实践。为学员后续从事工业视觉检测、三维扫描仪开发、相关学术研究打下坚实的能力基础。
三、 主讲介绍
主讲人Hally老师
目前985博士在读,长期专注于散斑结构光三维测量技术。擅长散斑投影设计、立体匹配算法开发、CUDA并行化计算等方面,具备深厚的理论功底与丰富的实践经验。
四、课程大纲
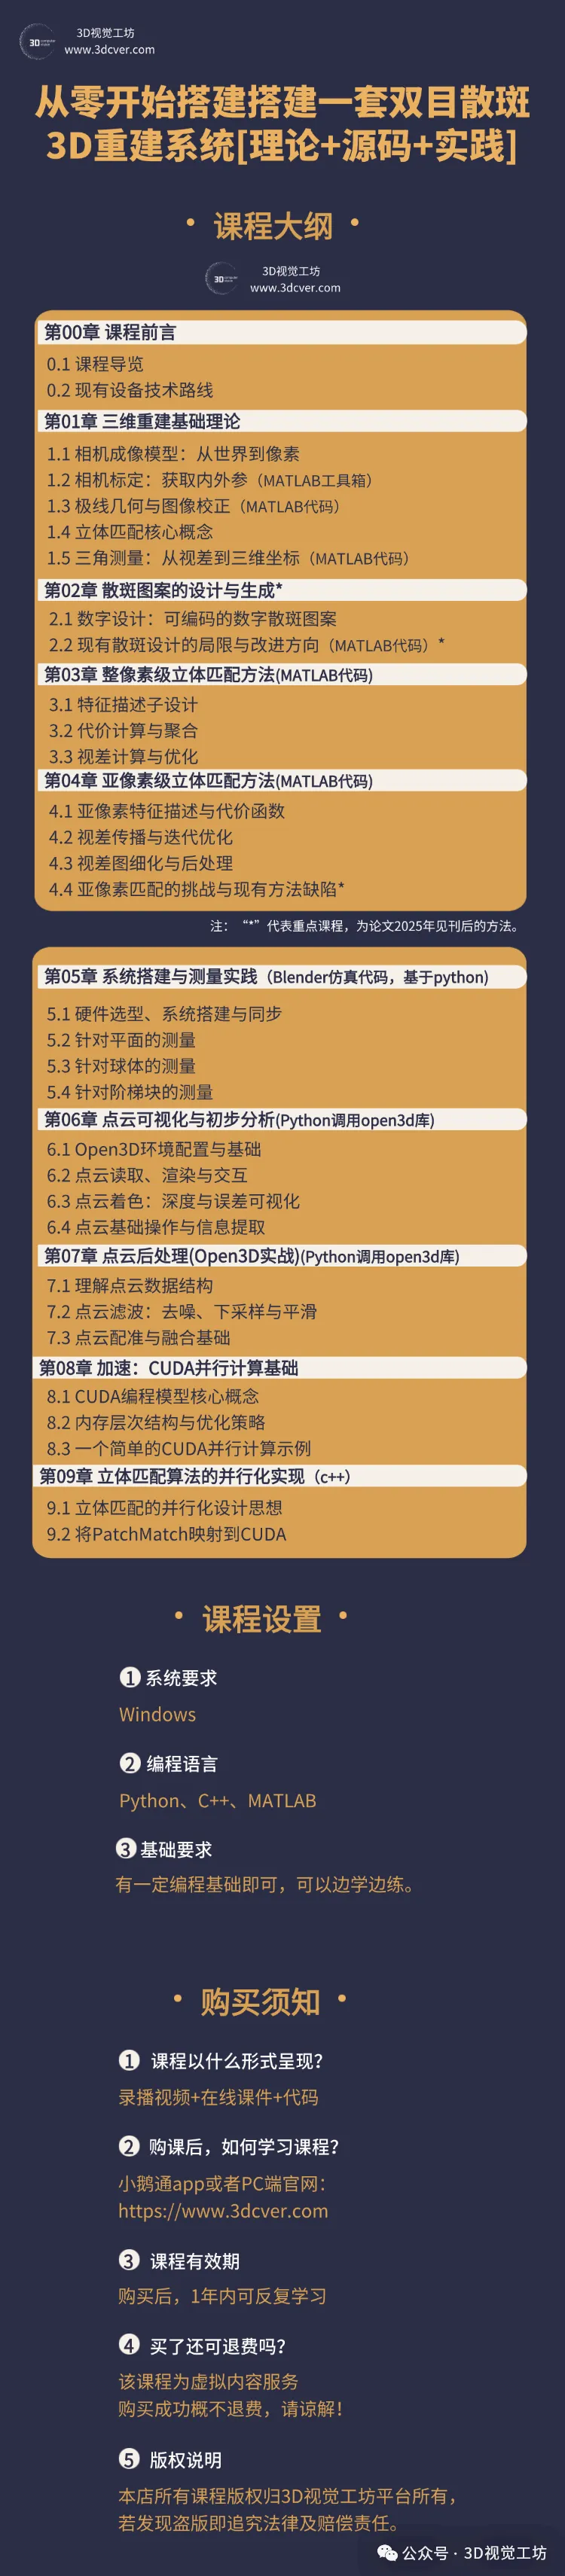
五、面向对象
视觉测量相关方向的本科生、硕士生、博士生; 从事视觉测量和三维重建相关任务的工程人员; 想要转入视觉测量领域的从业者。
六、 学后收获
对散斑轮廓测量术的相关算法原理、整体流程具有深入理解。 熟悉高精度测量系统开发及优化的理论基础。 获取2025年以来相关见刊方法的源码(重点内容)。 不仅学习到方法,更重要的是教会你科研思维,与写作思维(重点内容)。
七、硬件部分(需单独采购)
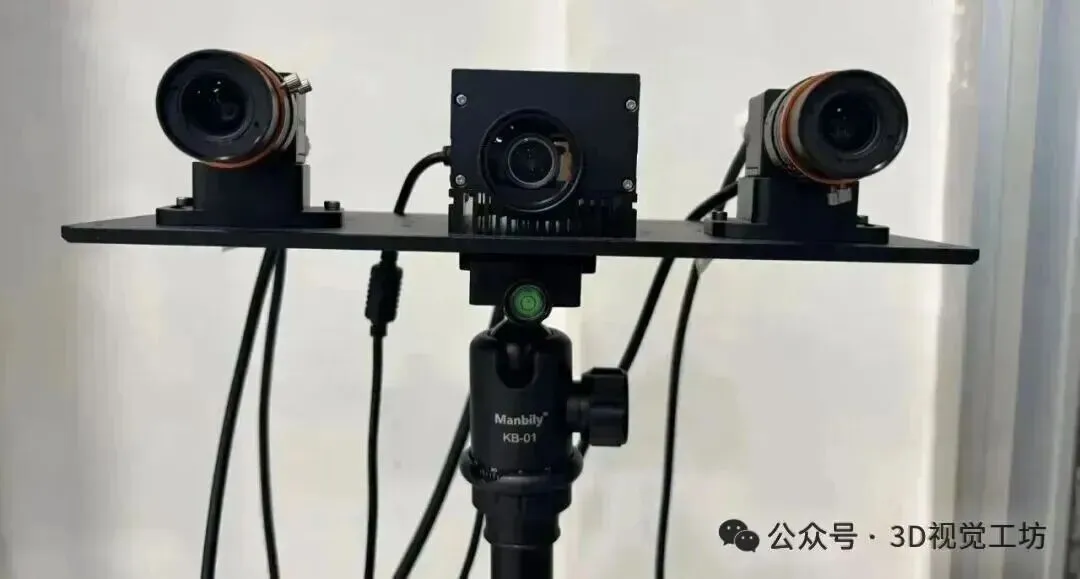
为了方便同学更快速地入门散斑结构光,3D视觉工坊也推出「DotCam-S1双目散斑结构光扫描仪」(采购硬件请联系文末客服)。产品性能参数如下表所示:
| 工作距离(mm) | ||
| 视场 | ||
| 重建精度 | ||
| 分辨率 | ||
| 基线度 | ||
| 接口类型 | ||
| 输出数据 | ||
| 操作系统 | ||
| VS平台 | ||
| SDK接口 | ||
| 外形尺寸 |
八、 答疑服务
课程答疑主要在本课程对应的鹅圈子中答疑,学员学习过程中,有任何问题可以随时在鹅圈子中提问。
开课时间:2026年9月5日(周六)晚8点,每周更新一章节!
注:开课前联系微信助理,立减500!