英伟达自动驾驶开源组合拳,到底在下一盘什么棋?
- 2026-10-27 19:28:29
英伟达自动驾驶开源组合拳,到底在下一盘什么棋?
一直以来,英伟达都是自动驾驶领域不可或缺的关键先生。从用于模型训练的H200、GB300,到用于车端推理的Xavier、Orin、雷神Thor,其琳琅满目、代代跃迁的芯片产品,始终是方案供应商和车企们的首选。 不过,从AI三要素-算力、算法、数据-的角度来看,英伟达的主要角色始终是一个算力供应商。算法层面,英伟达2016年便便布局端到端神经网络,早于特斯拉,却未大力投入推进工程化落地,长期停留在“探索”阶段。数据层面,尽管Cosmos世界基础模型平台能合成高度多样化的模型训练数据,但英伟达在数据规模与闭环应用上存在感不强。 在近日的2026CES展上,英伟达一口气开源了Alpamayo系列VLA推理模型、仿真工具AlpaSim和数据集,一定程度上补齐了算法和数据短板。在这次豪横的开源之后,“削平了自动驾驶门槛”,“挑战特斯拉FSD”的观点频现。事实究竟如何? 数据,被喻为人工智能时代的“石油”,是AI时代的重要资产。但对头部玩家来说,英伟达开源的数据集价值并不高。 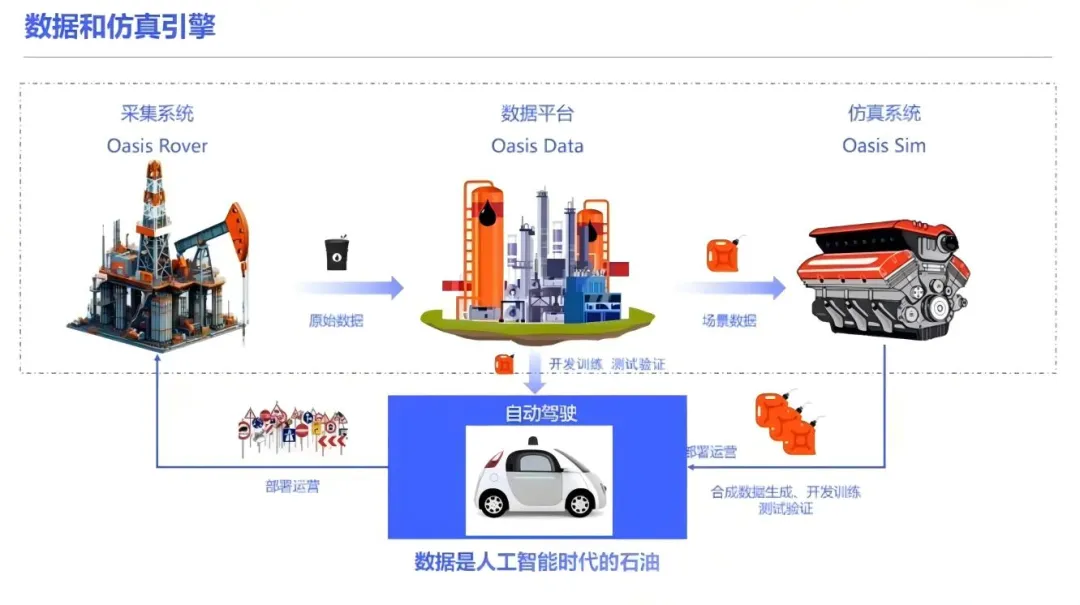
先看数据规模。英伟达此次开源了1700个小时的驾驶数据,乍看很有噱头,但对比特斯拉FSD积累的上亿段用于模型训练的Clips,高下立判!按每个视频片段三十秒计算,预估对应83.33万小时,两者差距五百倍之多! 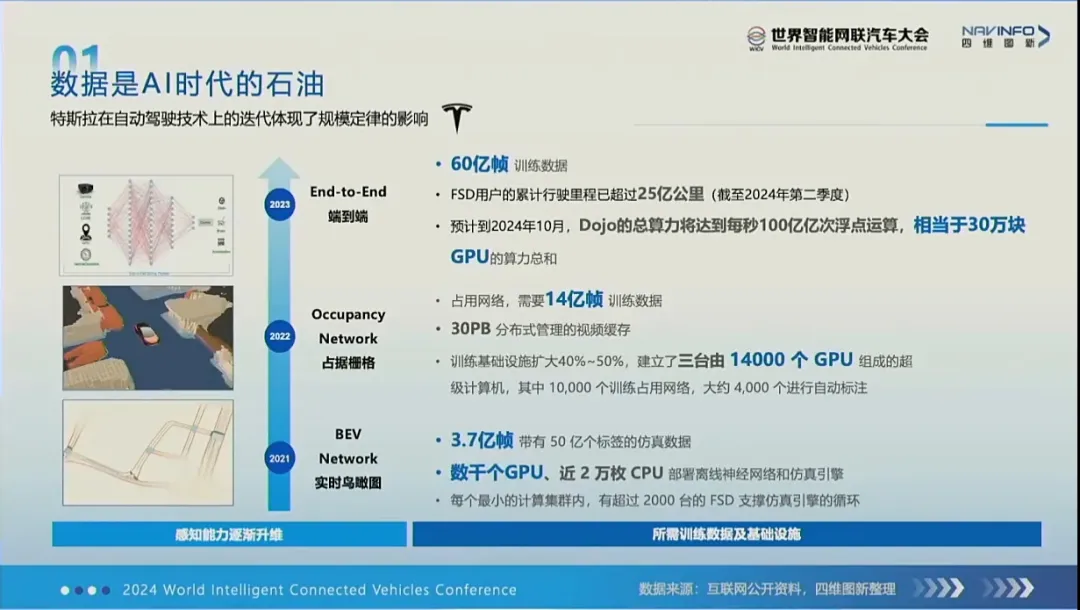
再看数据价值。在端到端自动驾驶时代,数据的价值在于为特定的模型挖掘长尾案例(Corner Case)。评价其价值高低,要看能否精准补上模型迭代的短板。不同公司的模型架构、传感器方案、训练策略各异,其知识盲区和薄弱环节也各不相同,对A模型构成挑战的长尾场景对B模型可能就是小菜一碟。 对自动驾驶玩家而言,数据工作的核心是构建深度融合云计算和AI大模型的高效数据闭环与工具链,在PB、EB级的海量原始数据中,精准筛选适配自家模型的高价值内容。既然数据要精挑细选、精准挖掘,那么,英伟达面向全行业的开放数据集到底有多大的价值,答案不言自明。 说实话,英伟达开源的Alpamayo VLA推理模型没多大实用价值。一是时空认知能力不足,在自动驾驶任务中缺失了一块重要的拼图;二是参数规模太大,无法实车部署;三是头部玩家保持竞争力的核心是私有数据闭环 + 自研专用硬件绑定专有模型,不可能为一个半成品改弦更张。 2025年12月初,英伟达就开源了Alpamayo-R1,核心正是专为物理AI打造的Cosmos Reason视觉语言模型。这款模型同年 8 月推出,是一款经海量视觉问答任务预训练的具身智能推理模型,后续还针对自动驾驶任务做了强化学习。它基于 VLM 的特性,具备很强的概念认知能力、复杂场景理解和逻辑推理能力,但美中不足的是时空认知能力偏弱。 
自动驾驶智能体与真实世界交互的核心是三维空间和一维时间,不仅“空间”用语言极难描述,“时间”的严格序列更是语言模型的短板。因此,自动驾驶智能体必须具备与“概念认知”并行的“时空认知”能力,能够学习物理规律、理解时空。这样一来,时空认知能力弱的世界模型无法补齐自动驾驶智能体与真实世界交互的短板,模型开源的价值大打折扣。 再看模型规模硬伤。Alpamayo-R1参数规模高达100亿,即便动用了非车规的RTX 6000 Pro Blackwell,也只跑出10Hz左右的帧率(端到端延迟99毫秒),反观特斯拉的36Hz,差距一目了然。 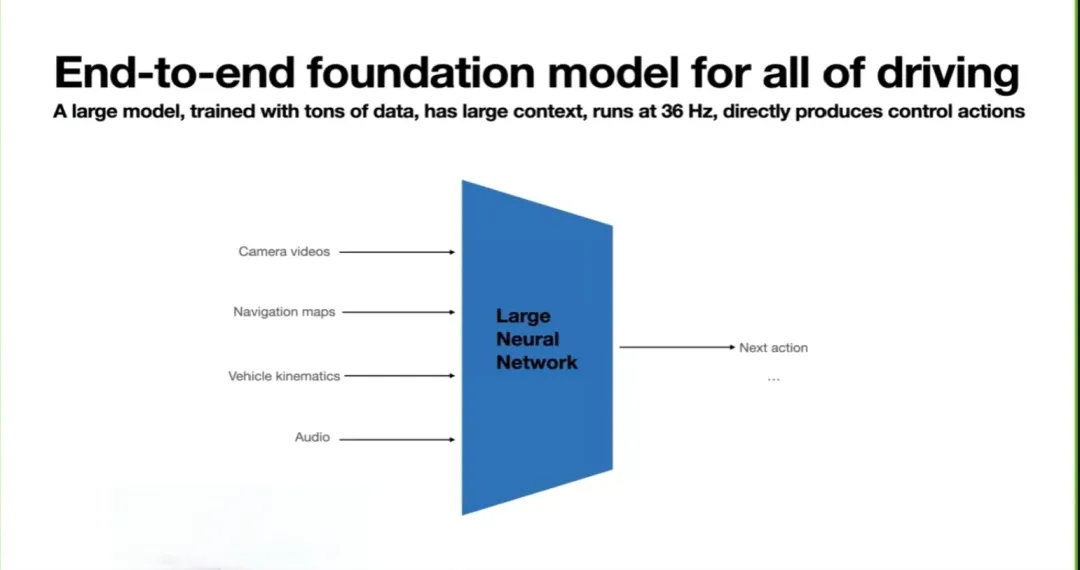
有观点认为,通过剪枝、量化、压缩这套组合拳,可以轻量化部署到车端;或者通过流式视频编码器、投机采样、GPTQ等技术提升模型的运行频率,能让百亿参数模型上车。这种思路把一众高手攻坚了二十年的自动驾驶想得太简单了。特斯拉、华为、小鹏、理想、蔚来这些手握自研算法栈、数据闭环和车规平台的头部玩家,不会舍近求远,去优化部署一个外部通用模型。 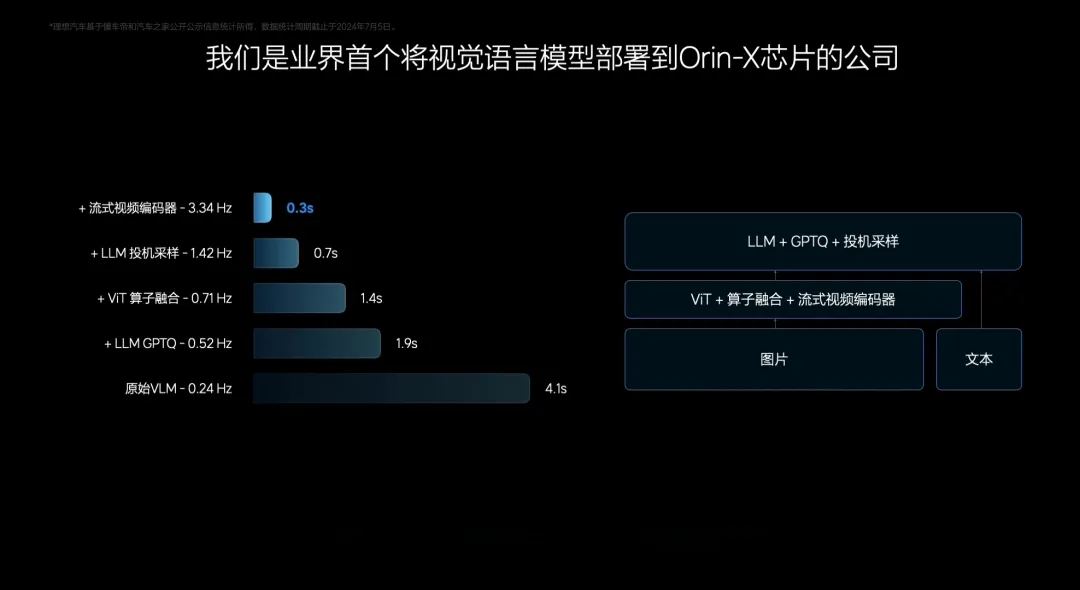
首先,头部玩家深耕多年,早已搭建起完整技术闭环,核心就是以算法与芯片的深度耦合实现高度的定制化,这种定制化的性能优势是通用硬件平台和通用模型难以比拟的。头部玩家们会持续迭代自研专有模型,而非引入一个与自家芯片格格不入的外部通用模型。 其次,如前文所述,数据的核心价值是为特定模型补齐长尾场景短板,头部玩家拥有的海量优质的私有车辆数据与其自研模型的知识盲区高度相关。而使用一个外部通用模型,意味着要将其庞大的、与自身数据分布不完全匹配的先验知识蒸馏到自家系统,这个过程不仅效率低下,还会稀释自身数据闭环的价值。 当然,英伟达Alpamayo系列模型也并非毫无价值,它可以带来一些方法论上的启示,也可以作为模型能力的对标基准,帮助车企或方案供应商横向评估自家模型在复杂推理、场景理解等维度的能力水平,发现自家技术的相对优劣。 或许有人会问,这个模型对非头部玩家有价值吗?我们想想未来几年,技术路线日益收敛、资源消耗巨大,非头部玩家的生存空间在哪儿?就知道这个问题没有讨论意义。 常言道“醉翁之意不在酒”,英伟达开源的三件套 —— VLA推理模型Alpamayo、自动驾驶数据集、仿真工具Alpasim中,Alpasim的存在感最低,却恰恰是此次开源的关键所在。其真正目的是借Alpasim推广背后的Cosmos和Omiverse。要知道,Alpasim虽是完全开源的端到端高保真自动驾驶仿真框架,但它并非孤立存在的工具。若想实现大规模、高保真的合成数据生成和复杂场景测试时,开发者会被自然引导到它背后更强大平台 —— Cosmos世界基础模型和Omniverse数字孪生。 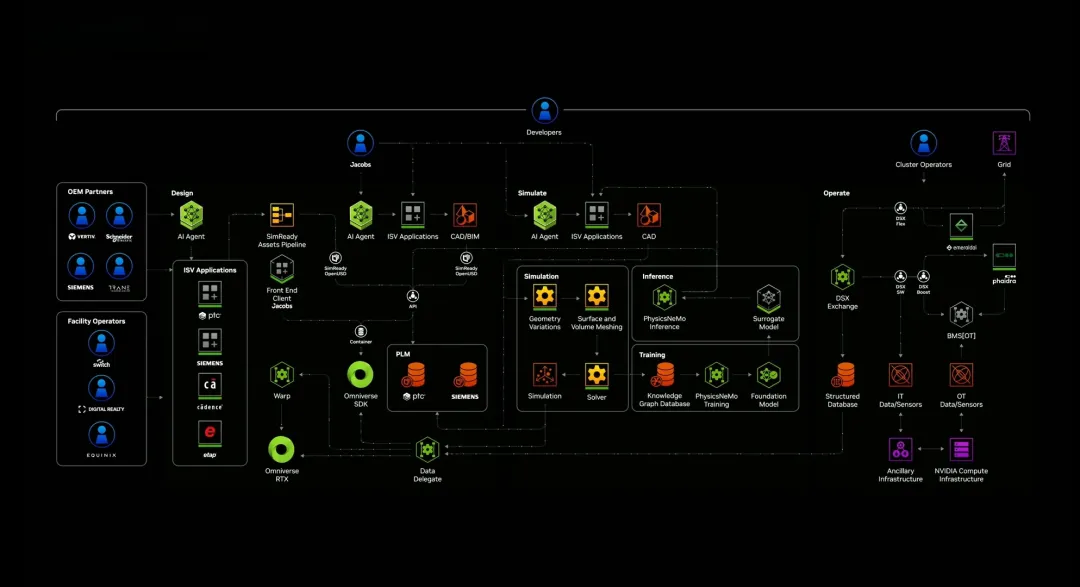
Cosmos堪称解决数据稀缺与长尾难题的终极答案。多年来,自动驾驶发展的一大瓶颈就是获取真实、多样且覆盖长尾场景的数据,这些数据获取成本高昂,且风险极大。Cosmos世界基础模型的推出,正是为了从根本上解决这一问题。当模型训练遇到数据瓶颈或需要极端场景时,开发者可以调用Cosmos世界模型来生成基于物理学的、可控的逼真合成数据,按需制造出暴雨、暴雪、极端拥堵甚至交通事故等罕见但关键的训练场景,而无需在真实世界中守株待兔,直接解决了长尾场景数据稀缺的难题。 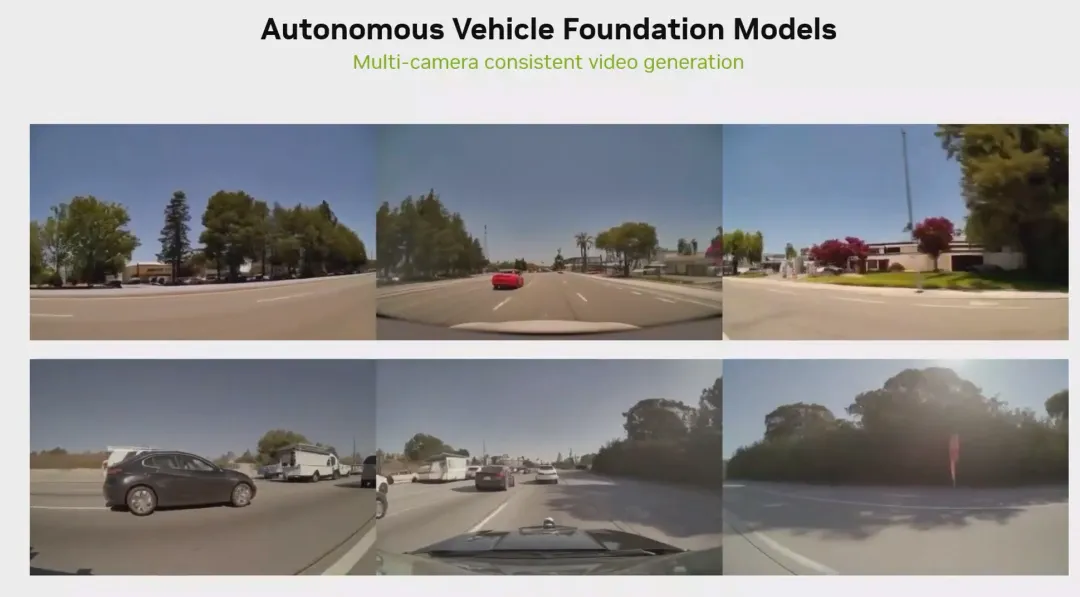
Omniverse被黄仁勋称为“构建和运营物理真实数字孪生的操作系统”,用于提供承载驾驶场景、进行高保真仿真和闭环测试的环境。它深度融合了英伟达在实时渲染、计算机视觉、物理仿真、运动模拟、传感器模拟等领域数十年的技术积累。在Omniverse中,开发者可以构建与真实世界无限接近的虚拟环境,让自动驾驶系统在其中进行安全、可重复的极限测试,在这个安全的平行世界里反复试验、不断学习。 一旦行业对Cosmos生成数据、在Omniverse中进行仿真测试的开发模式形成依赖,对英伟达GPU和超算系统的需求将迎来指数级增长。这就完美地将软件生态的繁荣转化成了硬件销售的持续动力。毕竟,无论是部署庞大的Cosmos模型,还是在Omniverse中进行实时高保真仿真,都离不开超强算力支撑。这才是英伟达的根基所在。 明修栈道,暗度陈仓。英伟达在CES 2026上的慷慨开源,表面看是通过数据集和VLA推理模型推动自动驾驶平权,其深层的目的和逻辑却是将整个自动驾驶乃至物理AI产业,更深地卷入其以Cosmos(合成数据生成)和Omniverse(数字孪生仿真)为核心、以超级算力为基座的宏大生态系统中。开源是鱼饵,打造生态才是藏在鱼饵里的那个“钩”! END
往期推荐 RECOMMEND 1 智能汽车如何引入 48V 电源系统? 2 五分钟,我用AI帮我写了一个基于STM32带磨损均衡功能的flash驱动 3 MCU 的进化史(上) 4 项目分享 | 100W快充 + USB3.0高速传输(3A1C),这个开源HUB项目太香了! 5 如何把 C 写出面向对象的效果? 

戳“阅读原文”了解更多!
开源数据集价值高吗?
开源模型作用大吗?
英伟达推销工具链的目的是什么?
写在最后
我们渴望挖掘深耕技术领域的原创力量,如果你有独到的技术见解、实战经验总结,或是干货满满的技术分享,欢迎向电堂投稿!如被录用,可以获得500元稿费,投稿邮箱:editor@51diantang.cn。
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:596563534@qq.com 。
