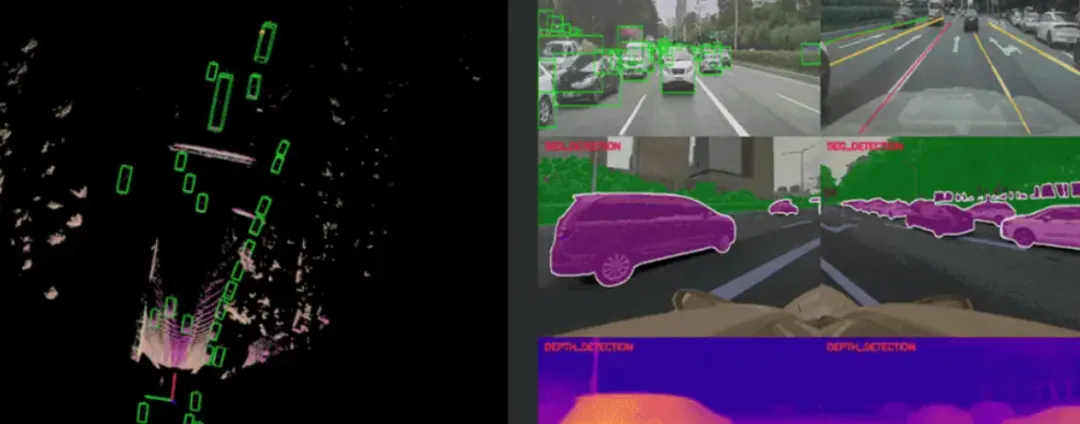
自动驾驶正经历一场从工程化到人类认知的过程。其核心驱动力在于,早期基于规则和有限数据训练的模型,在面对真实世界无限的“长尾场景”时,其泛化能力已达到瓶颈。本文将从技术架构的内在逻辑出发,深入剖析分阶段部署、BEV(鸟瞰图)感知、端到端控制及VLA(视觉-语言-动作)模型四大路线,揭示其技术原理、演进关系与未来挑战。
为便于直观理解技术路线间的关系,下表对比了各阶段的核心特征:
| | | | | |
|---|
| 分阶段部署 | 感知 → 预测 → 规划 → 控制(模块化流水线) | | | | |
| BEV感知 | | | Transformer、时序融合、Occupancy网络 | | |
| 端到端 (E2E) | | | | 行为拟人、优化全局性能、架构简洁(如特斯拉FSD V12) | “黑箱”决策难解释、数据/算力需求巨大、安全验证复杂 |
| VLA模型 | | | | 具备常识与推理能力、可解释性潜力、高泛化上限(如小鹏第二代VLA) | |
一、技术与工程实践:分阶段与BEV的统一感知
在追求更高阶的智能化之前,可靠且可解释的技术基础是产业化的前提。分阶段模块化架构和BEV统一感知共同构成了当前高级别辅助驾驶(L2+/L3)的技术基石。
分阶段架构(模块化)是传统自动驾驶的经典范式,它将驾驶任务分解为感知、预测、规划和控制四大独立模块。每个模块可单独优化,并使用确定性规则进行安全边界控制,这使得系统行为可预测、可调试,易于满足车规级安全要求。例如,宝马与Momenta合作开发的全场景领航辅助系统,便遵循了感知-规划-控制一体化思路,并通过海量仿真与实车测试进行验证。然而,该路径的瓶颈在于“信息衰减”与“误差累积”——各模块间通过固定接口传递有限信息,上游的微小误差可能导致下游决策的严重偏离,且系统整体缺乏面对未知场景的应变能力。
为解决感知层面的碎片化问题,BEV感知技术应运而生。其核心是将所有摄像头(及雷达)的数据,通过Transformer等神经网络,实时投影并融合到一个统一的、自上而下的鸟瞰图坐标系中。这好比为车辆构建了一个即时生成的、无需依赖高精地图的“上帝视角”局部地图。BEV不仅提供了车辆周围环境的静态布局(车道线、路沿),更关键的是,它统一了对动态物体(车辆、行人)的时空表征,使预测模块能获得更一致、更丰富的输入。目前,BEV+Transformer已成为行业主流感知方案,并为走向更彻底的端到端架构铺平了道路。
二、范式跃迁:从端到端控制到VLA认知革命
当感知足够强大,一个自然而然的设想是:能否绕过繁琐的中间表示和规则,让AI像人一样,看到画面就直接思考如何驾驶?这催生了两种存在深刻差异的技术哲学:纯粹的数据驱动与基于理解的认知驱动。
1. 端到端自动驾驶:数据驱动的“条件反射”端到端模型是数据驱动路径的终极体现。它用一个庞大的神经网络,直接将传感器(主要是摄像头)的原始视频流映射为方向盘、油门、刹车的控制信号。特斯拉的FSD V12是这一路线的标杆。其优势在于,通过海量人类驾驶视频进行训练,模型能学到极其拟人的驾驶风格和综合决策能力,理论上能处理无限复杂的场景。
但其核心缺陷是“黑箱”与“脆弱性”。模型像一个拥有高超驾驶肌肉记忆但无法解释原因的“天才”,其决策逻辑难以追溯和验证。更重要的是,它缺乏对物理世界的理解和常识推理能力。模型可以学会在遇到障碍物时刹车,但它可能并不“理解”前方的是一个纸箱还是一个混凝土墩,也无法根据“公交车停下”推理出“可能有行人窜出”这一潜在风险。这导致其在面对训练数据未充分覆盖的极端“长尾场景”时,可能做出难以预料的行为。
2. VLA模型:迈向具备“世界认知”的驾驶大脑VLA模型的提出,正是为了解决纯端到端模型在认知层面的根本缺陷。它不仅是技术架构的升级,更是一次范式转换:从“预测下一个控制信号”转向 “理解世界如何运转并预测其下一状态” 。
VLA模型的核心创新在于,在视觉(V)和动作(A)之间,引入了大语言模型(L)作为“认知中枢”。这个大语言模型并非用于聊天,而是因为其在互联网级图文数据上预训练后,已经内化了关于物理世界和社会常识的庞大知识库。技术流程可分解为:
小鹏汽车发布的第二代VLA模型是典型代表。它将第一代的“V→L→A”串行架构,革新为“(V+L)→A”的并行架构,即视觉信息和驾驶意图(可视为一种内部语言指令)同时输入,直接生成控制动作,减少了信息损耗。元戎启行的CEO周光指出,VLA模型依托语言模型的常识,能识别异形障碍物、理解临时路牌文字,并实现基于场景推理的防御性驾驶,这正是其超越传统端到端方案上限的关键。
三、前沿攻坚与未来挑战
VLA模型虽代表了前沿方向,但其落地仍面临严峻的技术与工程挑战,主要集中在三个方面:
算力与效率的极致挑战:VLA模型通常需要千TOPS级别(如2250 TOPS)的车端算力支持。这推动了新一代芯片(如NVIDIA Thor)的研发,并催生了如离散扩散模型(替代自回归,并行生成动作序列)、动作分词器(将连续动作高效编码为离散token)等旨在提升推理效率的算法创新。
多模态数据的匮乏与生成:高质量的驾驶数据,尤其是包含复杂推理过程的“思维链”数据,极为稀缺。这促使行业将目光投向合成数据。利用世界模型生成高度逼真、涵盖大量罕见场景的驾驶仿真数据,正成为突破数据瓶颈、降低训练成本的关键路径。
技术路线的收敛与融合:业界同时存在另一条技术路径——世界模型(World Model / World Action)。它主张跳过“语言”转译环节,直接建立从视觉到动作的映射,认为这能减少延迟和误差。以华为、蔚来为代表的企业正在探索此路线。目前,VLA与世界模型呈现竞争与融合并存的态势。长期来看,VLA作为理解与推理的“大脑”,与世界模型作为预测物理动态的“模拟器”,两者很可能深度融合,共同构成未来自动驾驶系统的核心。
与此同时,感知硬件也在同步进化,以支持更强大的认知模型。例如,AEye最新发布的、基于NVIDIA Thor平台的LiDAR系统,能够实现1公里以上的超远距高分辨率探测,为VLA模型提供了更早、更精确的感知输入,使其有更充裕的时间进行复杂推理。
结语
自动驾驶的技术演进,是一条从模块化分工到感知统一(BEV),再到决策统一(端到端),最终迈向认知统一(VLA)的清晰路径。当前的竞争焦点,已从单纯的感知精度或规控平滑度,转变为AI对物理世界的理解、推理与泛化能力。
纯粹的端到端方案模仿行为,而VLA模型追求理解意图。未来的自动驾驶系统,将不仅是一个强大的“驾驶员”,更是一个具备常识、能进行因果推理、并能解释自身决策的“交通参与者”。尽管在算力、数据和工程化上仍面临高山,但融合VLA认知与世界模型预测的技术方向,正为完全自动驾驶的实现,勾勒出一条从“大数据”走向“大智慧”的可靠技术路径。