AWDYOLO:提升恶劣天气下自动驾驶感知的可靠性
- 2026-11-09 08:20:12
点击蓝字
关注我们
关注并星标
从此不迷路

公众号ID|计算机视觉研究院
学习群|扫码在主页获取加入方式
计算机视觉研究院专栏
Column of Computer Vision Institute
PART/1
概述
PART/2
背景
近年来,基于深度学习的计算机视觉技术为自动驾驶感知系统的研发做出了重要贡献。然而,雾、雪、雨等恶劣天气会造成图像细节丢失、纹理特征改变、远处目标消失,进而降低传感器性能,增加系统的风险与复杂度。
因此,在复杂多变的天气条件下高效检测行人、车辆等交通目标,对自动驾驶及高级驾驶辅助系统(ADAS)的感知与决策过程至关重要。尽管研究者已大量致力于提升恶劣天气下交通目标检测的精度与速度,但该领域仍存在诸多显著挑战。
恶劣天气下的小目标检测相比晴朗天气下的常规目标检测具有固有难点。受尺度限制,小目标在深度神经网络的反复卷积与池化过程中会出现严重的特征衰减,甚至判别信息完全丢失。尤其在雾天、雨天环境中,天气相关信息与目标相互作用导致图像质量下降,使得小目标检测区域内的细节纹理信息不足。目标像素面积的减小会进一步加剧小目标细节提取的困难,从而显著降低检测算法的效果。
传统目标检测方法难以快速、准确地检测低质量目标,而图像增强、复原与去雾技术能够提升目标视觉质量,增强检测算法的有效性。面向天气的图像增强可恢复模糊目标的细节信息,提取被误检目标的潜在特征,从而提升模型在恶劣天气场景下的鲁棒性。
现代目标检测算法分为单阶段检测器(如YOLO系列、SSD、RetinaNet)和两阶段检测器(如RCNN系列),后者精度更高,但通常会牺牲训练效率与推理速度。具有强大特征学习能力的深度学习方法能够有效融合多尺度特征,捕获丰富的语义信息与上下文依赖。然而,基础深度学习模型在精确检测类似背景的小目标时仍面临困难。
恶劣天气及相关因素(如雾)对目标检测精度与速度的显著影响,加之周围环境的复杂性,使得实现鲁棒、可靠的自动驾驶感知极具挑战。因此,研究能够在多种恶劣天气下保持精确与鲁棒性能的多尺度目标检测算法变得愈发重要。
本研究主要贡献如下:
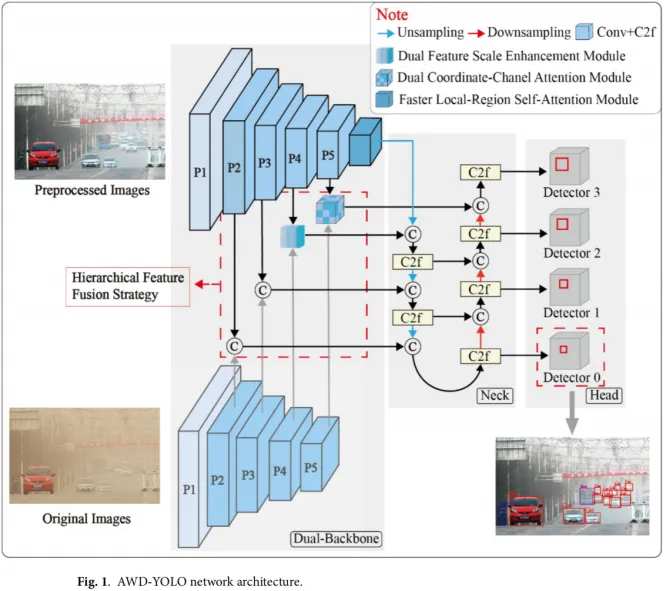
(2)本研究提出一种分层特征融合策略,以有效融合双骨干特征。该策略将融合过程划分为浅层融合与深层融合。浅层融合采用特征拼接方式,以保留来自两个骨干网络的高分辨率空间信息。在深层网络中,引入双特征尺度增强(DFSE)模块与双坐标通道注意力(DCA)模块以获取丰富的语义信息。DFSE通过跨尺度交互增强特征判别性,而DCA则在空间与通道维度施加协同注意力,使模型能够动态聚焦于信息量最大的特征图。通过利用双骨干架构的互补特征,该策略显著提升了检测鲁棒性。
PART/3
新算法框架解析
针对恶劣天气下目标检测的挑战,本研究提出一种基于YOLOv8n的新型AWD-YOLO网络。其架构由双骨干(Dual-Backbone)、颈部(Neck)和检测头(Head)三部分组成,如图1所示。
双骨干采用双分支结构:以预处理增强图像作为主分支输入,原始图像作为辅助分支输入。该结构旨在利用增强图像减轻恶劣天气带来的噪声干扰,并通过原始图像补偿图像处理流程中丢失的细节信息。通过信息提取的相互强化,两个分支使模型即便在恶劣天气下也能实现精准的目标检测与分类。
此外,考虑到浅层与深层网络特征的差异,本研究提出一种分层融合策略以整合不同网络层级的特征,进一步增强模型的特征提取能力,从而实现鲁棒的多尺度目标检测。颈部保留了YOLOv8的原始结构。在检测头部分为浅层特征增设小目标检测头,为模型提供更丰富的细节信息,尤其适用于道路上的远距离小目标。
分层特征融合策略
在双分支YOLO架构中,本研究开发了一种新型分层融合策略,专门用于实现鲁棒的多尺度目标检测。该策略基于浅层与深层特征的互补特性,采用差异化融合机制,以充分利用预处理输入的增强特征与原始输入的细节特征。
特征的语义与空间特性随网络深度而变化,这反映了不同层级特征图分辨率与语义内容的变化。然而,单一融合策略无法同时适配目标随尺度变化的特性。为解决这些局限,本研究引入一种依赖尺度的分层融合策略。该策略结合双分支结构、改进的特征利用方法与注意力机制,充分挖掘预处理输入与原始输入中的目标特征信息,实现双特征的有效融合与增强。
-在P2与P3层通过拼接实现轻量化融合,以保留小目标的高分辨率空间细节。
-在P4层采用设计的双特征尺度增强(DFSE)模块,增强目标特征并平衡语义与空间信息,充分利用其中等语义含量与部分全局上下文信息。
-在P5层(语义信息丰富但空间分辨率较低)应用设计的双坐标通道注意力(DCA)模块进行特征融合,以强化语义与全局上下文。
双特征尺度增强(DFSE)
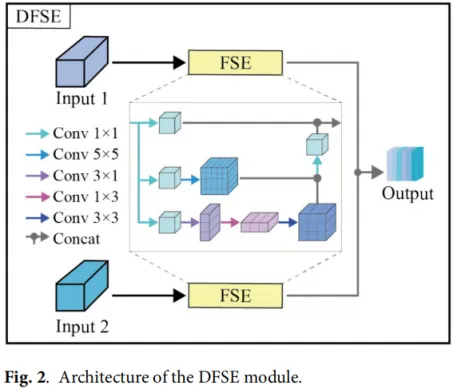
每个分支首先通过1×1卷积调整通道数:
-分支1引入残差结构,建立恒等映射以保留初始特征中的关键低频信息。
-分支2采用5×5标准卷积,实现局部-全局特征的密集采样。
-分支3混合多尺度卷积核(3×1、1×3、3×3),通过水平-垂直可分离卷积提升边缘敏感度,并通过空洞卷积实现稀疏采样以保留上下文信息。
双坐标通道注意力模块(DCA)
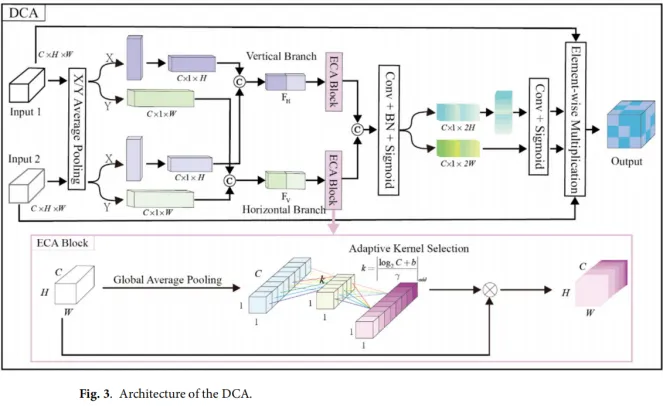
该模块融合多维空间信息,采用高效通道注意力(ECA)进行通道特征优化,并自适应调整注意力权重,以凸显不同主骨干网络的优势。具体流程如下:
快速局部区域自注意力(FLRSA)
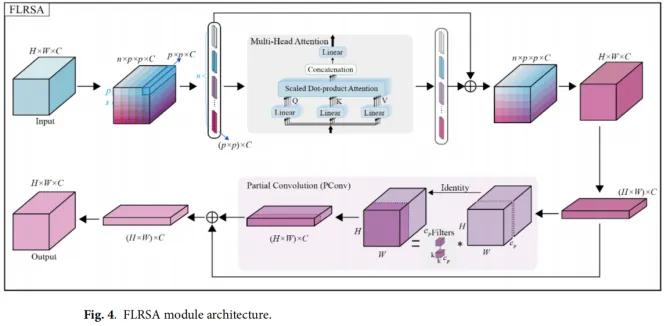
该模块采用基于重叠块的特征图分解技术,在平衡注意力机制计算可行性的同时,保留了块间空间连贯性。通过计算块内成对注意力,这种局部操作能有效捕获长程依赖关系,从而模拟全局感受野。FLRSA将重叠块与多头自注意力相结合以增强特征交互,使网络能在不同位置和尺度上分配不同权重,进而实现更优的全局与局部特征捕获,并加深对目标与环境间关系的理解。
Wise-IoU
YOLOv8n默认使用CIoU作为边界框回归(BBR)损失,兼顾了预测框与真实框之间的形状和位置差异。然而,仅考虑长宽比差异会导致惩罚项精度不足。因此,研究者相继提出SIoU、EIoU、Focal‑EIoU及MPDIoU等损失函数,以获得更有效的梯度信号与精准的目标定位。
这类研究大多基于检测目标为高质量样本的前提,专注于提升边界框回归的拟合能力。但恶劣天气场景下的数据不可避免地包含低质量样本,此时距离、长宽比、角度等几何因素会对低质量样本产生过度惩罚。基于低质量样本强化边界框回归会显著降低模型的定位能力。
PART/4
新算法框架解析
数据预处理
恶劣天气条件(雾、雨、雪、沙尘)通过直接物理机制显著降低相机采集清晰世界图像的性能。雾天条件下,有限的大气能见度会降低图像清晰度并造成特定遮挡。雨/雪天会导致图像畸变、模糊或遮挡。沙尘天则因高密度空气悬浮颗粒,造成颗粒遮挡和色度畸变。
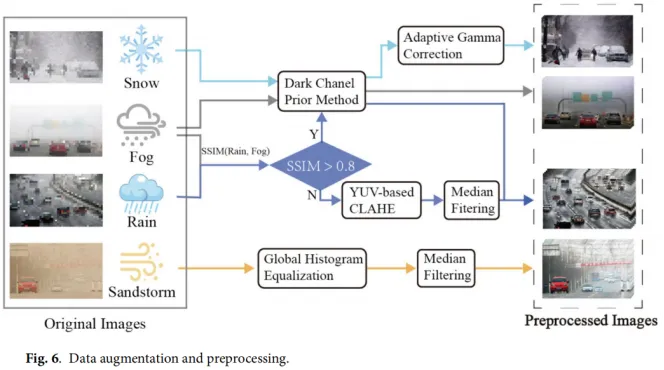
预处理过程根据不同天气类型分别实现,如图6所示。针对雾天和雪天,采用暗通道先验算法进行去雾;针对雪天,引入基于平均图像亮度的自适应伽马校正策略,以增强低对比度区域的细节。对于雨天,通过结构相似性指数(SSIM)确定图像质量,SSIM>0.8的类雨图像采用去雾方法处理。
基于DAWN的预处理消融实验
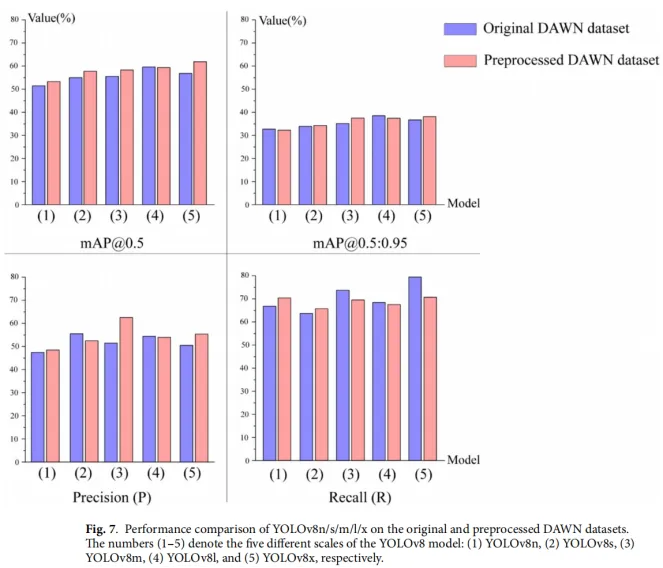
如图7所示,仅使用预处理图像进行训练相比使用未处理图像,能将大多数模型的mAP@0.5提升0.4至3.3个百分点。这证实了本研究的预处理方法能有效提升图像质量,并增强检测性能。然而,某些预处理技术可能导致原始图像特征丢失,这表明单纯依赖原始图像或预处理图像均非最优。
测试结果可视化
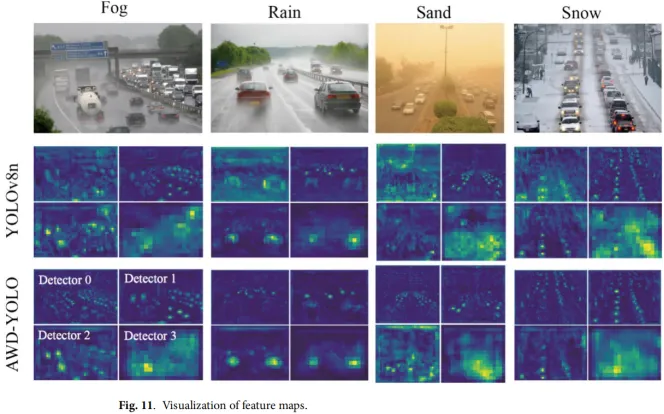
如图11所示,该对比完整呈现了从原始输入到中间层特征,再到最终检测结果的可视化链条。特征图颜色代表激活强度,黄色表示最强激活,更强激活意味着对模型决策更重要的特征。与基线相比,AWD-YOLO的特征图展现出更清晰的层级化特征表示与激活区域。这表明双骨干网络的分层融合策略在恶劣天气下有效缓解了噪声干扰,同时保留了丰富细节,增强了小目标检测能力。从特征图可见,检测头0和检测头1主要负责检测小目标:新检测头0的特征激活区域集中且边界清晰,维持了高分辨率与丰富细节特征,体现了其在小目标定位上的精度;检测头2和检测头3则更关注中大型目标。相比之下,基线模型的激活分布较为分散,表明其难以抑制噪声、对重要特征关注不足,易导致误检或漏检。
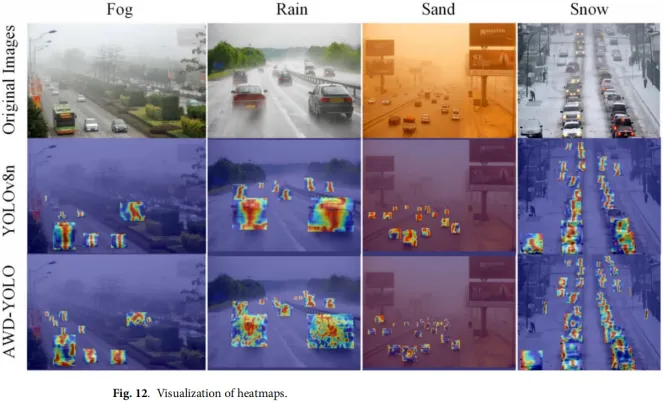
图12展示了不同模型检测头前集成C2f层的热力图,以评估恶劣天气下道路目标检测任务的性能差异。YOLOv8n的热力图显示,其在车辆检测时更关注大目标,对小目标重视不足,这表明尽管YOLOv8n能在检测时同步整合全局与局部信息,但其在雨、雾、沙尘等恶劣天气下对小目标及被遮挡目标的检测率仍稍显不足。相比之下,AWD-YOLO在各类恶劣天气下对小目标区域的关注度均有所提升,这种注意力增强使AWD-YOLO能更准确地识别与定位不同尺度的目标,尤其是小型车辆与行人,从而提升模型整体检测性能。
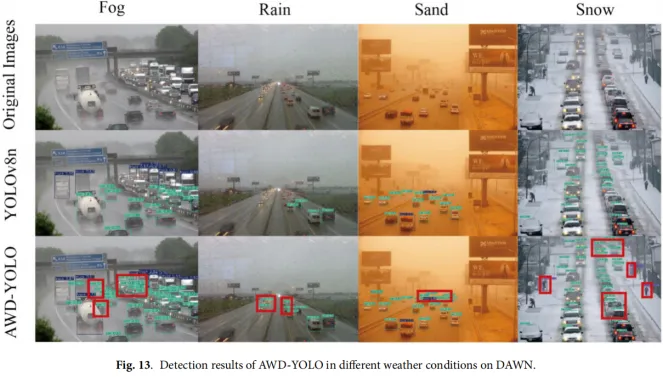
图13对比了AWD-YOLO与基线YOLOv8n的检测结果,用红色框标注了AWD-YOLO显著优于YOLOv8n的区域。结果表明,AWD-YOLO检测率更高,尤其在远距离小目标检测方面表现突出。相反,基线模型在多个场景中存在大量漏检:第二列雨天场景下,左车道所有车辆均未被检测到;第一列雾天场景下,还出现了将卡车误检为汽车等误检情况。尽管面临这些挑战性天气条件,AWD-YOLO仍保持了较高的检测精度与稳定性。
失败案例分析
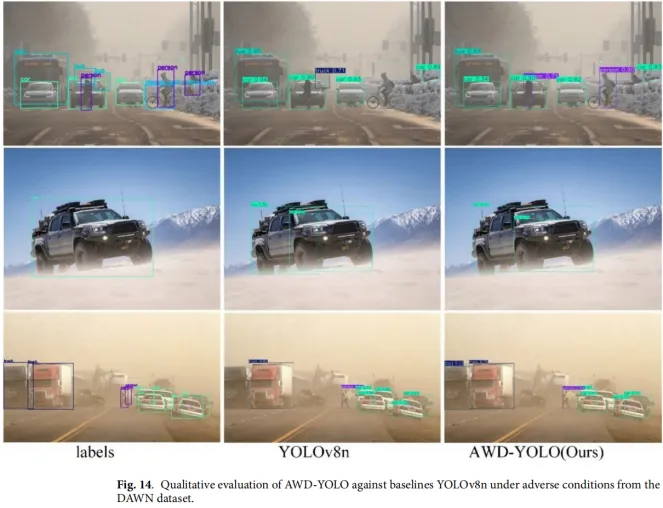
图14展示了AWD-YOLO与真实标签、基线YOLOv8n的失败案例对比。AWD-YOLO存在重复检测与漏检目标的情况,表明模型在极端遮挡或极小尺度目标场景中仍面临挑战,这也是未来改进的关键方向。但与基线模型相比,AWD-YOLO的一大显著优势是能有效抑制误检(如首行所示)。我们认为YOLOv8n的误检源于其单骨干结构对低质量图像的脆弱性,易导致对背景噪声的误判;而AWD-YOLO的双骨干架构通过融合增强特征与真实背景纹理,有效缓解了这一问题。
END
转载请联系本公众号获得授权

计算机视觉研究院学习群等你加入!
ABOUT
计算机视觉研究院
🔗
YOLO-TLA:一种基于 YOLOv5 的高效轻量级小目标检测模型 ViT-YOLO:基于Transformer的用于目标检测的YOLO算法 SSMA-YOLO:一种轻量级的 YOLO 模型,具备增强的特征提取与融合能力,适用于无人机航拍的船舶图像检测 LUD-YOLO:一种用于无人机的新型轻量级目标检测网络 Gold-YOLO:基于聚合与分配机制的高效目标检测器 Drone-YOLO:一种有效的无人机图像目标检测 「无人机+AI」“空中城管” 无人机+AI:光伏巡检自动化解决方案 无人机视角下多类别船舶检测及数量统计 机场项目:解决飞行物空间大小/纵横比、速度、遮挡等问题引起的实时目标检测问题 2PCNet:昼夜无监督域自适应目标检测(附原代码) YOLO-S:小目标检测的轻量级、精确的类YOLO网络 大改Yolo框架 | 能源消耗极低的目标检测新框架(附论文下载) 改进的检测算法:用于高分辨率光学遥感图像目标检测
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- 全新一代896线激光雷达旗舰SUV,岚图泰山黑武士版上市
- 宝马7系SUV:终极豪华7座家庭版,一次把外观、内饰、空间看清楚
- 特斯拉“自动驾驶核心”承压:FSD调查升级,召回风险上升!
- 转 | 赋能自动驾驶和机器人感知,读懂二维可寻址VCSEL
- 传祺GS3影速定位高性价比小型SUV,搭载1.5T
- 落地30万内纯电SUV横评|续航、充电、智驾一次说透
- 小米YU7真实测评:25万级纯电SUV,到底值不值得买?
- 特斯拉面临关于自动驾驶模式下的车辆如何应对恶劣路况的新质疑 Tesla faces new questions about how cars in self-driving mode handle
- 4月大型SUV"三国杀"!大众、零跑、凯迪拉克谁能笑到最后?
- 103,就是这台红极一时的四驱插混SUV在2月的销量