导读
1.智能驾驶⊃ 自动驾驶,前者是全车智能体系,后者仅专注行车操控;
2.家用车主流为L2/L2 + 辅助驾驶,L3 及以上才是真正自动驾驶;
3.L2+~L4 高阶智驾,技术架构与机器人VLA模型高度同源,也是当前行业核心方向。
智能驾驶≠ 自动驾驶,自动驾驶是智能驾驶的一个子集。结合行业标准与前沿技术具身VLA,帮助大家区分理解清楚。
一、概念区分
1. 智能驾驶
整套整车智能化体系。不只是“自动开车”,而是覆盖车辆感知、人机交互、车联网、辅助驾驶、车身控制、影音娱乐、安全防护等全车智能功能。简单理解:让整台车变得更“聪明”。
2. 自动驾驶
聚焦单一核心能力:车辆自主完成驾驶操作。仅负责转向、加速、制动、跟车、避障等行驶操控,功能边界非常明确。
二、智能驾驶包含内容
驾驶类:全等级自动驾驶、各类驾驶辅助功能;
感知类:摄像头、雷达、全车传感器、内外环境监测;
交互类:语音控制、智能车机、人机界面、AR-HUD;
网联类:车联网 V2X、远程控制、OTA 升级、智能导航;
车身智能:自动泊车、智能灯光、智能空调、自适应座椅等。
三、自动驾驶分级(依据国标GB/T 40429)
国内现行标准将自动驾驶划分为L0 至 L5 六个等级,能力逐级跃升:
L0传统驾驶:全程由人类操控车辆,系统仅提供倒车雷达、声光预警等基础提醒,不介入行车控制。
L1辅助驾驶:提供单一驾驶辅助功能,如定速巡航、基础车道保持,驾驶员始终掌握车辆主导权。
L2组合辅助驾驶:可同步管控车速与行驶方向,实现全速域自适应巡航、车道居中。即便系统参与操控,驾驶员也必须全程留意路况、随时接管。
L3有条件自动驾驶:在高速、封闭道路等特定场景下,车辆可独立完成行驶;若系统发出接管提醒,驾驶员需及时接手操控。
L4高度自动驾驶:在划定区域与场景内实现完全自主行驶,常规工况无需人为干预,即便遭遇极端状况,系统也可自行应对。
L5完全自动驾驶:适配全路况、全场景、全天候环境,真正实现无人行车,综合能力比肩人类驾驶员。
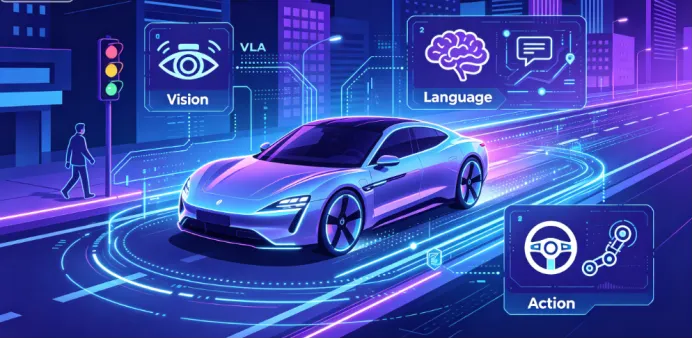
四、前沿技术:读懂VLA 视觉-语言-动作模型
VLA(Vision-Language-Action,视觉-语言-动作模型),是当下具身智能、人形机器人的核心算法范式。
这套模型打通了“感知、思考、行动” 的完整链路,用统一框架实现三大核心能力:
1.视觉(Vision)——观察世界依托摄像头、激光雷达捕捉画面、点云,完成环境信息采集。
2.语言(Language)—— 思考理解借助大模型解析场景、识别指令、解读规则与常识,完成逻辑推理。
3.动作(Action)—— 执行反馈直接输出控制指令,驱动机械臂、移动底盘,或是车辆的转向、油门与刹车。
五、VLA 与自动驾驶:技术同源,互通共生
不同等级的自动驾驶,与 VLA 技术的适配度也截然不同:
1. L0 / L1 级别:技术基本无互通
这两类以人工驾驶为主,依赖传统规则逻辑搭建,系统模块分散,没有统一的智能决策中枢,和VLA的技术路线相去甚远。
2. L2+ / L3 / L4 级别:高度同源,行业主流方向
各头部车企打造的高速NOA、城市NOA,均在向VLA+ 世界模型的架构演进。
输入端:摄像头、雷达采集环境数据,逻辑与机器人完全一致;
认知端:依靠大模型解读路况、交规与行驶意图,对应 VLA 的语言理解能力;
输出端:下发转向、车速、制动等控制指令,对应 VLA 的动作执行能力。
二者架构完美呼应:
机器人:图像信息+ 语言指令 → 机械臂 / 底盘动作
高阶智驾:图像信息+ 导航 / 交通规则 → 车辆行驶控制
3. L5 完全自动驾驶:理论全域通用,尚未规模化落地
全场景无人驾驶,和人形机器人本质是同一类技术命题:在复杂动态环境中,实现安全、自主移动与交互。你日常用车在用哪一级辅助驾驶?你看好VLA技术在智能驾驶上的落地吗?
欢迎留言交流~
 10个月宝宝每天需要喝多少奶粉?