端到端自动驾驶的“人类考官”来了!用750万条轨迹训练,让AI开车不再“非人哉”
- 2026-10-11 19:10:12
你的自动驾驶系统,真的开得“像人”吗?当它为了“绝对安全”龟速行驶、让乘客晕车、让后车狂按喇叭时,开发者如何证明这“就是最优解”?今天,一个颠覆性的“驾驶员基础模型”框架,正试图用750万条真实人类驾驶轨迹,为所有AI司机设立一个“人类行为基准考场”。
想象一下:你坐在一辆号称L4级的自动驾驶汽车里。前方路口黄灯闪烁,人类司机会选择一脚油门平稳通过,而你的车却突然急刹,让你和后面的车都措手不及。安全吗?或许。像人吗?绝不。
这正是当前自动驾驶技术面临的“非人化”困境。我们过度聚焦于“零事故”的绝对安全,却忽略了驾驶本质上是一种社会性行为。你的车开得安不安全、舒不舒服、效率高不高,最终都要由人类乘客和周围的人类司机来评判。
但问题来了:“像人一样开车”这个标准,到底该怎么量化? 是靠工程师的“感觉”,还是靠几条简单的规则?
今天,一项开创性的研究提出了一个名为 “驾驶员基础模型” 的全新框架。它不再依赖主观规则,而是直接从750万条真实人类驾驶轨迹的大数据中,学习并定义什么才是“合格”的人类驾驶行为。它要做的,就是成为所有自动驾驶系统的“人类考官”。
读完本文,你将彻底理解:
1. 为什么现有安全基准(如CCDM)在复杂场景下会“失灵”? 2. 这个“驾驶员基础模型”如何通过回答“5W”问题,全面评估自动驾驶? 3. 它如何将“舒适度”、“通行效率”这些模糊感受,变成可量化、可优化的工程指标?
❓ 核心痛点:为什么自动驾驶总被吐槽“开得不像人”?
当前自动驾驶的测试与评估,正陷入一个**“规则困境”**。
主流的基准模型,如“谨慎且称职的驾驶员模型”,本质上是基于规则的。它们为安全行为设定了一些硬性条件,比如“必须保持3秒跟车距离”。这些规则在简单、理想的场景下(1-3辆车)或许有效。
但现实交通是高度复杂、动态且充满不确定性的多智能体博弈。一个十字路口可能同时有十几辆车、行人和非机动车交互。这时,僵化的规则就会暴露其局限性:
• 规则冲突:既要保持安全距离,又要高效通过路口,规则之间可能打架。 • 无法泛化:在高速匝道、环岛、恶劣天气等运行设计域边界场景下,基于简单规则的行为往往失真,要么过于保守成为“路障”,要么产生不可预测的风险。 • 忽略体验:规则只关心“是否撞上”,却不管“乘坐是否眩晕”、“通行是否拖沓”、“能耗是否过高”。而这恰恰是用户接受度的关键。
更致命的是,这些规则缺乏一个坚实的“人性化”锚点。 我们无法回答:在黄灯亮起的0.5秒内,90%的人类司机会怎么做?他们的减速度分布是怎样的?这种决策又主要依据了环境的哪些信息?
没有这个锚点,自动驾驶的优化就像在黑暗中摸索。你只知道“不能撞”,却不知道怎样开才“既安全又得体”。
那么,能否建立一个直接从海量人类驾驶数据中“学习”出来的、能全面反映人类驾驶能力的基准模型呢? 这个模型不仅要告诉我们人类“如何”开,还要解释“为什么”这么开,从而为AI司机提供一个全方位的“人类行为参考系”。
🧠 基石:如何获取“上帝视角”的纯净驾驶数据?
构建一个可信的人类驾驶基准,第一步是数据。数据的质量决定了模型的上限。
传统自动驾驶数据集(如Waymo)存在一个根本性视角缺陷:自车视角。车顶的传感器会被前车、建筑物遮挡,无法获得全局的交通动态。这就像只通过司机的眼睛看世界,看不到隔壁车道后方的来车,也看不清百米外路口的整体车流态势。
本文的研究团队选择了一条颠覆性的技术路线:无人机航拍。
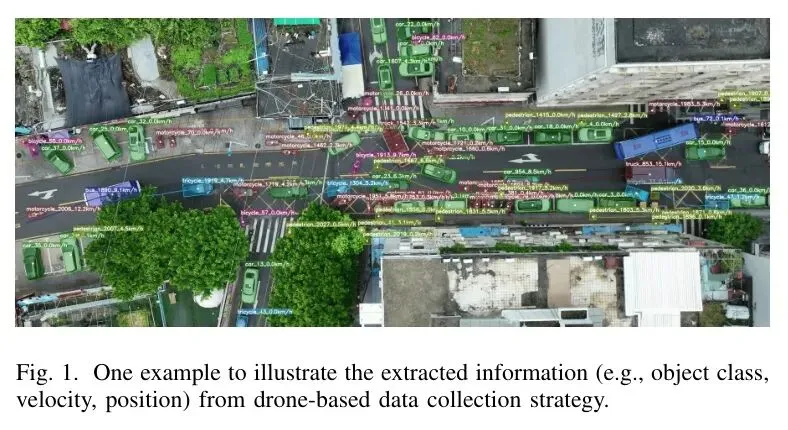
无人机在目标路段上空悬停,录制视频,再通过“视频校正→目标检测→目标跟踪→数据平滑”这一套流程,最终得到该区域内所有车辆、行人等道路使用者的精确时空轨迹(位置、速度、航向角)。
这个“上帝视角”带来了三大无可比拟的优势:
1. 无遮挡全局观:能连续、精确地观察多智能体之间的长时程交互,这是理解复杂决策的基础。 2. 消除传感器偏差:不受特定车辆传感器配置的影响,数据更客观。 3. 捕捉真实多样性:能记录下目标区域内所有驾驶员的行为,包括那些“激进”或“异常”但真实存在的操作,从而保留人类在安全与效率之间的自然权衡。
截至论文撰写,该数据集已包含超过750万条轨迹,据称是全球最大的航测数据集。更重要的是,它的场景覆盖极其全面。
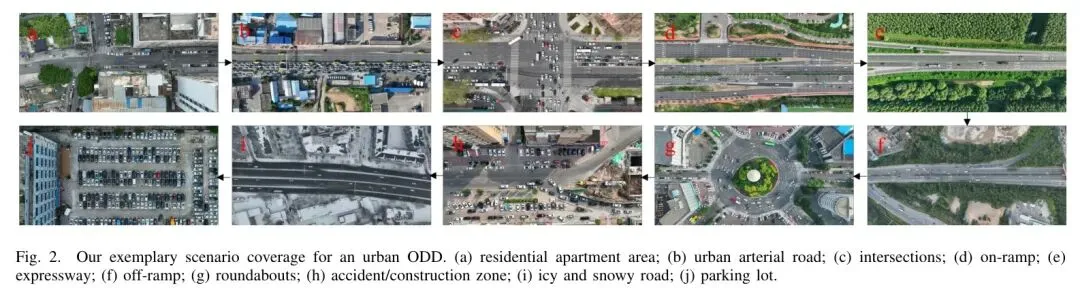
如上图所示,一次完整的端到端行程可能包含:从居民区出发、城市道路行驶、通过十字路口、高速匝道汇入、高速巡航、驶出高速、通过环岛,甚至可能遭遇事故或恶劣天气。这种丰富的场景覆盖,为在不同运行设计域下评估自动驾驶提供了坚实的数据基础。
💡 实战思考:用无人机数据做基准,是不是成本太高?其实,一旦标准建立,其带来的测试效率提升和风险降低,远高于数据采集的初期投入。这正是一种“为质量付费”的前瞻性思维。
有了高质量的数据,下一步就是设计一个能充分挖掘其中“人类驾驶智慧”的模型架构。
🚀 核心架构:一个能回答“5W”问题的多模态模型
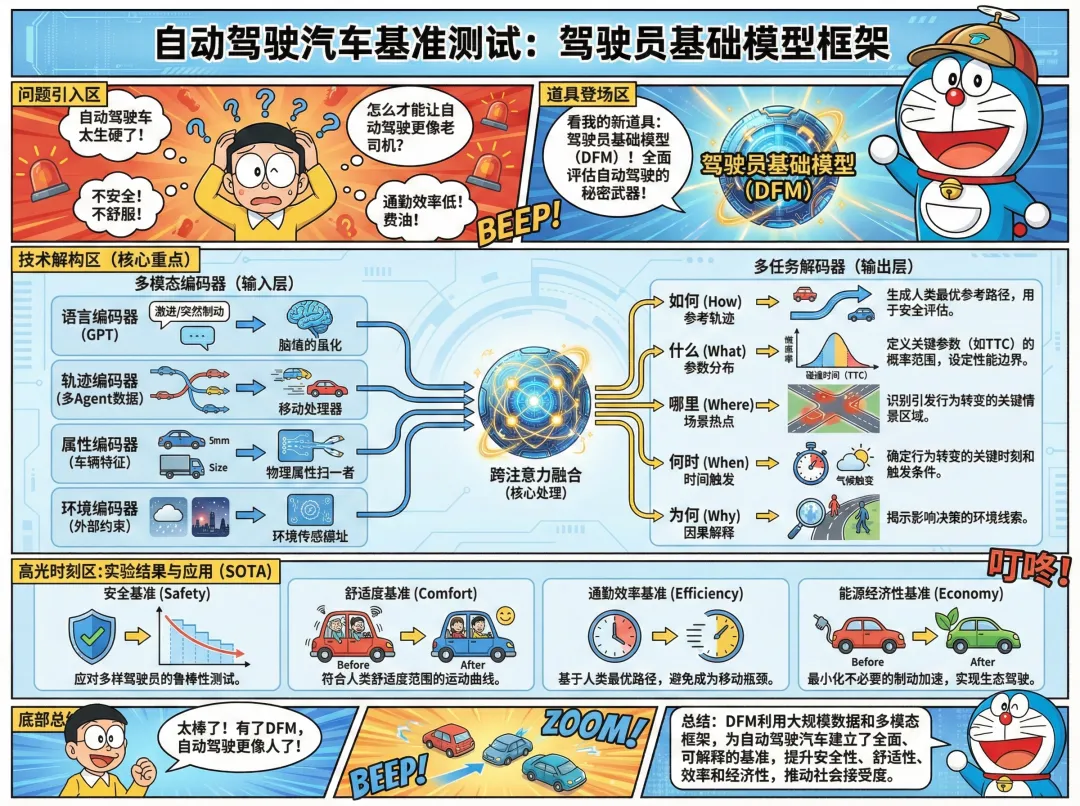
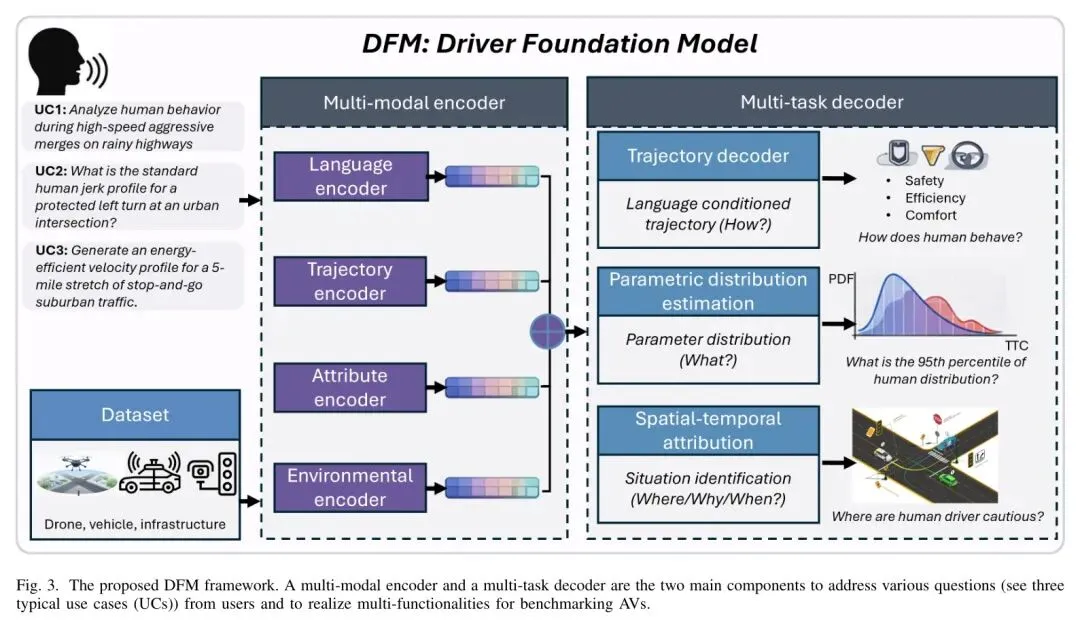
驾驶员基础模型的核心使命,是将原始轨迹数据,转化为对自动驾驶开发具有直接指导意义的“可行动知识”。论文用一个非常巧妙的框架来概括这一使命:回答关于人类驾驶行为的“5W”问题。
💡 多模态编码器:理解驾驶的“上下文”
要回答复杂的“5W”,模型必须能理解驾驶场景的方方面面。因此,DFM设计了一个四编码器架构,分别处理不同模态的信息:
1. 语言编码器:基于大语言模型(如GPT),将人类查询(如“在湿滑路面平稳制动”)编码成语义向量。这让模型能理解人类语言的细微差别。 2. 轨迹编码器:处理多个智能体的运动学数据(位置、速度),生成结构化的运动嵌入。 3. 属性编码器:关注智能体的物理属性(车辆类型、尺寸)。这让模型知道,大卡车的“平稳停车”所需距离远大于小轿车。 4. 环境编码器:捕捉天气、光照等外部约束。确保模型能根据环境调整预期(例如,雪天夜间应降低速度期望)。
这些编码后的信息如何融合?论文提出了两种策略:跨注意力机制或共享潜在空间。跨注意力允许语言查询动态地关注相关的轨迹或环境特征;共享潜在空间则将所有信息投影到一个统一的空间中进行交互。这确保了最终的场景理解是语义 grounded 且物理合理的。
💡 多任务解码器:产出可执行的“答案”
融合后的丰富表征,被送入一个并行多任务解码器,每个“任务头”专门负责回答一个“W”问题:
• How(轨迹解码器):根据查询条件,生成一条“人类最优”的参考轨迹。这是评估自动驾驶决策的生成核心。例如,给定“在拥堵匝道汇入”,它会产生一条既安全又流畅的路径。 • What(参数分布头):不单给出一个值,而是输出关键参数(速度、加速度、加加速度)的概率分布。这定义了“合格人类行为”的数学边界。开发者可以据此判断,自己的自动驾驶车在某场景下的表现是处于人类分布的第5百分位(过于保守) 还是第95百分位(过于激进)。 • Where/When/Why(时空归因模块):这是一个可解释性模块。它能反向投影注意力权重,指出: • Where:场景中的“热点区域”在哪里?(例如,汇流区的冲突点) • When:行为发生转变的关键时刻是什么?(例如,前车刹车灯亮起的瞬间) • Why:是哪些具体的环境线索导致了决策?(例如,是因为感知到了远处行人的预备动作)
这个“5W”框架的精妙之处在于,它把驾驶行为从黑箱变成了白箱。 不仅告诉自动驾驶“应该怎么做”,还告诉了它“为什么这么做”,以及“做得好不好”的量化标准。
🤔 互动时间:你认为“Why”(可解释性)这个输出,对自动驾驶开发来说是最重要的吗?还是“How”(参考轨迹)的实用价值更大?欢迎在评论区分享你的观点!
📊 四大应用:从安全到能效,全面重塑AV评估
有了这样一位“人类考官”,自动驾驶的评估将发生根本性变革。论文从四个维度阐述了DFM的颠覆性应用。
🏆 安全基准:从“规则测试”到“压力测试”
传统安全测试像是在考“交规”。而DFM能进行多智能体、多风格的“压力测试”。
• 生成多样化周围车辆:DFM可以模拟生成“激进型”、“谨慎型”等不同风格的周围驾驶员行为,测试自动驾驶系统在面对各类“奇葩”司机时的鲁棒性。 • 定义正式规范:通过提取人类行为的参数分布,可以数学化地定义安全边界。例如,“在干燥路面,与前车的车头时距(TTC)应大于人类驾驶员第5百分位的值”。 • 精准定位缺陷:当自动驾驶车在某场景表现异常时,时空归因模块能直接指出:“你的系统在这里出了问题,是因为忽略了右侧汇入车辆的加速趋势”,从而实现靶向升级。
🏆 舒适度基准:从“主观感受”到“量化指标”
“这车开得我头晕!”——如何避免这种差评?DFM让舒适度可测量。
通过参数分布头,DFM可以从人类数据中提取特定场景下的纵向加加速度和横向加速度的典型范围。工程师可以据此调整自动驾驶的控制算法,确保其加速、减速、转弯的“柔顺度”落在人类感到舒适的统计区间内。舒适度从此不再是玄学,而是一个可以写入需求文档、并在测试中验证的KPI。
🏆 通行效率基准:告别“移动路障”
只为安全优化的自动驾驶,容易变成龟速行驶的“路障”,引发交通拥堵和后方车辆的不满。
DFM的多任务解码器可以回答:“在密集车流中,人类如何高效到达目的地?” 它可以输出不同交通密度下,通过某个路口或路段的“标准人类通行时间分布”。开发者可以此为准,优化自动驾驶的决策规划,确保其通行效率不低于人类驾驶员的中位数水平,从而融入交通流,而非阻碍它。
🏆 能源经济性基准:为卡车队省下真金白银
对于商用车队,能耗就是生命线。DFM可以Query:“如何实现最佳动量守恒?”
模型能够识别人类专家驾驶员如何利用道路坡度和交通流节奏来保持动能,减少不必要的制动-加速循环。对于重型卡车,DFM可以输出最优的加速/减速速率分布。通过将自动驾驶卡车的能耗与这个“人类老司机”基准对比,可以精准优化动力系统控制策略,最大化续航,直接降低运营成本。
⚖️ 客观评价:前景光明,道路且长
毫无疑问,驾驶员基础模型的构想极具前瞻性和颠覆性。它试图从根本上解决自动驾驶评估中“人类对齐”的核心难题。然而,通向现实应用的道路上仍有挑战:
• 数据规模与质量的持续挑战:750万条轨迹是巨大的起点,但要覆盖全球所有地区、所有文化背景的驾驶习惯,数据量仍需指数级增长。数据标注和处理的成本也不容小觑。 • 模型泛化与校准的难题:如何确保模型在未见过的极端场景(Corner Cases)下,给出的基准仍然是合理且安全的?模型的输出本身也需要严格的验证和校准。 • 工程化与落地集成:将这样一个复杂的模型框架集成到现有的自动驾驶开发、测试工具链中,需要大量的工程工作和技术标准制定。
但无论如何,DFM指出了一个明确的方向:自动驾驶的终极目标不是超越人类,而是理解并融入人类。 它为我们提供了一套将人类驾驶的“社会智能”翻译成机器可理解、可优化语言的方法论。
🌟 总结与行动号召
总结来说,这篇论文提出的驾驶员基础模型框架,为我们带来了三个核心启示:
1. 评估范式的转变:从基于规则的、单点安全的评估,转向基于数据的、全面(安全、舒适、效率、经济)的、以人类为锚点的评估。 2. 数据价值的重估:“上帝视角”的全局轨迹数据,是解锁复杂驾驶社会性理解的钥匙,其战略价值可能远超当前主流的自车数据。 3. 技术路径的融合:成功的关键在于多模态大模型(语言、视觉、控制)与领域知识(车辆动力学、交通工程)的深度结合。
自动驾驶的竞赛,下半场或许不再是单一的“算法竞赛”或“硬件竞赛”,而是**“理解人类能力的竞赛”**。谁先建立起准确、全面的“人类驾驶基准”,谁就能更快地造出被社会真正接受和信任的自动驾驶汽车。
🤔 深度思考:你认为这项“驾驶员基础模型”技术,最可能率先在哪个场景落地并产生最大价值?是Robotaxi的舒适度优化,还是干线物流卡车的节能降耗?欢迎在评论区留下你的真知灼见!
💝 支持原创:如果这篇近5000字的深度解读帮你洞见了自动驾驶评估的新范式,点赞+在看就是对我最大的鼓励!也欢迎分享给你身边关注AI和自动驾驶的技术伙伴!
🔔 关注提醒:关注我,设为星标,第一时间获取最前沿、最深度的AI技术拆解!
#AI技术 #自动驾驶 #大模型 #基准测试 #技术干货 #论文解读
参考
Benchmarking Autonomous Vehicles: A Driver Foundation Model Framework
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- 又一国产高颜值SUV,大7座布局,搭载插混动力,纯电续航100公里
- 宝马“大G”来了!豪华旗舰硬派SUV,预计2029年投产!对标奔驰大G
- 三款国产旗舰SUV,要改写高端市场?
- 12万级大五座SUV卷疯了:2.9米轴距+L2智驾,谁是你的菜?
- 不被裹挟!全新起亚Niro极睿混动SUV发布车型亮点
- 细思极恐?85%受访者警告:自动驾驶将逼疯网约车司机!
- Robotaxi从测试到商用,自动驾驶迎来新纪元
- 标准解读《道路车辆—自动驾驶系统测试场景—场景评估与测试用例生成》(ISO 34505:2025)
- 理想基座模型负责人詹锟:下一代自动驾驶大模型MindVLA-o1
- 你真懂自动驾驶吗