AAAI2026 :自动驾驶点云分割涨近20个点
- 2026-11-02 10:09:58
自动驾驶的激光雷达每秒拿到几十万个点,每一帧都是一个稀疏的三维世界。
从这里面让模型分清车、行人、路面,是比较困难的。
更麻烦的是,从仿真数据训练出来的模型,一到真实路况就没法用了。
不同天气、不同传感器、不同城市,数据分布一变,精度直线下降。
常规解法是测试时适应(TTA)。
训练集不动,让模型在推理过程中边看新数据边调整自身参数。
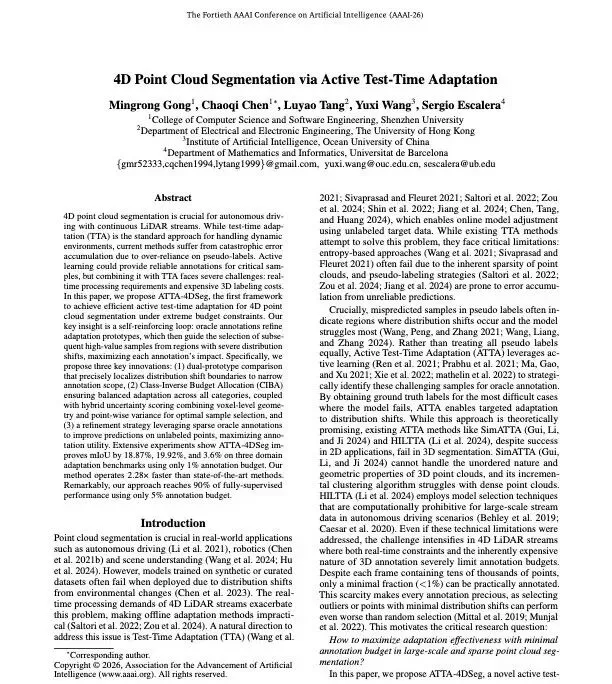
现有方法大多靠伪标签,用模型自己的预测来指导自己的更新。
伪标签的误差累积在图像任务里已经是个已知问题,在三维点云里就更严重。
因为点云每帧稀疏不均匀,某些区域几乎没有采样点。
模型预测置信度本来就低,一旦某类点预测偏了,后续迭代会把这个偏差越放越大。
这篇论文提出了 ATTA-4DSeg,核心想法是把主动学习接进 TTA 流程里。
主动学习就是让模型自己挑出最值得人工标注的那批样本,然后用真实标签来校正,这样就能解决偏差问题。
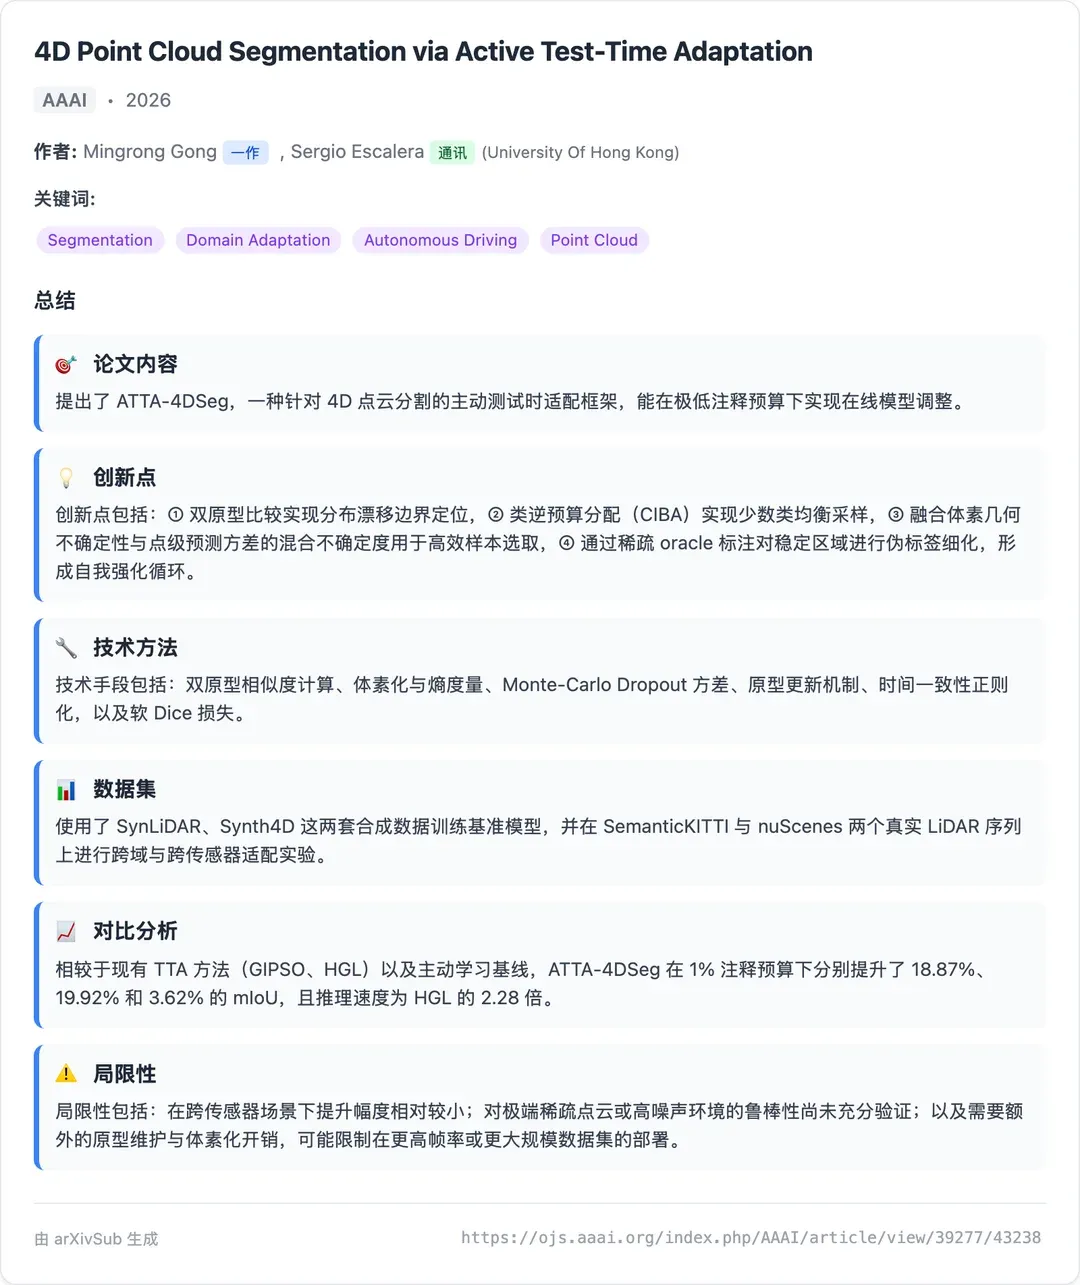
ATTA-4DSeg 的整个流程是一个自我强化的闭环。
1️⃣第一步用双原型对比定位分布漂移的边界:
模型同时维护一个来自源域的固定原型和一个随目标数据滚动更新的动态原型(原型可以理解成把属于某个类别的所有点的特征取平均)。
两者在特征空间里的余弦相似度差异可以精准筛出domain shift的点,也最值得标注的地方。
2️⃣第二步把有限的标注配额分给各类别:
行人这种稀少类别比车辆拿到的配额多十倍,防止高频类别把稀有类别的机会全吃掉,这个策略叫 CIBA(类别反比预算分配)。
选点时结合两种不确定性——体素层面的语义熵(把邻近点聚在一起算局部类别混乱程度)加上点级别的 Monte Carlo Dropout 方差(多次推理看预测抖动)。
这两者互补,比单一指标更能选出真正信息量高的点。
3️⃣第三步,已标注的少量真实标签不只用于当前帧。
系统把它们产生的局部类别分布传播到周围稳定区域,这样就能把一个标注点的价值放大给整批未标注点。
可以看作高质量的伪标签,这又让下一轮的原型判断更准确。
在三个域适应基准上:
1% 标注预算下分别涨了 18.87%、19.92% 和 3.6% mIoU,比当前最强 TTA 方法 HGL 高出约三倍,推理速度还快 2.28 倍。
跑到 5% 的预算,就能达到全量标注性能的 90%。
📬arXivSub: arxivsub.comfyai.app
📬LLM全英文免费教程: comfyai.app
#arxiv# #大语言模型 #每日论文 #医学影像 #多模态 #agent #医学图像 #LLM #智能体 #benchmark #AI #文献 #arxivsub
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- 【包头吉好】颜值控必看!中国轿车的“美学天花板”第5代帝豪限时享至高万元置换补贴
- 五菱星光L:4980mm大6座SUV,双插混+185km续航4月10日亮相
- 邢台到宁波轿车托运,费用怎么收费?内行人说出实情
- 吉利汽车集团获杭州 L3 级自动驾驶道路测试牌照
- 免费开一年!油价越涨,这款国产SUV「 比亚迪宋Ultra EV 」越香
- 十万左右|地表最强燃油轿车推荐
- 40万买三排豪华SUV?2026款雷克萨斯TX让我改变了一个偏见
- 张北大西湾乡一辆铲土车与轿车相撞.....轿车受损严重
- 名爵SUV工地用车,我也是尽力了
- 这款大六座SUV价格公布,对标两大对手,你可有异议?