当前位置:首页>自动驾驶>Nature子刊|碰撞率下降21%:自动驾驶终于学会像人一样思考

Nature子刊|碰撞率下降21%:自动驾驶终于学会像人一样思考

  • 2026-09-08 16:55:09
Nature子刊|碰撞率下降21%:自动驾驶终于学会像人一样思考

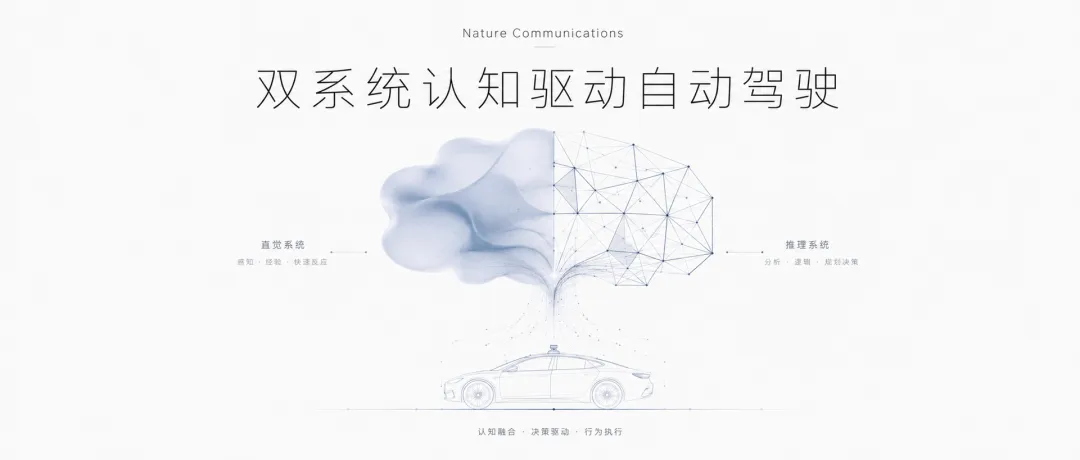
日常驾驶中,老司机不仅凭“肌肉记忆”在车流中穿梭,遇到路边翻倒的卡车时,更会瞬间切入“深度思考”模式,防范盲区窜出的行人。目前的自动驾驶系统却只会刻板匹配数据,对突发长尾场景一筹莫展。如果给大模型装上类似人类的“直觉+深思”双核大脑,会发生什么?

论文速览

维度

信息

标题

Autonomous driving system based on dual process theory and deliberate practice theory

作者

Xiao Zhang, Tianyu Hu 等

机构

北京科技大学、清华大学

论文地址

https://doi.org/10.1038/s41467-026-72030-6

代码地址

https://github.com/2351672564/CogniDrive

发表时间

2026年4月22日

背景与问题

尽管自动驾驶技术近年来高歌猛进,但在开放、无约束的现实世界中,其规模化落地仍面临巨大挑战。无论是传统的模块化架构(将感知、预测、规划流水线化),还是新兴的端到端方法,本质上都在试图将视觉特征映射到控制信号。这种架构严重依赖训练数据的分布。在面对数据集中鲜有出现的“长尾场景”(例如前方突然出现滚落的皮球、侧翻在地形状怪异的卡车)时,系统往往因为缺乏类似人类的常识推理能力而陷入瘫痪或做出危险决策。
近期,业界开始尝试将大语言模型(LLM,如 GPT-4)引入自动驾驶,以期利用其强大的世界知识进行推理。然而,现有的 LLM 驱动方案大多只是简单地将环境文本“翻译”成驾驶动作,系统依然停留在“输入-输出”的单向映射中。它们缺乏人类驾驶员在复杂场景下那种“自我反思、审时度势”的认知闭环。

核心贡献

首创双认知模式自动驾驶架构:基于“双过程理论”,设计出快速直觉决策与慢速反思推理的协同系统,完美平衡了推理效率与长尾场景的应对能力。
引入刻意练习理论破解数据依赖:提出创新性的“两阶段微调(格式学习与价值学习)”结合“经验检索(RAG)”,让模型只需极少样本即可掌握类似人类的轨迹规划范式。
多模态反思与多维评估体系:将视觉语言模型(VLM)整合为评估者,通过视觉与语言的双重奖励纠正感知遗漏;同时提出不仅关注安全,更考量舒适度与能效的综合评价框架。

方法详解

为了透彻理解 CogniDrive 的精妙设计,我们可以引入一个生动的比喻:一支分工明确的现代化作战部队 。

1. 前线快反部队:InstinctNav(直觉导航)

在日常驾驶场景中,InstinctNav 扮演着“快反部队”的角色,以极低的认知成本输出极速决策 。系统为大模型植入了“思维模型(Thought Model)”,强制其按照“态势感知  行为决策  轨迹规划”的链条(CoT)进行直觉推理 。

其核心推演公式为:

行动计划(目标 、动作、轨迹)由大模型结合指令、态势、历史轨迹以及战术手册 迅速生成 。

2. 后方参谋部:ReflectPlan(反思规划)

当系统预测到碰撞风险或遭遇复杂场景时,会瞬间激活“后方参谋部” 。这套慢速分析系统不再追求盲目响应,而是引入了强大的审视闭环 。参谋部内有两大核心角色:

战术指导员(LLM Critic):审视快反部队的初步方案,用自然语言输出对安全、舒适度与能效等维度的反思与纠偏 。

情报分析师(VLM Evaluator):直接“看”懂原始多视角画面(),通过深度语义理解对环境危险源(如侧翻卡车)发出文字警报,弥补传统感知模块的遗漏 。

参谋部会将指导员的“语言奖励(Verbal Reward)”与分析师的“视觉奖励(Vision Reward)”进行融合:

最终,参谋部带着高浓度的多模态反思信息,强制大模型进行复盘与重新规划:

通过“快反部队+后方参谋”的协同作战,极端长尾场景下的驾驶危机迎刃而解 
关键图表解读

1. 全局战术指挥架构
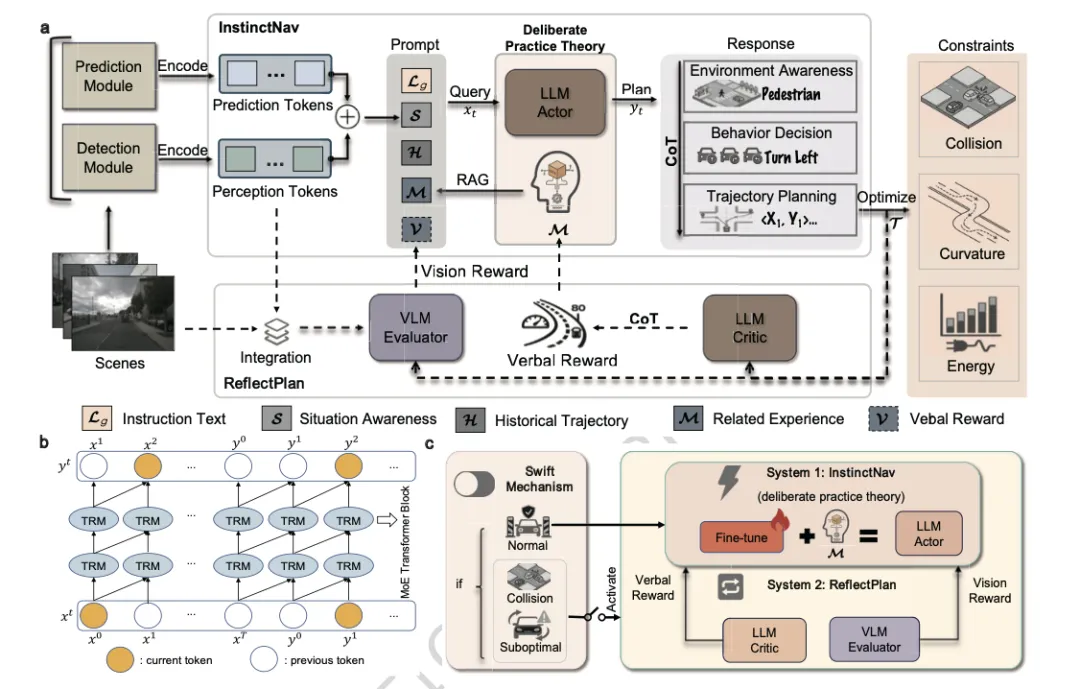
图 1. 双系统认知架构图
👉 解读:
上方是 InstinctNav 模块,常规的感知和预测 Token 被送入 LLM Actor,结合 RAG(经验库)直接生成轨迹,链路极短、速度极快。
而下方则是 ReflectPlan 模块,仅当指示函数判定当前轨迹存在碰撞风险时才被激活。一旦激活,VLM Evaluator 和 LLM Critic 共同介入,产生包含场景细节的文字反思,将优化后的信息回传给 Actor 进行轨迹重构。这种设计既保证了常态下的实时性,又在危急时刻筑牢了安全底线。
2. 参谋部发威:长尾绝杀
表 1.  边界情况下的碰撞性能
👉解读 :
传统的端到端模型(UniAD)在应对长尾场景时全面崩溃,平均碰撞率飙升至 8.89%。即便是结合了工具调用库的 Agent-Driver,碰撞率也高达 4.45%。而 CogniDrive 凭借 ReflectPlan 的多模态兜底反思,硬生生将平均碰撞率压低至惊人的 2.05%。数据表明,VLM 的加入有效弥补了感知系统在未知物体上的漏检,而 LLM 的语言逻辑链赋予了系统举一反三的危机应对能力。

实验与结果

除上述开环测试外,研究团队更在 CARLA 仿真器中进行了高难度的闭环动态交互测试。结果显示,在考虑了误差累积和动态博弈的真实物理世界中,CogniDrive 的路线完成成功率高达 27.37%,取得了超过 10.54% 的相对提升,且保持了同类方法中最低的颠簸度(Jerk 8.20%)与最低的能量消耗。
此外,小样本泛化实验揭示了一个恐怖的效率:得益于清晰的“思维模型”,CogniDrive 仅需使用原数据集 5% 的样本,就能在 L2 轨迹误差上击败使用了 100% 数据的传统基线模型。

结论

CogniDrive 将认知科学中的“快慢思考”与“刻意练习”无缝融入自动驾驶架构,为深陷数据泥沼的端到端方案劈开了一条新路。通过 VLM 解决“看不见”的感知盲区,通过 LLM 解决“想不到”的推理缺陷,最终在安全与体感双维度实现了质的飞跃。
🤔️开放思考 :
  • 随着 Qwen、Llama 等基座模型能力的不断跃升,自动驾驶的瓶颈是否会从“算法设计”彻底转变为“优质高密度微调语料的构建”?
  • 在全面走向 AGI 的路上,如何为自动驾驶的大脑植入一套绝对可靠、无法被绕过的“阿西莫夫机器人三定律”底层逻辑系统?
更多阅读

最新文章

随机文章