
当前位置:首页>自动驾驶>让自动驾驶学会“老司机”的经验 :CBR-LLM 如何在安全关键驾驶场景中做出避险决策

让自动驾驶学会“老司机”的经验 :CBR-LLM 如何在安全关键驾驶场景中做出避险决策

  • 2026-10-25 10:57:02
让自动驾驶学会“老司机”的经验 :CBR-LLM 如何在安全关键驾驶场景中做出避险决策

点击蓝字 关注我们

让自动驾驶学会“老司机”的经验:

CBR-LLM 如何在安全关键驾驶场景中做出避险决策

1

研究背景:最危险的往往不是日常行驶,而是那些低频但高危的突发场景

自动驾驶和高级驾驶辅助系统已经在感知、规划和控制方面取得了大量进展,但真正棘手的场景往往出现在低频、高风险、强时间压力的“安全关键驾驶场景”中。前车急刹、旁车突然切入、路口车辆突然转弯、雨雪天行人被遮挡,这些事件发生概率不高,却可能直接导致碰撞或严重伤害。

传统规则系统的优点是清晰、可验证,但面对复杂道路交互时容易显得僵硬;端到端深度学习模型可以从大规模数据中学习,却容易受到训练数据分布影响,在罕见风险场景中泛化不足,也难以解释“为什么采取这个动作”。

大语言模型具备较强的语义理解和推理能力,因此被逐渐引入自动驾驶决策研究。但直接把 LLM 用于安全关键驾驶仍存在明显风险:模型可能缺乏领域经验,可能产生过度自信判断,也可能在长尾场景中给出不稳定建议。论文提出的 CBR-LLM 框架,正是为了解决这一问题:让模型在推理前先获得“类似案例”的经验锚点。

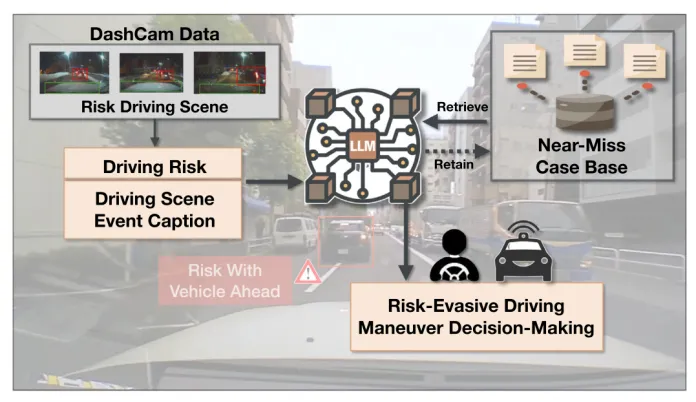
图1 CBR-LLM 概念示意:系统以 DashCam 视频为输入,结合近事故案例库,输出风险规避驾驶动作

2

核心问题:如何让模型像有经验的司机一样决策

人在危险驾驶场景中并不会从零开始枚举所有动作,而是快速匹配经验:这个场景像不像以前遇到过的某次险情?当时风险来自哪里?采取什么动作能有效避险?论文将这种“经验检索 + 场景推理”的过程建模为 CBR-LLM。

CBR 是 Case-Based Reasoning,即案例推理。它负责从历史近事故案例中检索与当前场景相似的案例;LLM 则负责把当前场景描述、风险类型和历史案例进行综合推理,生成本车应该采取的避险动作以及对应理由。这个设计相当于把“经验记忆”嵌入大模型推理链条中。

3

研究方法:三阶段框架,让模型先感知、再回忆、再决策

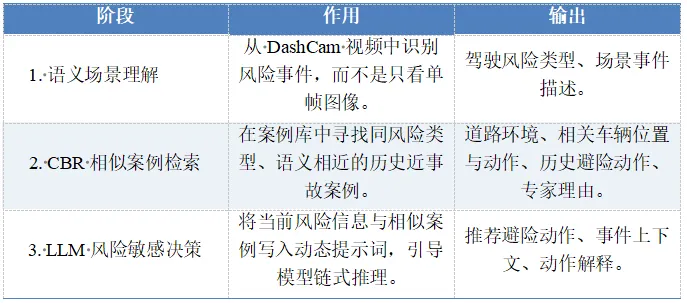
论文提出的框架可以概括为三个连续模块。

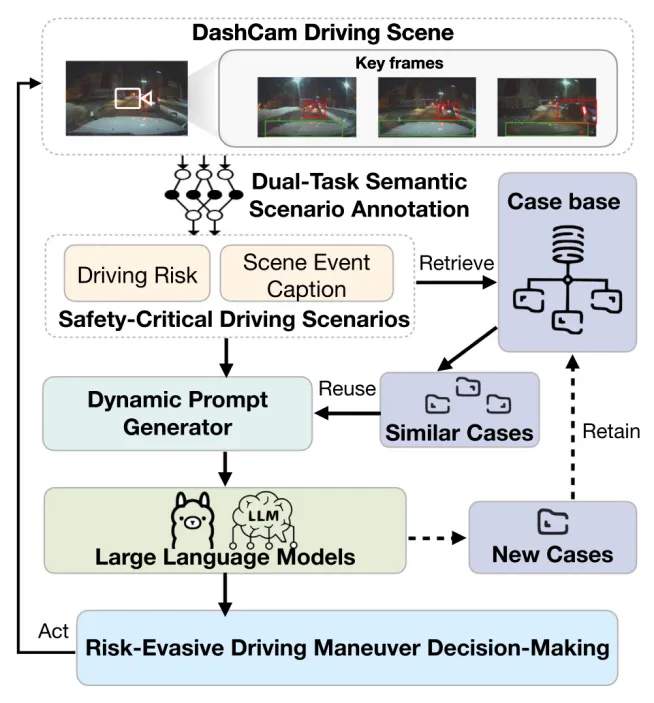
第一阶段是双任务语义分析。模型先判断当前场景是否存在风险;若存在风险,再进一步区分风险类型,并生成自然语言事件描述。这种设计把视频中的时空变化转化为可被 LLM 使用的语义输入。

第二阶段是案例检索。每个历史案例被组织为“风险类型 + 场景事件描述”的键,以及“道路上下文、其他车辆位置、其他车辆动作、本车避险动作、动作理由”等值。系统使用文本嵌入模型计算场景相似度,并优先在同一风险类型下检索案例。

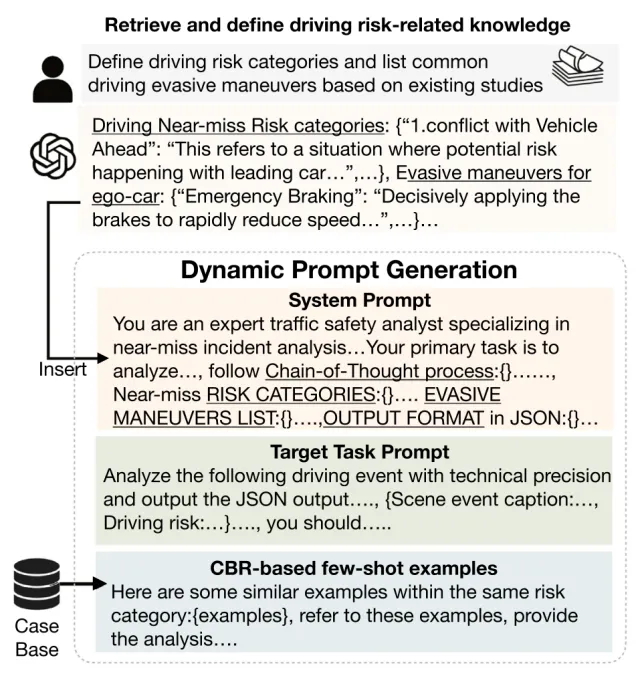
第三阶段是动态提示词生成和 LLM 推理。提示词中包含风险知识、当前事件描述、潜在风险、相似案例和固定输出格式。模型被要求按照链式推理步骤,先分析道路环境和风险对象,再给出避险动作及理由。

图2 CBR-LLM 总体框架:场景理解、案例检索、动态提示词和 LLM 决策形成闭环

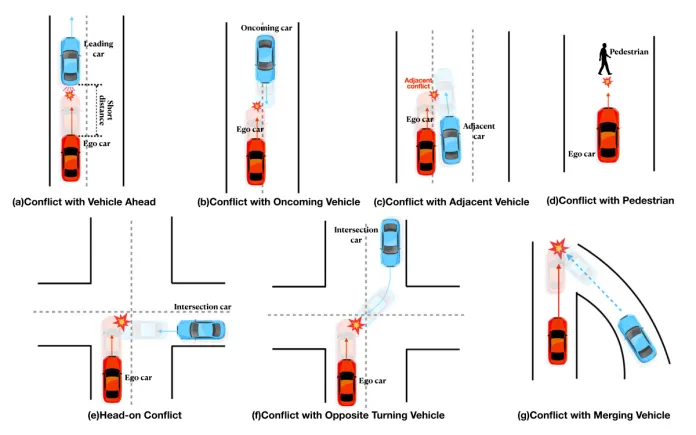
图3 七类安全关键驾驶风险,包括前车冲突、相邻车辆冲突、行人冲突、正面冲突等

4

实验设计:真实近事故视频 + 多模型对比

研究使用来自东京农工大学的真实自然驾驶近事故数据集。原始数据包含超过 22 万段近事故视频,每段视频约 15 秒,覆盖触发点前 10 秒和触发点后 5 秒。由于版权限制,论文选取了 1000 个样本进行实验,并尽量平衡七类风险场景。

除风险类型外,研究还手工标注了光照、交通流量、天气和道路环境等上下文信息,用于评估框架在不同驾驶条件下的鲁棒性。样本中夜间、重交通和城市道路占比较高,因此更偏向复杂和高风险情境。

实验比较了多个开源大语言模型,包括 Mistral 7B、Mistral-Nemo 12B、Mixtral 8x7B、Phi-4 14B、DeepSeek-R1 14B、Gemma2 27B、Qwen2.5 32B 和 Llama 3.3 70B。评估指标包括避险动作准确率,以及事件上下文和动作解释与专家文本之间的相似度。

图4 动态提示词生成流程:系统提示词、任务提示词与 CBR 检索案例共同输入 LLM

5

研究结果:相似案例比随机示例更有用,风险感知提示更稳定

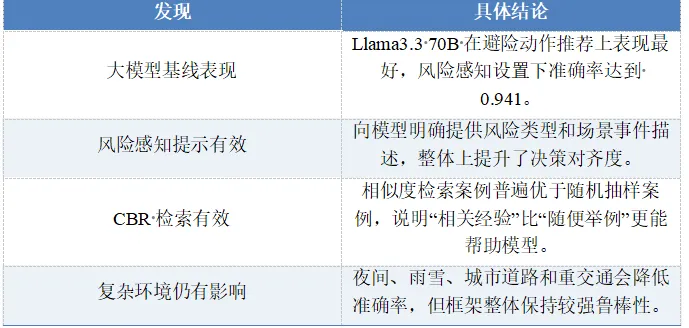
论文的主要发现可以概括为四点:

在风险感知与风险不感知对比中,Llama3.3 70B 的准确率从 0.937 提升到 0.941;Gemma2 27B 从 0.893 提升到 0.918;Qwen2.5 32B 从 0.875 提升到 0.898。Phi-4 14B 在风险感知设置下略有下降,说明不同模型对提示词和风险信息的利用能力并不完全一致。

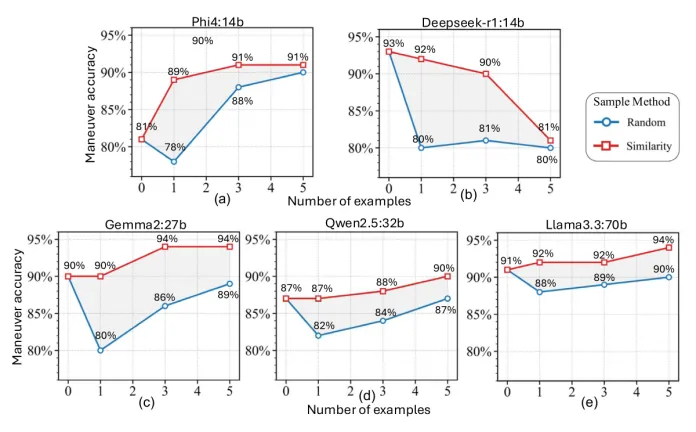
在 CBR 增强实验中,研究者将 100 个样本作为测试集,其余 900 个样本作为案例库。结果显示,相似度检索案例通常比随机选取案例带来更高准确率。随着相关案例数量增加,多数模型表现进一步提升。一个例外是 DeepSeek-R1 14B:增加 few-shot 示例反而导致性能下降,提示我们不能简单认为“例子越多越好”。

图5 CBR 增强效果:红线为相似度检索,蓝线为随机抽样。多数模型中,相似案例能带来更高避险动作准确率

6

案例解析:模型如何在具体险情中给出动作

论文展示了两个案例,用于说明 CBR-LLM 如何把场景理解、历史案例和 LLM 推理结合起来。

案例一:相邻车辆突然切入

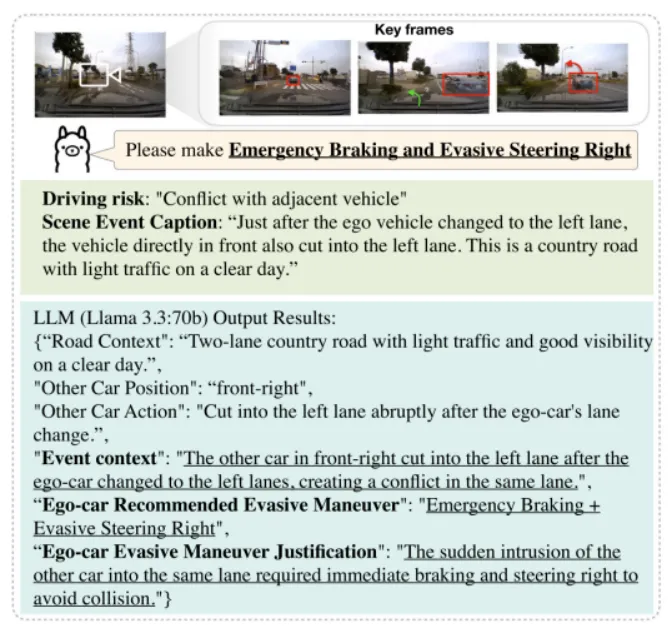
第一个案例属于“相邻车辆冲突”。本车变道后,前方右侧车辆突然切入本车行驶路径,造成潜在碰撞风险。CBR-LLM 识别出风险对象位于前右方,并推荐“紧急制动 + 向右避让”。该动作的逻辑是先通过制动降低碰撞风险,再利用右侧空间规避切入车辆。

图6 相邻车辆冲突案例:模型推荐 Emergency Braking and Evasive Steering Right

案例二:雪天路口正面冲突

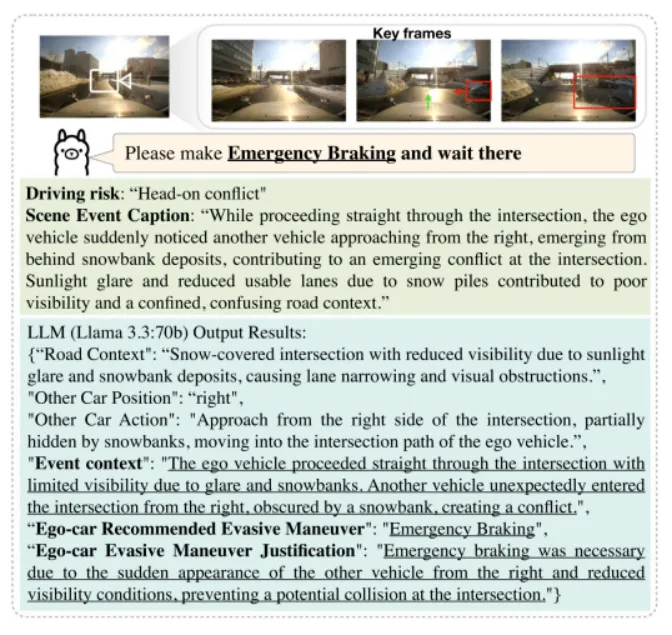
第二个案例发生在雪天路口,属于“正面冲突”。由于路面积雪、眩光和遮挡,另一辆车从右侧进入路口,形成潜在冲突。模型推荐“紧急制动并等待”,这是一种更保守、也更符合低能见度和低附着路面条件的策略。

图7 雪天路口正面冲突案例:模型推荐 Emergency Braking,并强调谨慎等待

7

研究价值:让智能驾驶决策更可解释、更贴近人类经验

这项研究的价值,不在于证明大语言模型可以直接替代自动驾驶控制系统,而在于提出了一种更可信的安全决策范式:大模型不是单独生成答案,而是在结构化风险信息和真实历史案例的约束下进行推理。

从工程角度看,CBR-LLM 的模块化设计也更利于调试和验证。场景理解、案例检索和 LLM 推理被拆分为不同环节,系统可以分别检查风险识别是否正确、案例是否相似、决策理由是否合理。与黑箱式端到端模型相比,这种路径更便于安全审查。

从产品角度看,该框架更接近未来智能驾驶助手或 AI co-pilot 的形态。它可以帮助车辆在危险场景中给出风险提示、避险建议和可读解释,也可以用于驾驶培训、事故复盘和人机协同决策。

8

局限与展望:离真实上车仍有关键距离

论文也明确指出了当前方法的边界。首先,实验样本来自日本的城市和乡村道路,地理和文化多样性有限;不同地区的驾驶习惯、让行规则和风险接受度可能影响案例检索和动作选择。

其次,当前框架的推理延迟尚未满足闭环自动驾驶中即时避险的实时要求。LLM 生成解释虽然提升了用户可理解性,但还不能证明模型的内部因果推理完全可靠。未来仍需要引入物理约束校验、形式化安全验证和更快的推理机制。

因此,CBR-LLM 更适合作为面向安全关键驾驶决策的研究原型和辅助决策框架,而不是可直接部署的车辆控制系统。它给出的方向是清晰的:未来的智能驾驶系统不仅要看得见环。

本文根据 Gan, Dao & Zettsu 发表在 Safety Science 的论文《Case-Based Reasoning Augmented Large Language Model Framework for Decision Making in Realistic Safety-Critical Driving Scenarios》整理改写。

END

扫描上方二维码关注我们

最新文章

随机文章