⚡ 2026 arXiv重磅|小米自动驾驶联合世界模型:重建+生成一体化,秒级仿真+实时预测
📖 导读
这篇聚焦自动驾驶世界模型一体化的突破性研究,由小米EV世界模型团队重磅发布,直击行业核心痛点:现有自动驾驶世界模型要么“重重建、缺生成”(只能还原已知场景,无法预测未知),要么“重生成、弱几何”(预测易漂移、跨帧不一致),且普遍存在重建耗时久、生成推理慢、时序稳定性差三大致命短板,难以支撑闭环仿真、长尾数据合成与端到端训练。
小米团队创新提出联合世界模型(Joint World Model),拆解为两大核心模块:WorldRec(稀疏查询驱动的前馈重建) 与 WorldGen(双向预训练+因果微调的生成),实现深度融合、优势互补。WorldRec将场景重建从4小时压缩至10秒,输出紧凑高保真3D高斯表征;WorldGen仅需4步去噪实现0.19秒/帧实时生成,支持最长1分钟稳定视频预测;联合模型彻底解决几何漂移与幻觉问题,为自动驾驶提供“精准还原已知、可信预测未知”的全链路世界建模方案,推动自动驾驶仿真与训练范式革新。
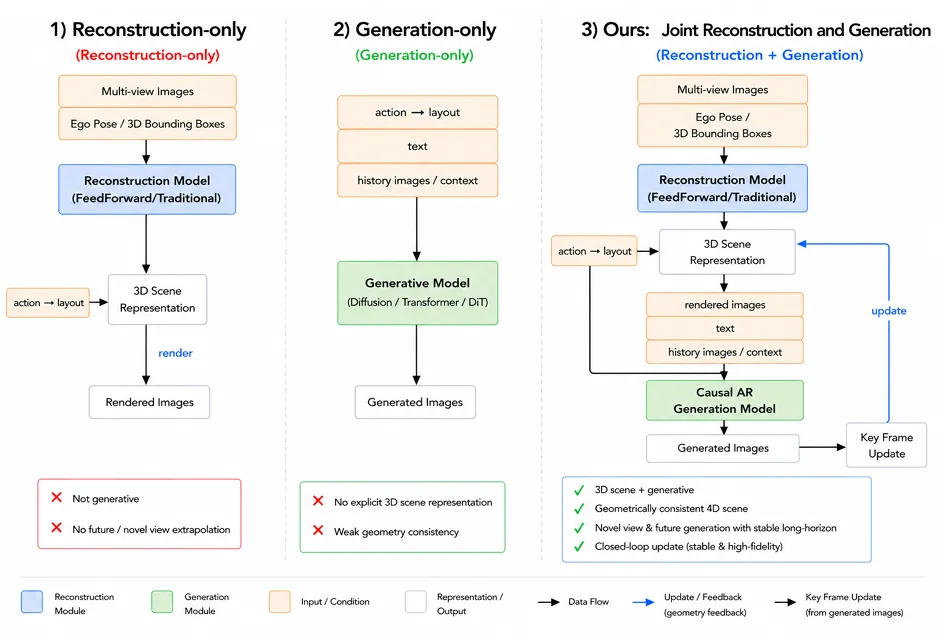
图1 仅重构模型、仅生成模型与本文联合世界模型对比
论文核心信息
- 论文题目:Xiaomi EV World Model: A Joint World Model Integrating Reconstruction and Generation for Autonomous Driving(小米自动驾驶联合世界模型:重建与生成一体化)
- 项目链接:https://JointWM.github.io
- 重建性能:10秒完成10秒驾驶视频重建(传统方法4小时);Waymo数据集PSNR=28.48、SSIM=0.861,nuScenes零样本PSNR=26.54、SSIM=0.821;
- 生成性能:仅4步去噪,0.19秒/帧(单视角)、0.46秒/帧(三视角);最长1分钟稳定生成(30fps);nuScenes数据集FID=7.04、FVD=64.97;
- 联合性能:长时序无漂移、多视角全局一致、多次生成结果稳定,完美适配闭环仿真与数据合成。
- 稀疏查询重建:3D稀疏查询聚合跨视图/时序特征,可消除传统逐像素重建的鬼影与冗余,兼顾速度与精度;
- 双向预训练+因果微调:先学全局场景分布,再分三阶段适配实时生成,平衡生成质量、速度与时序稳定性;
- 重建生成深度耦合:确定性几何约束抑制生成漂移,生成能力补全未知区域,实现1+1>2的协同增益;
- 增量重建+渲染先验:支持长序列场景持续扩展,为生成提供几何锚点,解决无纹理区域生成难题。
- 首创稀疏查询前馈重建(WorldRec),突破传统重建速度与冗余瓶颈,秒级输出3D高斯场景;
- 提出WorldGen两阶段生成框架,双向预训练+三阶段因果微调,实现4步实时生成+1分钟稳定预测;
- 构建深度融合联合世界模型,重建几何约束生成、生成补全重建盲区,解决漂移与幻觉;
- 适配自动驾驶专属场景:多相机一致性、自车运动感知、结构化布局可控,直接落地仿真与训练;
- 低成本高效能:单H20 GPU即可运行,无需高端算力,适配车载边缘部署潜力。
- 核心主题:自动驾驶世界模型、3D高斯重建、视频扩散生成、稀疏查询、因果微调、闭环仿真、数据合成、端到端训练
- 核心受众:自动驾驶算法工程师、仿真平台研发人员、生成式AI研究者、车企智能驾驶团队、计算机视觉科研人员
❓ 传统自动驾驶世界模型五大“核心痛点”
- 重建效率极低:传统逐场景3D高斯优化需数小时,无法快速迭代与大规模部署;前馈重建逐像素生成,冗余达数亿高斯,渲染卡顿、鬼影严重;
- 生成质量差、速度慢:从头训练因果扩散模型缺乏场景先验,生成模糊;数百步去噪推理,无法实时部署;自回归生成长期漂移、内容失真;
- 重建生成割裂脱节:多数模型将两者作为独立模块,几何精准与分布多样性难以兼顾;无法共享场景信息,跨帧、跨视角一致性差;
- 自动驾驶适配不足:通用模型不支持多相机外参校准、自车运动条件、结构化布局控制;难以处理动态车辆、行人、极端天气等驾驶特有场景;
- 闭环应用价值低:漂移与幻觉导致仿真结果不可靠,无法用于端到端策略训练;长尾场景生成能力弱,数据合成质量差、实用性低。
🔧 核心真相:小米联合模型四大突破机制
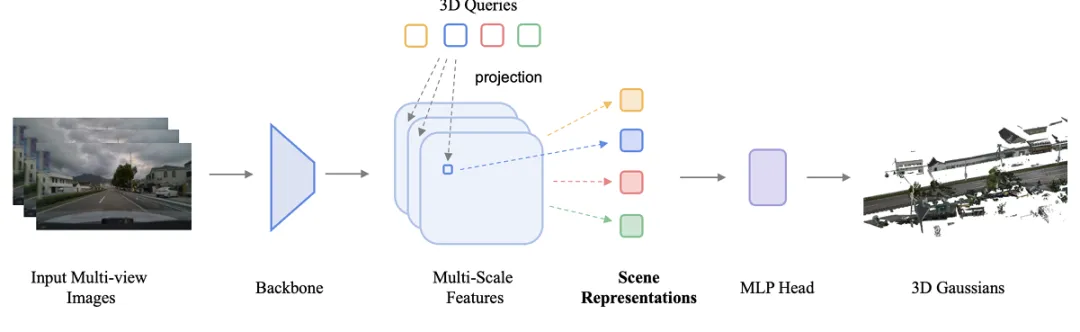
图2 WorldRec 架构
1. 重建真相:稀疏查询替代逐像素,秒级高保真还原(真相1)
摒弃逐像素生成冗余高斯,用稀疏3D查询重构重建逻辑:
- 初始化N个可学习3D查询,投影至多相机多时序特征图,提取局部特征;
- 可见性加权聚合跨视图/时序特征,生成场景token,解码为3D高斯属性;
- 10秒完成重建,无鬼影、无冗余,高斯数量精简90%+,渲染效率大幅提升。
2. 生成真相:双向预训练+三阶段微调,4步实时稳定预测(真相2)
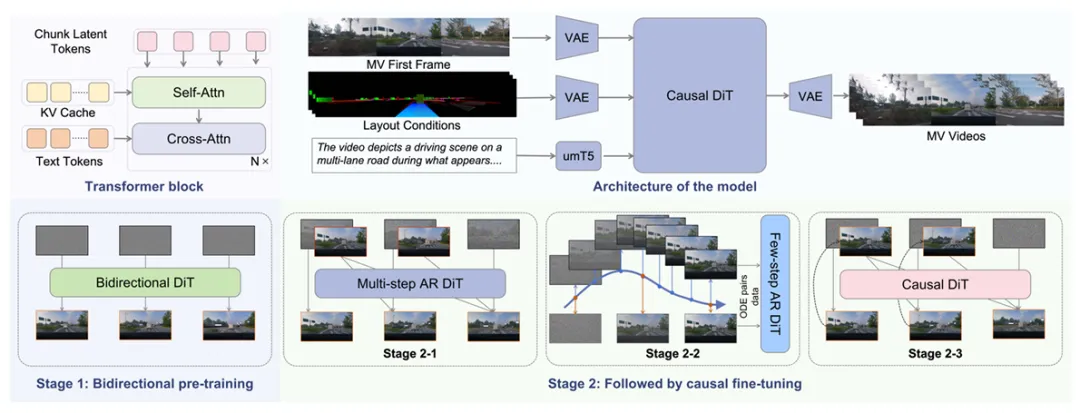
打破“质量-速度-稳定性”不可能三角,分阶段渐进优化:
- 阶段1(双向预训练):全时序注意力学习全局场景分布,积累强生成先验;
- 阶段2(因果微调-教师强制):加因果掩码适配自回归,快速收敛;
- 阶段3(ODE蒸馏):50步去噪压缩至4步,推理提速12倍;
- 阶段4(DMD蒸馏):用自生成数据训练,消除暴露偏差,1分钟长时序无漂移。
3. 融合真相:几何约束+生成补全,双向协同破解顽疾(真相3)
让重建与生成深度绑定、优势互补,解决行业核心矛盾:
- WorldRec增量重建:持续融合新观测,扩展4D场景表征,提供确定性几何锚点;
- WorldGen渲染先验条件:从重建场景渲染目标视角图像,作为生成额外条件;
- 几何约束抑制漂移:重建的精确场景结构,防止生成过程中物体错位、纹理失真;
- 生成补全盲区:生成模型填充遮挡、未知区域,突破重建仅能覆盖观测范围的限制。
4. 落地真相:自动驾驶专属优化,直接适配全链路场景(真相4)
针对驾驶场景定制化设计,从实验室走向车载落地:
- 多相机一致性:强制跨相机特征对齐,生成结果全局一致;
- 多模态可控:支持自车轨迹、相机参数、布局图、文本提示等条件输入;
- 极端场景适配:稳定生成暴雨、浓雾、动物闯入等长尾/极端驾驶场景;
- 轻量化部署:单GPU即可运行,算法优化后适配车载边缘设备实时仿真。
关键内容
1. 重建性能:小米WorldRec vs 主流前馈重建模型
| | | | |
|---|
| | | | |
| | | | |
| | | | |
| 小米WorldRec | 28.48/0.861 | 26.54/0.821 | 10秒 | 极低 |
2. 生成性能:小米WorldGen vs 主流自动驾驶生成模型
| | | | | |
|---|
| | | | | |
| | | | | |
| | | | | |
| | | | | |
| 小米WorldGen | | 7.04 | 64.97 | 81帧(1分钟) | 5.26 |
3. 联合模型核心能力表现
💬 Q&A
Q1:稀疏查询重建相比逐像素重建,核心优势是什么? A:① 极致高效,10秒完成重建,高斯数量减少90%+,无冗余;② 无鬼影伪影,跨视图特征聚合强制空间一致性,解决逐像素拼接错位;③ 全局一致性强,稀疏查询覆盖全场景,避免局部细节缺失;④ 适配动态场景,时序特征融合精准捕捉车辆、行人运动。
Q2:WorldGen如何做到4步实时生成还能保持高质量? A:核心是两阶段训练+三重蒸馏:① 双向预训练积累全局场景先验,避免从头训练的低效;② 教师强制快速适配因果生成,稳定训练;③ ODE蒸馏将50步压缩至4步,提速12倍;④ DMD蒸馏消除暴露偏差,保证长时序稳定。
Q3:联合模型的“重建+生成”融合,到底解决了什么核心问题? A:解决了“几何准就不能预测、能预测就会漂移”的行业死结:① 重建提供精确3D结构,像“锚点”一样固定生成内容,抑制漂移和幻觉;② 生成填充遮挡、未知区域,突破重建只能看到“眼前”的局限;③ 两者共享场景信息,跨帧、跨视角一致性大幅提升,仿真更真实可靠。
Q4:这个模型能直接用于自动驾驶仿真和数据合成吗? A:完全可以:① 支持长时序闭环仿真,可模拟车辆长距离行驶,用于端到端策略训练;② 能生成暴雨、浓雾、动物闯入等长尾场景,低成本扩充训练数据;③ 生成结果几何精准、时序稳定,仿真到现实的域 gap 小,训练出的模型泛化性更强。
Q5:目前技术还有哪些局限? A:① 暂不支持非刚性动态物体(如行人肢体细节)的精细建模;② 极端杂乱城市场景下,小物体生成精度略有下降;③ 未融合LiDAR点云数据,纯视觉重建在弱光场景精度略低;④ 模型体积较大,车载端轻量化部署还需进一步优化。
🎯 点评
- 核心贡献:首次实现自动驾驶世界模型重建与生成的深度一体化,提出WorldRec稀疏查询重建,将重建效率提升数百倍;打造WorldGen高效稳定生成框架,实现4步实时生成+1分钟长时序预测;构建联合模型,用几何约束解决生成漂移、用生成补全重建盲区,为自动驾驶提供“精准还原+可信预测”的全链路世界建模方案,推动仿真、数据合成、端到端训练三大场景的技术革新。
- 亮点:① 效率革命,秒级重建、实时生成,低成本适配大规模部署;② 质量突破,几何精准、时序稳定、多视角一致,解决行业核心痛点;③ 场景适配,定制化适配驾驶特有场景,直接落地工业应用;④ 协同增益,重建与生成双向赋能,实现1+1>2的效果;⑤ 潜力巨大,轻量化优化后适配车载边缘设备,支撑自动驾驶实时仿真。
- 不足:① 纯视觉方案在弱光、逆光场景重建精度下降;② 非刚性动态物体细节建模不足;③ 未融合多传感器数据(LiDAR、毫米波雷达),感知维度单一;④ 模型轻量化不足,车载端部署需进一步压缩。
🌟 总结金句
自动驾驶世界模型的终极突破,不在于单独提升重建精度或生成速度,而在于用稀疏查询实现高效重建、用两阶段训练实现稳定生成、用深度融合实现双向赋能、用场景定制实现工业落地,让自动驾驶既能看清眼前路,又能预判未来险,彻底重构自动驾驶仿真与训练的技术底座。
📌 互动引导
你认为小米联合世界模型最具产业化价值的落地场景是什么? ● ✅ 自动驾驶闭环仿真平台,支撑端到端策略训练 ● ✅ 长尾/极端场景数据合成,低成本扩充训练数据集 ● ✅ 车载实时虚拟感知,补全遮挡、盲区环境感知 ● ✅ 智能驾驶测试验证,高效覆盖边缘场景测试用例 ● ✅ 车机交互虚拟场景渲染,提升座舱沉浸式体验 欢迎在评论区分享观点,一起探讨AI驱动自动驾驶的未来 👇
🧩 思考/研究 Idea 彩蛋(可操作方向)
- 多传感器融合:融合LiDAR、毫米波雷达数据,提升弱光/雨天场景重建精度,适合CVPR/ICCV;
- 非刚性动态建模:引入神经辐射场(NeRF)建模行人、骑行者肢体细节,适合ECCV;
- 车载轻量化部署:模型蒸馏、算子优化,适配车规级芯片实时运行,功耗<5W,适合IEEE TIV;
- 多模态指令生成:支持自然语言指令生成指定驾驶场景(如“暴雨下的城市道路”),适合NeurIPS;
- 端到端联合训练:世界模型与自动驾驶规划控制模块联合训练,提升策略泛化性,适合ICRA;
- 多尺度世界建模:融合宏观道路布局与微观物体细节,适配不同层级感知需求,适合Nature Communications。
 10个月宝宝每天需要喝多少奶粉?