当前位置:首页>自动驾驶>当自动驾驶遇上人类司机:如何让车辆“聪明”地协同决策?

当自动驾驶遇上人类司机:如何让车辆“聪明”地协同决策?

  • 2026-10-31 09:12:10
当自动驾驶遇上人类司机:如何让车辆“聪明”地协同决策?

当自动驾驶遇上人类司机:如何让车辆“聪明”地协同决策?

Part 01
 背景

在城市交通系统中,自动驾驶车辆正逐渐进入我们的日常生活。然而,当自动驾驶车与人类驾驶车辆共享道路时,如何确保它们能够安全、高效地协同行驶,成为了一个亟待解决的关键问题。尤其是在无信号交叉口等强冲突场景下,自动驾驶车辆的决策失效和接管率居高不下,严重制约了其规模化应用。本研究提出了一种融合层次博弈与近端策略优化(HGPPO)的多车协同决策方法,试图为人机混驾环境下的车辆协同提供一种新颖且高效的解决方案。

Part 02

人机混驾环境中的决策挑战与系统复杂性

随着自动驾驶与网联通信技术的发展,交通系统正进入人车混行的新阶段。尽管自动驾驶车辆在感知与响应上具有优势,但在无信号交叉口等开放道路场景中,其决策系统常因人类驾驶员行为的多样性与不确定性而面临严峻挑战。

研究显示,超过51%的自动驾驶接管事件发生在交叉口,无信号交叉口的事故率可达人类驾驶车辆的5倍。人类驾驶员决策具有“有限理性”特征,行为模式从保守到激进呈现连续异质性,这显著增加了协同决策的复杂性与不确定性。

Part 03

博弈思维与强化学习融合的HGPPO方法

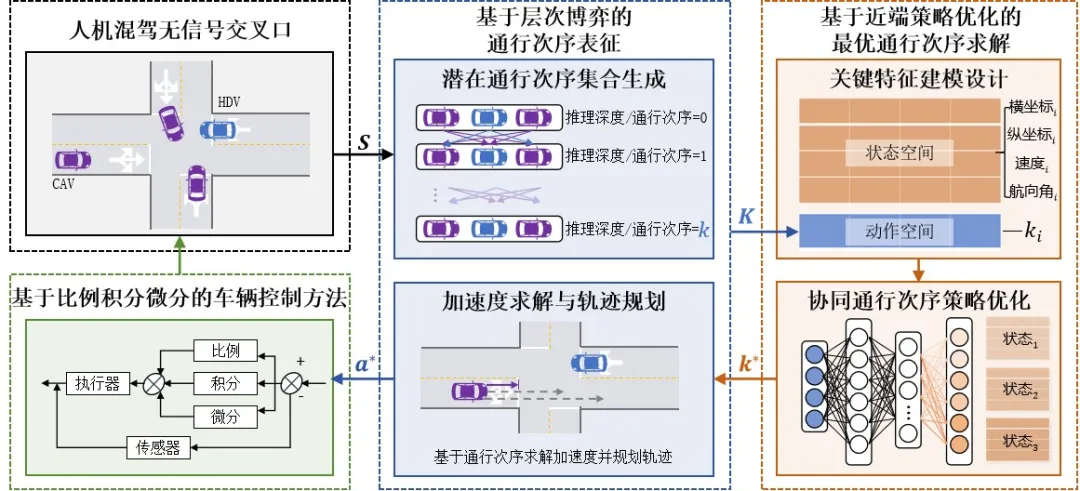
本文提出了“层次博弈表征-近端策略优化”框架,其核心思想是通过两个关键模块的配合,实现既考虑人类异质性、又能实时求解的协同决策。

1.用“层次博弈”理解人类驾驶员

研究没有假设人类驾驶员是完全理性的,而是引入了层次博弈模型,将驾驶员的推理深度与通行次序直接关联:

①定义推理深度k:k=0的驾驶员仅将其他车辆视为匀速行驶,快速做出非策略性决策;k>0的驾驶员则会基于对他人推理深度的预判进行决策;

②通过多轮迭代推演,建立“推理深度-行为策略-通行次序”的递进关系,全面表征所有潜在通行次序组合,精准捕捉人类驾驶员的异质特征;

③利用动态时间规整(DTW)技术,通过对比规划轨迹与真实轨迹的相似度,实时估计人类驾驶车辆的推理深度,为协同决策提供可靠依据。

图1 HGPPO协同决策算法框架

2.用“强化学习”快速搜索最优解

虽然层次博弈梳理了可能性,但参与车辆增多时,通行次序组合会指数级增长,难以实时计算。为此,研究采用了近端策略优化算法,大幅提升决策实时性:

①状态空间涵盖交叉口内所有车辆的位置、速度、航向角等核心信息,动作空间直接定义为通行次序(离散为0-3级),简化决策维度;

②设计多目标奖励函数,综合考量通行效率(鼓励合理高速行驶)、安全性(碰撞惩罚)与任务完成度(到达终点奖励),平衡系统目标;

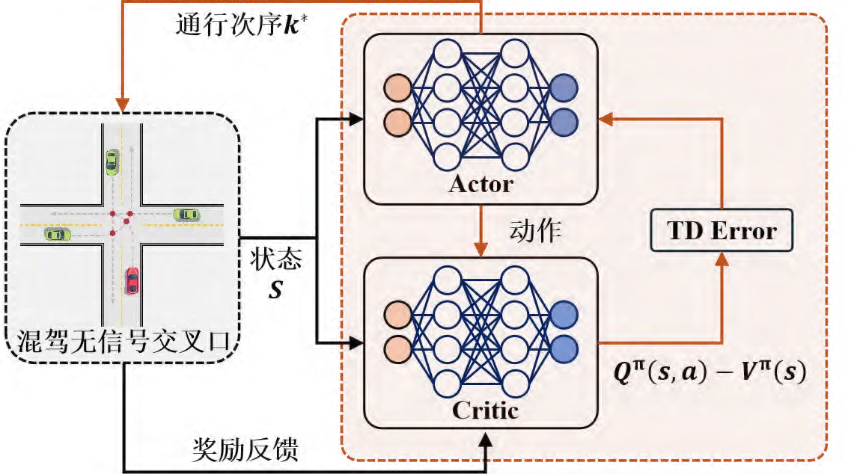
③借助Actor-Critic架构与裁剪机制,在保证策略稳定更新的同时,实现最优通行次序的高效搜索,单步求解时间仅0.14s,满足实际部署的实时性要求。

图2 Actor-Critic架构图
Part 04
 实验验证

通过仿真测试、硬件在环与驾驶人在环测试等多维度验证,充分证明了 HGPPO 算法的优越性:

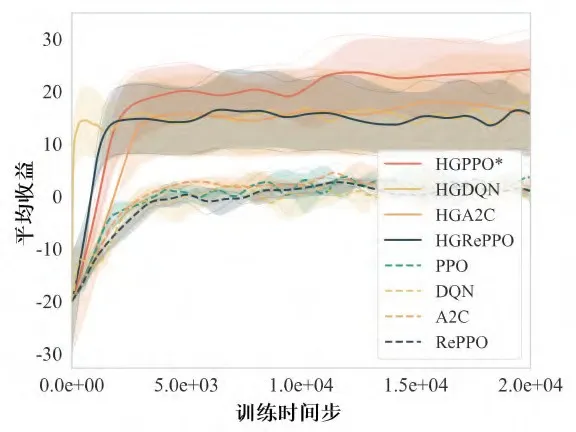
1. 收敛更快,效果更好

相比于传统的DQN、A2C等强化学习算法,HGPPO在训练初期就展现出更快的收敛速度和更高的最终收益,且收敛后收益稳定高于其他算法,样本利用效率显著提升。

图3 不同强化学习算法训练过程收益变化

1. 安全性能拉满

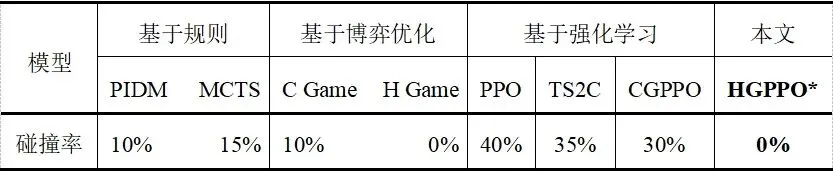
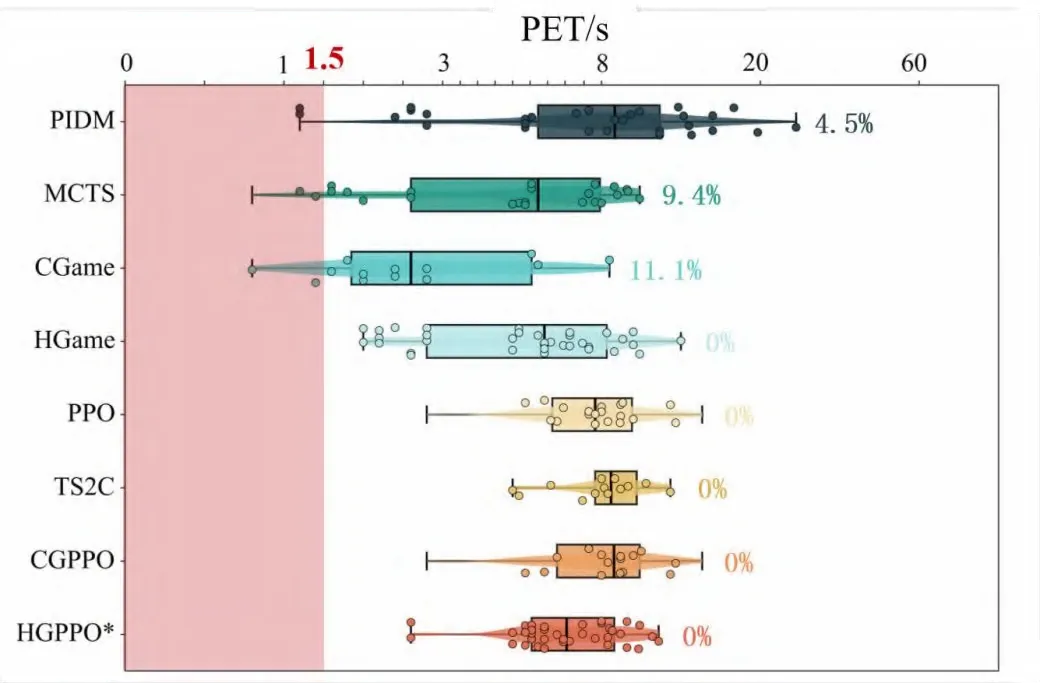
在无信号交叉口场景的仿真测试中,HGPPO算法碰撞率为0%,且未出现后侵入时间(PET)小于1.5s的高风险事件,相比PIDM(10%)、MCTS(15%)、PPO(40%)等方法,安全保障能力大幅提升。

表1不同协同算法碰撞率

图4 不同协同决策算法下PET分布

3.效率与实时性兼顾

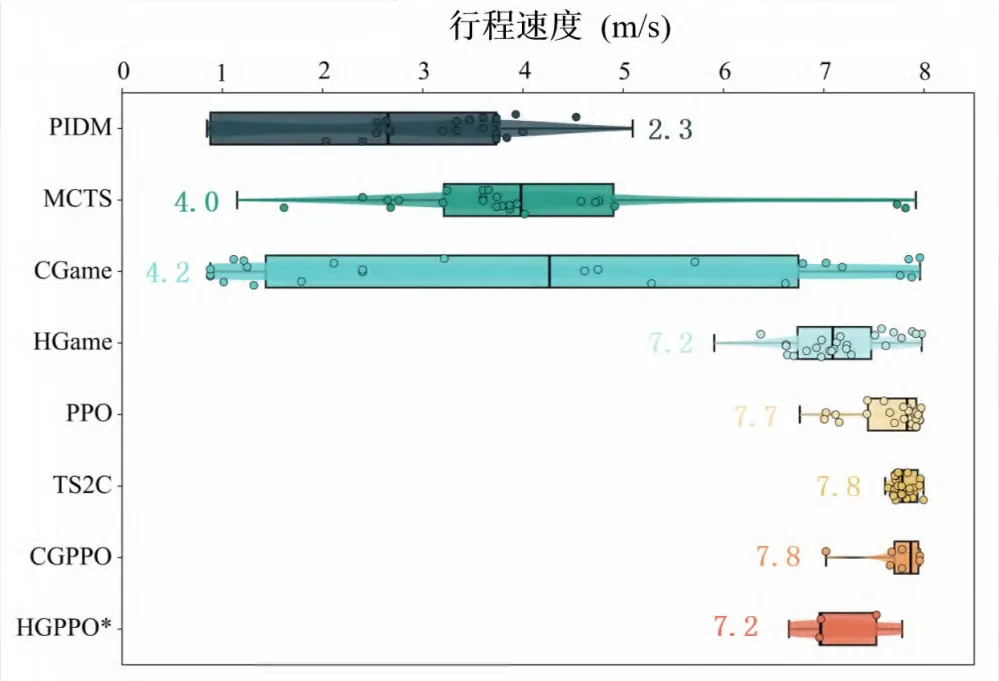
 选取平均行程速度作为衡量算法效率的重要依据,绘制了不同方法的平均行程速度分布。结果表明,HGPPO保持低碰撞率的同时,速度接近PPO、TS2C等强化学习方法,且显著高于PIDM、MCTS等基于规则的方法,体现安全性与效率的平衡。

图5 不同协同算法下行程速度分布对比

4.适配异质人类驾驶员

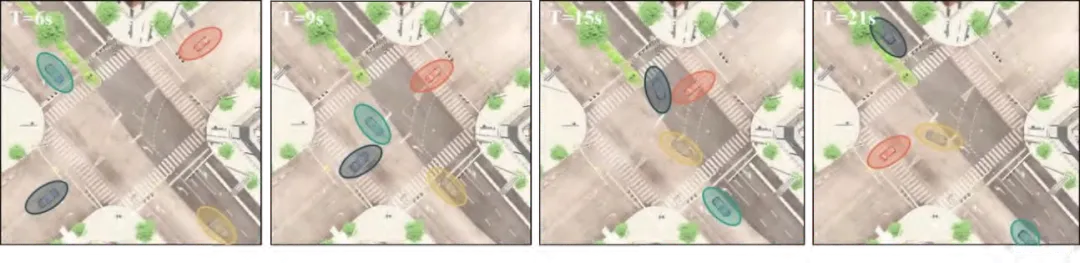
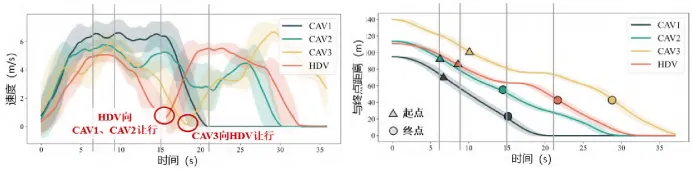
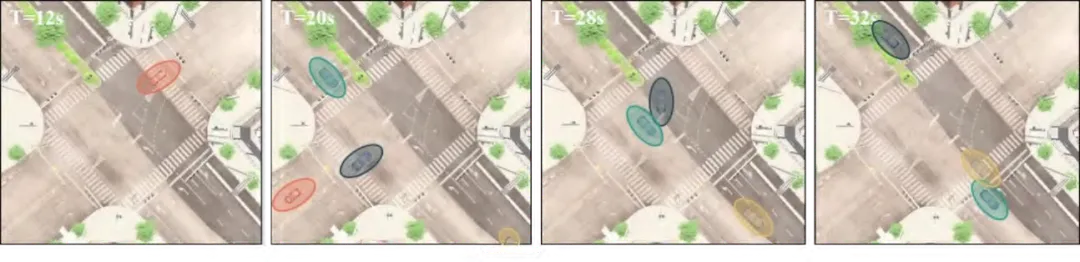
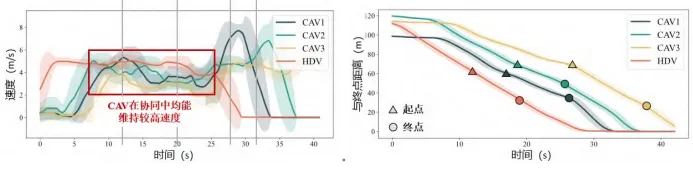
通过硬件在环与驾驶人在环测试平台,验证了算法对不同驾驶风格的适应性:面对保守型驾驶人时,能动态调整通行次序保障顺畅通行;遭遇激进型驾驶人时,可提前规划让行策略,避免碰撞的同时维持较高通行效率。为此分别展示保守型驾驶人、激进型驾驶人的实时交互数据,包括所有车辆的实时位置图、速度图和与终点的距离图。

图6 保守型驾驶人实时交互图

图7 激进型驾驶人实时交互图

Part 05

 结论与展望

本研究提出的人机混驾协同决策框架HGPPO,通过层次博弈刻画人类异质性,再借助近端策略优化实现实时最优决策,为解决自动驾驶在开放道路中与人类混行的核心难题提供了一条有效的技术路径。该框架不仅显著提升了无信号交叉口等冲突场景下的通行安全与运营效率,更增强了自动驾驶车辆对异质人类驾驶行为的泛化与协同能力。

未来研究将进一步拓展算法的适用场景,将横向路径规划如车道选择、转向策略等纳入决策空间,并结合全局交通流优化目标,实现个体决策与整体效率的协同提升,推动智能交通系统向更安全、高效、智能的方向发展。

-END-

山东科技大学国家

发展规划研究中心

关注发展态势
谋远健行 惟真求新

图片|来源网络

文稿|张子岩

编辑|杜晓艳

审核|张明玥

最新文章

随机文章