一、研究背景与动机
1.1 技术趋势:MLLM落地自动驾驶的机遇
多模态大语言模型(MLLMs)已深度融入自动驾驶(AD)系统,形成AD-MLLMs技术路线。这类模型可端到端完成场景理解、行为预测、轨迹规划等全链路任务,凭借强泛化能力与可解释性,成为下一代自动驾驶的重要范式。
1.2 现存核心痛点(现有防护方案的缺陷)
当前AD-MLLMs在事故易发场景中极易输出危险决策,现有安全防护方案存在明显短板:
- 静态规则局限:主流防护依赖预定义静态约束(如“红灯停车”),仅针对单帧场景,无法对持续演化的交通交互做时序安全推理,面对行人突然横穿、车辆切入等动态风险鲁棒性极差;
- 强耦合性:部分方案(如SafeAuto)与特定MLLM主干模型深度绑定,迁移性差,无法通用适配不同AD-MLLMs;
- 粗暴拦截决策:多数方案直接否决危险动作,易过度保守,损害正常驾驶任务的完成度;
- 感知偏差传导:仅修复感知层错误,未从决策逻辑层规避时序累积的隐性风险。
1.3 本文核心动机
摒弃“静态交通规则约束”的传统思路,将自动驾驶安全定义为随交通交互历史演化的隐式马尔可夫逻辑状态,构建一套模型无关、时序感知、逻辑驱动的防护体系,在动态路况中预判潜在风险、柔性修正危险决策,同时保证驾驶任务性能不下降。
二、核心问题定义
- 研究目标:设计通用防护模块,对AD-MLLMs输出的原始危险动作做后处理,转化为安全动作,降低事故率且不牺牲任务表现;
- 输入:AD-MLLMs接收连续多模态观测(图像+文本指令)后输出的原始驾驶动作 ;
- 约束:防护模块不修改底层MLLM权重(模型无关)、基于时序历史推理风险、最小程度干预正常驾驶行为。
三、整体框架与三大核心模块(论文核心创新)
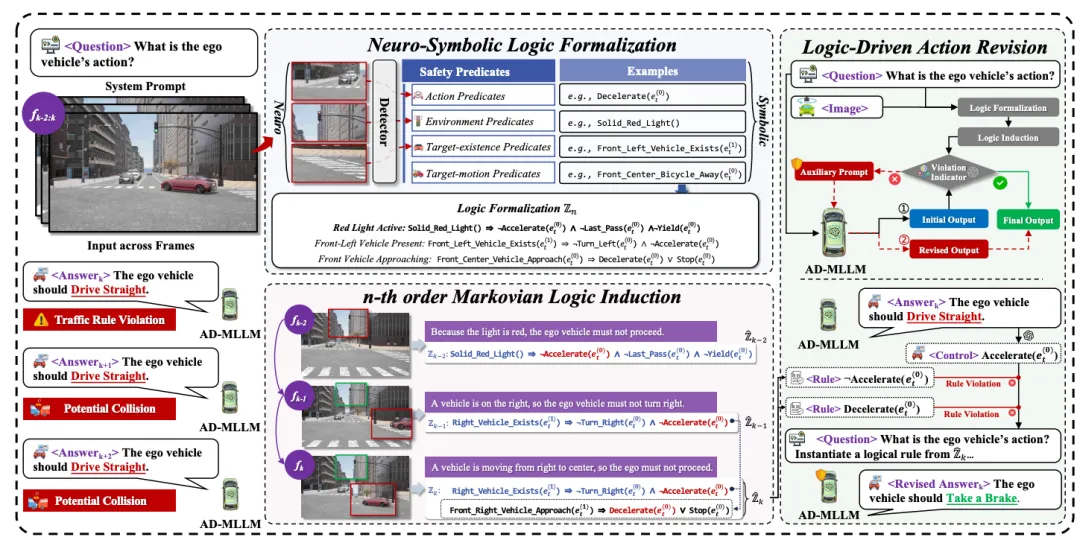
GUARDAD 整体分为神经符号逻辑形式化、n阶马尔可夫逻辑归纳、逻辑驱动动作修正三大串行模块,全程解耦于AD-MLLM主干,属于外挂式防护插件。
3.1 模块一:神经符号逻辑形式化(Neuro-Symbolic Logic Formalization)
该模块负责将神经网络感知结果转化为可解释的符号化安全谓词,搭建“感知→逻辑规则”的桥梁,是整个框架的基础。
- 实体提取从当前帧图像中解析出所有交通实体:自车(ego vehicle)、周边车辆、行人、骑行者等,并提取相对位置、运动方向、速度等几何/语义属性。
- 四类安全谓词(可解释布尔指标)论文将所有驾驶安全规则抽象为4类谓词,覆盖全场景安全要素:
| | |
|---|
| | Accelerate()(加速)、Turn_Right()(右转)、Decelerate()(减速) |
| | Solid_Red_Light() |
| | Front_Right_Bicycle_Approach() |
| | Front_Center_Bicycle_Away() |
- 瞬时安全逻辑状态 基于霍恩规则模板激活安全约束:当一组谓词同时成立时,触发对应安全规则。 示例逻辑规则:
Front_Right_Bicycle_Approach() ⇒ (Decelerate() ∨ Stop())(右前方有骑行者靠近 → 自车必须减速/停车)。 所有激活的约束集合构成当前帧**瞬时安全状态 **,仅反映单帧信息。
3.2 模块二:n阶马尔可夫逻辑归纳(n-th order Markovian Logic Induction)
这是论文最核心的创新点,解决静态规则无法处理时序动态风险的问题。
- 核心思想交通风险是时序累积的(如车辆逐步逼近、行人持续靠近),单帧状态无法预判隐患。基于n阶马尔可夫假设:当前安全状态仅由前n帧历史逻辑状态决定,与更早的历史无关。
- 规则库:带权重的时序安全规则集合,描述历史状态与当前风险的关联;
- 计算逻辑:通过对数线性势函数聚合多帧谓词证据,输出**时序优化后的精细化安全状态 **;
- 关键作用:推理出单帧无法观测的隐性风险(如“连续两帧行人向车道移动→即将横穿马路”)。
- 超参数设定实验验证最优参数:马尔可夫阶数 (融合前4帧历史),观测历史长度 ,兼顾推理精度与计算开销。
3.3 模块三:逻辑驱动动作修正(Logic-Driven Action Revision)
区别于传统“一刀切否决危险动作”的方案,该模块遵循最小干预原则,柔性修正决策。
- :AD-MLLM原始动作违反 中的安全约束,触发修正;
- 修正流程(无模型改动)不修改AD-MLLM权重,而是构造安全提示词追加到原始文本输入中,引导模型自主输出安全动作:
- 提示词生成器 将违规约束转化为自然语言提示(例:“检测到右前方骑行者靠近,请减速或停车,禁止右转加速”);
- 拼接新的多模态观测数据,重新输入原AD-MLLM;
- 优势完全解耦主干模型、干预程度可控、保留MLLM原生决策能力,避免过度保守。
3.4 运行案例(论文Figure 1典型场景)
- 原始动作:右转+加速(车速40mph,刹车踏板0%);
- 谓词激活:
Front_Right_Bicycle_Approach()(右前方骑行者靠近); - 最终修正动作:减速并停车(车速0mph,刹车踏板100%),规避碰撞。
四、实验设计与结果分析
4.1 实验基础配置
- 测试模型(AD-MLLMs):3款主流自动驾驶多模态大模型 DriveLM、Dolphins、EM-VLM4AD;
- 同类AD防护:SafeAuto(最接近的前置工作,静态规则);
- 通用具身智能防护:RoboFactory、Code-as-Monitor;
- VRU-Accident:事故易发场景数据集,核心评估事故率;
- DriveLM:通用驾驶场景数据集,核心评估任务性能;
- 安全指标:GPT事故率(GAR)、通义千问事故率(QAR)(数值越低越安全);
- 性能指标:GPT分数(GS)、通义千问分数(QS)(数值越高任务表现越好);
- 硬件环境:128核Intel Xeon CPU + 8×NVIDIA A800 80GB GPU。
4.2 核心实验结果
4.2.1 事故易发场景(VRU-Accident,核心场景)
- 安全提升:GUARDAD平均事故率下降32.07%(GAR)、35.54%(QAR),远超其他基线(其他方案平均降幅仅5%~7%);
- 性能提升:任务分数平均上涨6.85%(GS)、23.13%(QS),实现“降事故+提性能”双重收益;
- 对比结论:面向自动驾驶定制的防护方案(GUARDAD、SafeAuto)显著优于通用具身智能防护;SafeAuto对突发交通参与者(行人/骑行者)防护失效(剩余事故率20.99%),而GUARDAD降至12.67%,凸显时序推理的价值。
4.2.2 通用驾驶场景(DriveLM)
所有防护方案均有小幅性能提升,GUARDAD依旧最优(GS+3.00%、QS+3.07%),证明框架泛化性强,不局限于事故场景。
4.2.3 消融实验(模块有效性验证)
- 强制保守动作(直接停车):事故率更低,但任务性能明显下降(过度保守);
- GUARDAD柔性修正:平衡安全与性能,综合最优;
- 提示词生成器:GPT-4o作为提示词生成器效果最佳;
- 超参数验证:(4阶马尔可夫)、(2帧观测历史)为最优组合。
4.2.4 补充验证实验
- CARLA闭环仿真路线成功率从8.46%提升至12.32%,相对提升**45.60%**,仿真中成功规避右转碰撞事故;
- DriveLM+GUARDAD碰撞率:40%; 结论:大幅缩小AD-MLLM与人类驾驶员的安全差距;
- 对抗攻击鲁棒性针对CoA、ADvLM、CAD三类自动驾驶对抗攻击,GUARDAD仍可平均降低23.14%事故率,防御能力领先基线;
- 效率分析防护模块引入延迟极低:DriveLM总推理时延1.77s,Dolphins 3.54s,仅比原生模型慢0.4s左右,满足自动驾驶实时性要求。
4.3 失效案例分类分析
论文将失败案例分为4类,明确后续优化方向:
- 自车决策错误(EDE):无外部诱因的主观危险决策;
- 规则违规(RV):违反基础交通规则(红灯闯行等);
- 反应型参与者(RP):行人/车辆突然变向(GUARDAD在此类优化最显著);
- 其他(OT):谓词解析错误、指令歧义等; 现状:EDE与OT类失效仍占比较高,是未来主要优化方向。
五、论文核心贡献、优势与局限性
5.1 三大核心学术/工程贡献
- 理论创新:首次将自动驾驶安全建模为演化的马尔可夫逻辑状态,打破静态规则的固有范式,建立“神经+符号+时序”的安全推理新框架;
- 技术创新:提出神经符号逻辑形式化+ n阶马尔可夫逻辑归纳,实现多帧时序风险推理,精准捕捉动态交通隐患;
- 工程创新:模型无关外挂式防护+逻辑驱动柔性动作修正,无需微调AD-MLLM,兼顾通用性、安全性与任务性能,落地门槛低。
5.2 相较于传统方案的核心优势
5.3 局限性(论文自陈)
- 依赖感知精度:实体、谓词提取错误会传导为安全失效,受底层感知模型限制;
- 规则覆盖不全:现有谓词与逻辑规则无法覆盖所有自车主观决策错误;
- 额外计算开销:依赖外部大模型生成提示词,增加少量推理延迟;
- 对抗攻击仍有短板:面对高强度对抗攻击,事故率仍明显上升,防御能力有待加强。
5.4 未来工作方向
六、总结与行业价值
6.1 论文核心结论
GUARDAD 是一套面向自动驾驶多模态大模型的时序感知型安全防护框架,通过马尔可夫逻辑建模动态交通风险,结合神经符号推理与柔性动作修正,在不改动底层MLLM的前提下,大幅降低事故率,同时提升驾驶任务表现,在仿真、实车、对抗场景中均验证了有效性。
6.2 行业落地价值
- 落地成本低:模型无关设计,可作为通用插件部署在各类AD-MLLM自动驾驶系统中;
- 适配真实路况:针对国内复杂动态交通(行人乱窜、非机动车突发切入)有极强适配性;
- 平衡安全与体验:摒弃“为安全牺牲驾驶流畅度”的传统思路,更符合量产车需求;
- 范式参考:为“大模型+自动驾驶”的安全对齐提供了时序逻辑推理的全新技术路线,推动AD-MLLM从“能用”走向“安全可用”。
6.3 适用研究方向
该论文适合自动驾驶安全、多模态大模型对齐、神经符号AI、具身智能安全等领域的研究者参考,尤其为动态场景下大模型决策安全问题提供了可落地的解决方案。
链接:https://arxiv.org/pdf/2605.10386
 10个月宝宝每天需要喝多少奶粉?