为什么乘用车数据教不了自动驾驶巴士?不是不用,是用不了
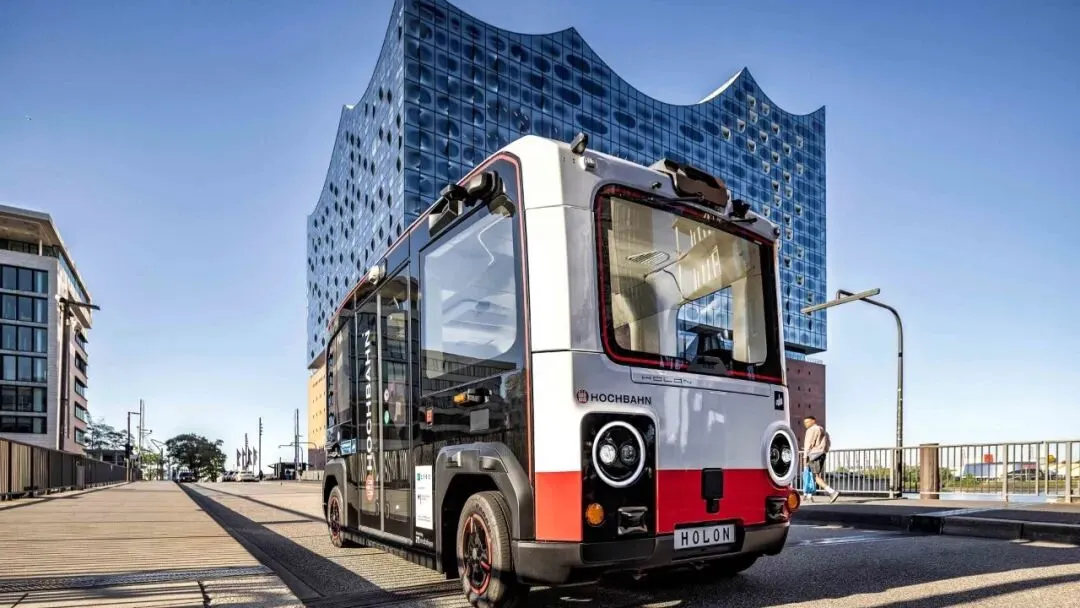
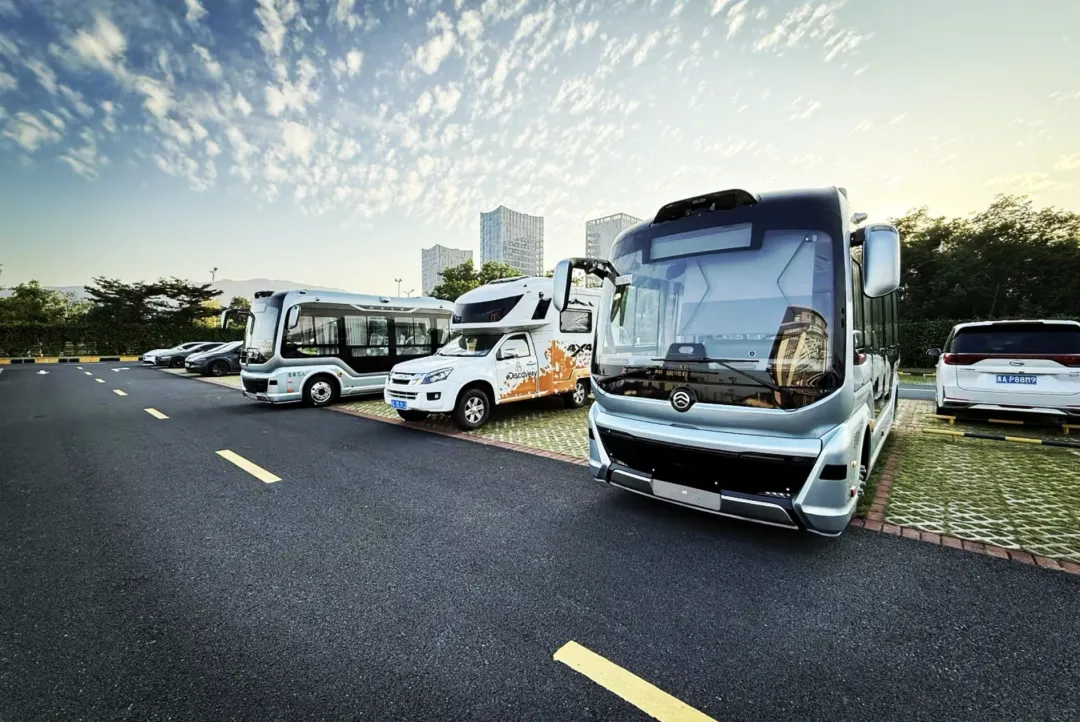
自动驾驶圈有一个很常见的“想当然”——乘用车跑得这么丝滑了,自动巴士驾驶不就是“换个壳”吗?把乘用车的模型和数据拿过来,套一下不就行了?这句话听起来很合理,甚至很“工程效率”。但现实往往更残酷:乘车的数据,真的救不了自动驾驶巴士。不是行业不想用,而是用不了 。因为自动驾驶巴士和Robotaxi(自动驾驶出租车)最大的差异,从来不是“车大一点”,而是——它拥抱的是一个不同的物理世界。 这个世界里,控制更难、视角更难、责任完全更重。你可以把它理解成:乘车自动驾驶就像“轻量级运动员”,而自动驾驶巴士则属于“满载的重型机械”。人类司机能开小轿车,但开不了大公交。第1道鸿沟:巴士不是“放大版轿车”,是“惯性怪物”很多人把巴士理解成“大车”,但对于自动驾驶系统来说,它配备了一个关键词: 惯性 。乘用车动作灵活,刹车距离短。它可以“轻微踩一下刹车”会使风险压住。但巴士不一样:这意味着同一个危险场景——在乘用车上可能只是一次轻轻的点刹,在巴士上可能只是一次“必须提前很久做决策”的控制题。控制更难的本质是:你不能依靠反应,你必须依靠预测。而“预测”是自动驾驶最贵的能力之一。所以你会看到自动驾驶巴士的驾驶策略天然更保守:它必须更早判断、更早停止、更早规划,否则一脚刹车也救不回来。这就是为什么很多人坐自动驾驶巴士会觉得它“有点慢、有点慢”——不是它不聪明,而是它背负的物理约束更重。第2道鸿沟:巴士的盲区更大,传感器方案根本不是一套东西自动驾驶最怕什么?不是路上车多,而是 看不全 。而巴士有一个天生的劣势: 盲区更大 。这会得出一个非常关键的结论:自动驾驶巴士的传感器型号、位置、角度、数量和配置,与乘车差异明显。因此:乘用车的“眼睛”长得那个位置,巴士不行;乘车用那套视角采到的数据,巴士也不适用。这就是核心问题——你拿乘车数据来训练巴士,就像拿手机自拍视频教监控摄像头识别世界一样。虽然都叫图像,同样是道路,但视角不一样:一个是低位、活泼、吵闹得很;一个是高位、遮挡多、盲区重、车身长带来的动态变化复杂化。所以乘用车的数据,不是“不够多”的问题。在AI世界里,有一个更有意义的词:数据分布方差(distribution shift)。一旦分布不一致,结果就是:- 因为模型学到的是“乘用车的世界”,而不是“巴士的世界”
这就是为什么自动驾驶巴士必须有属于自己的数据集——而不是指望“借用乘用车的数据红利”。第3道鸿沟:责任更重——巴士不是“车”,是公共安全资产如果你要一句话讲明白“巴士为什么特殊”,那就是:乘用车出事,是一个人的事;巴士出事,是一车人的事。巴士运载人数是乘用车的数倍,这将安全要求直接推到了一个更“严格要求”的级别。你可以想象一次急刹:乘用车里你自己点了点头,骂两句就过去了,巴士里可能有老人站不稳、孩子摔倒、携带物品受损、投诉、舆情甚至事故责任。所以巴士自动驾驶的安全要求,不是线性增加,而是“指数级上升”。这也是为什么很多城市会更严格地推进巴士自动驾驶——它不仅仅是技术项目,更是公共治理项目。于是你会得到一个非常现实的结论:乘车数据即使能“训练出驾驶能力”,也不一定能训练出“公共安全级别的稳定性”。乘用车数据不能迁移到巴士,巴士必须自己有一套数据体系- 责任更重 → 安全阈值更高 → 需要更严格要求的稳定性验证
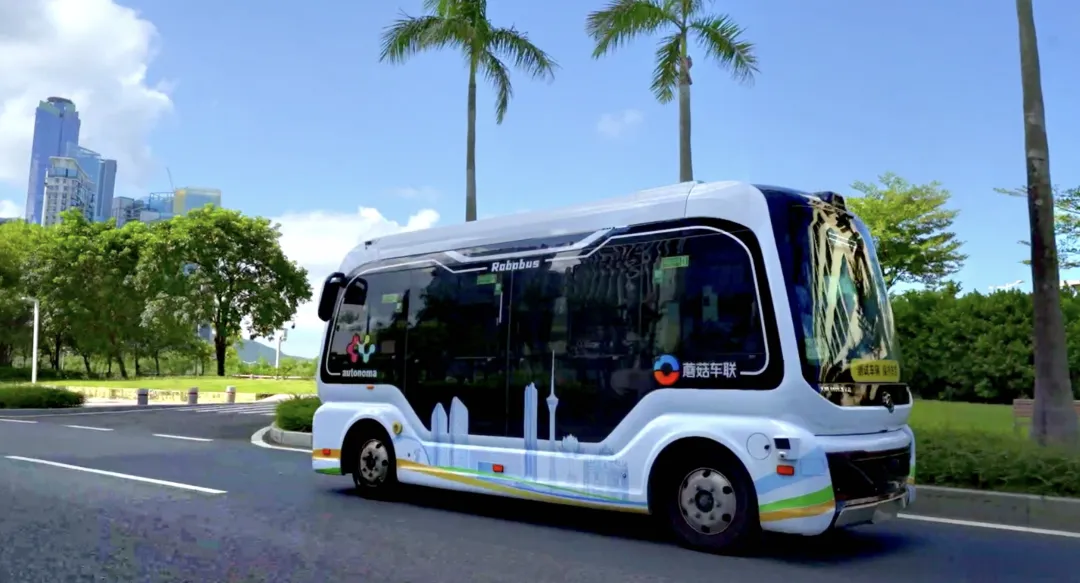
因此乘用车数据无法直接迁移到自动驾驶巴士,必须依赖更全面、更丰富的巴士数据集。你没有一套独特的数据资产,并把数据转化为进化能力的闭环系统。如果说自动驾驶行业早期拼的是“谁能跑”,那么巴士规模化拼的就是“谁能持续变强”。在这条路径上,蘑菇车联网的策略其实很清晰:蘑菇车联基于“视觉为主+固态激光雷达” 的多模态数据体系,为巴士场景构建更稳定的数据输入:这套组合并不是炫技,而是公交场景里最现实的工程选择:既能上量,也可以兜底。更关键的是:蘑菇车联并没有“拿乘车数据凑”,而是直接建立了巴士数据基础:基于视觉与固态激光雷达的多模态数据集,构建全球最大的巴士数据集5)最关键的一步:巴士靠的不是规则足够,而是数据闭环许多自动驾驶系统最容易走向一种“怪循环”:出问题 → 加规则 → 又出问题 → 加上规则 → 系统增加复杂性 → 增加不可控接管风险事件、不舒适体验、潜在数据 自动上传云端 → 仿真与数字孪生复现 → 生成训练数据/场景 → 注入训练 → 验证部署形成了“发现问题-数据生成-模型迭代-验证部署”的高效闭环。这条闭环最重要的价值是:它让系统不再依赖人工规则,而是通过数据驱动持续优化,逐步向“驱动认知”演进。那么回到开头的问题——为什么乘用车数据教不了自动驾驶巴士?答案很简单,也很硬核:因为巴士不是乘用车的放大版。 它是一套完全不同的控制系统、决策系统与安全系统。它需要自己的数据,自己的闭环飞轮,自己的进化路径。自动驾驶巴士的重要性,很多人都低估了。但它的优势也很明显:所以它不是“简单”,而是更容易从“能跑”走向“可复制、可运营、可规模化”。未来自动驾驶真正跑出来的,不一定是最会炫技的那条路线,而是最会做系统、最会做闭环、最会用数据把世界吃掉的那条路线。
 10个月宝宝每天需要喝多少奶粉?