安霸的CV3-AD系列是目前市面上最激进的自动驾驶域控芯片之一。5nm工艺、12核A78AE、750 eTOPS等效算力、24路摄像头接入、ASIL-D安全岛——这些参数单拎出来任何一个都足够亮眼,但安霸真正的厉害之处,在于它把ISP、AI加速、雷达融合、功能安全这几个最难啃的骨头,塞进了一颗芯片里,而且功耗还比GPU方案低得多。CV3-AD不是单颗芯片,而是一个家族。安霸的策略很聪明:先打磨出最高规格的CV3-AD685,把架构、SDK、工具链全部跑通,然后向下裁剪出CV3-AD655和CV3-AD635,分别对应城市NOA和高速NOA。三颗芯片共用同一套CVflow 3.0架构和软件栈,车企开发一次,可以覆盖从走量车型到旗舰车型的全产品线。
这个"向下裁剪"的思路值得玩味。安霸没有为每个细分市场重新设计芯片,而是通过屏蔽部分NVP核心、减少CPU核数、裁剪接口数量来实现SKU差异化。这样做的好处是研发成本可以摊薄,车企的软件开发也可以复用。大陆集团已经宣布基于CV3-AD系列开发域控平台,预计2027年量产,走的正是这条路线。
CV3-AD的核心是第三代CVflow架构。和英伟达Orin那种"一个大GPU包打天下"的思路不同,安霸把AI计算拆成了两个专门的引擎。一个叫NVP(Neural Vector Processor),专门跑神经网络,擅长YOLO、BEV、Transformer这些主流自动驾驶模型。另一个叫GVP(General Vector Processor),负责传统计算机视觉算法和4D毫米波雷达的信号处理,比如稠密光流、立体视觉匹配、雷达点云生成。
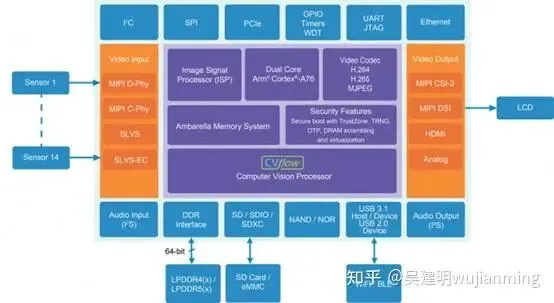 ▲ CV3-AD系列架构框图:NVP与GVP双引擎并行,ISP与CVflow硬件直连
NVP和GVP的分工非常关键。自动驾驶系统里,AI推理和几何计算是两种完全不同的负载。AI推理是存储密集型的,需要大量权重数据;几何计算是计算密集型的,需要大量浮点运算。如果把它们塞到同一个引擎里,必然互相抢资源。安霸的做法是让NVP和GVP各自独立运行,数据通过自研内存子系统共享,不需要CPU来回搬运。
更关键的是,CVflow 3.0支持Transformer和BEV架构的原生加速。现在主流的端到端自动驾驶方案,几乎都在往BEV+Transformer迁移。安霸在硬件层面做了针对性优化,使得这些模型的运行效率远高于在通用GPU上跑。官方数据说CV3-AD685的AI性能是竞品的3倍左右,功耗却大幅低于竞品,这个差距很大程度上来自架构层面的专用化设计。
CVflow 3.0的关键设计:
· NVP:专精CNN/Transformer推理,支持INT4/INT8量化
· GVP:专精浮点几何计算和4D雷达信号处理
· 双引擎并行,互不阻塞,共享统一内存子系统
· 硬件直连通路:ISP输出直接喂给CVflow,无需CPU介入
大算力芯片最怕什么?内存墙。算力再强,如果数据供不上,也是干瞪眼。很多AI芯片的做法是堆大缓存,但缓存面积大、功耗高,而且软件还得专门优化命中率,否则缓存 miss 一次,性能直接崩盘。
安霸的解法叫Partial Buffer架构。它不是靠大缓存来减少DRAM访问,而是在CVflow内部设计了一套高效的局部缓冲机制,让数据在NVP/GVP和DRAM之间"精准投喂"。配合LPDDR5/LPDDR5x内存控制器(最高256位位宽,速率8Gb/s),CV3-AD的内存带宽利用率非常高。官方说法是,在运行相同智驾算法时,CV3-AD对CPU和内存带宽的占用远低于GPU方案,这意味着芯片可以把更多资源留给实际计算,而不是浪费在数据搬运上。
CV3-AD685最多支持24路摄像头接入,靠的不是简单的接口堆叠,而是ISP的多通道并行架构。每一路摄像头都有独立的曝光控制、HDR融合和噪声抑制管线。安霸的ISP强项在恶劣光线——支持多曝光HDR融合,能把亮部和暗部细节同时保留下来,0.01 Lux的极暗环境下依然能输出可用图像。
更值得关注的是AI-ISP。传统ISP的参数是固定的,调好了就按流程走。但安霸在CVflow里跑了一个神经网络,实时分析当前场景的光照、运动、噪声特征,然后动态调整ISP参数。夜间自动增强降噪,高速运动自动缩短曝光,这种"ISP+AI"的混合架构让图像质量比纯硬件ISP提升了一个档次。对于自动驾驶来说,ISP不是"锦上添花",而是"生死攸关"——如果ISP在逆光或夜间场景下把行人漏掉了,后面的AI再强也救不回来。
安霸在2021年收购了Oculii,这笔收购的回报在CV3-AD上体现得淋漓尽致。Oculii的核心技术是用AI算法替代传统雷达的硬件天线阵列。传统4D成像雷达需要上千个MIMO天线,Oculii把它压缩到14个(6发8收),通过AI算法在芯片内部重建高分辨率点云。
这个方案的革命性在于"中央集中式处理"。传统雷达在边缘端就有自己的处理器,先做一次预处理,再把结果传给域控制器。安霸的做法是直接把雷达的原始ADC数据拉到CV3-AD里,由GVP统一做信号处理和点云生成,然后和摄像头的视觉数据在NVP里做深度融合。这样做的好处是融合质量更高——原始数据的信息量远大于预处理后的结果,而且时间同步更容易保证。
 ▲ 中央集中式架构:雷达原始数据直接进域控,与视觉数据在芯片内部深度融合
安霸声称这种架构让雷达性能提升了100倍以上,数据传输带宽只需要竞品的六分之一。虽然"100倍"这个数字可能有营销成分,但中央集中式的思路确实代表了行业趋势——传感器越来越便宜,算力越来越集中,边缘预处理的价值在下降。
做车规芯片,功能安全是硬门槛。CV3-AD的架构在功能安全上下了不少功夫。整个芯片分为两个岛:Processing Island(处理岛)和Safety Island(安全岛)。处理岛跑主程序,目标ASIL-B;安全岛跑监控程序,目标ASIL-D。
安全岛的核心是一对双核Cortex-R52,运行在Lockstep模式。Lockstep的意思是两颗核跑完全相同的指令,每周期对比输出,一旦发现不一致就立即触发故障处理。R52本身也是ARM专门为汽车安全设计的核心,支持ECC和双核锁步。安全岛独立于主系统运行,负责监控整个芯片的健康状态,包括温度、电压、时钟完整性,以及主程序的运行状态。
CV3-AD功能安全架构:
· 处理岛:12× A78AE + NVP/GVP + ISP,目标ASIL-B
· 安全岛:2× Cortex-R52 Lockstep,目标ASIL-D
· DRAM ECC保护,中央错误处理单元(CEHU)统一管控
· 硬件安全模块(HSM):支持非对称/对称加密、真随机数生成器、OTP
此外,CV3-AD还集成了一个硬件安全模块(HSM),提供隔离的计算环境,支持加密加速、DRAM加扰、虚拟化等功能。在软件定义汽车时代,OTA升级和云端通信越来越频繁,HSM是防止黑客攻击的最后一道防线。
CV3-AD系列集成了Imagination的IMG BXM GPU,这不是为了打游戏,而是为了3D环视(AVM)和感知结果的可视化渲染。L2++和L3级别的自动驾驶,需要让驾驶员清楚地看到系统"看到了什么"——周围车辆的位置、规划的路径、识别的障碍物。一个流畅的3D渲染界面,直接影响驾驶员对系统的信任度。
视频编解码模块支持H.264/H.265/MJPEG,CV3-AD685可以处理多路8MP视频的实时编码。对于需要行车记录仪、哨兵模式、远程监控的车型来说,这个模块可以省掉一颗独立的视频编码芯片。安霸的SmartHEVC技术还会根据AI检测到的感兴趣区域动态分配码率——有行人或车辆的区域给高码率,天空草地给低码率,既保证关键细节又节省存储空间。
CV3-AD全系采用三星5nm车规工艺。5nm带来的不只是性能提升,更重要的是功耗控制。安霸官方说,和竞品大算力GPU方案相比,CV3-AD在电池容量相同的情况下,可以让电动车续航里程增加30%以上。这个数字听起来夸张,但背后的逻辑是成立的——GPU方案动辄上百瓦的功耗,在电动车上直接吃掉续航里程;CV3-AD的功耗低一个数量级,散热设计也简单得多,不需要复杂的水冷或风冷。
说到底,CV3-AD的架构设计体现了一个清晰的思路:自动驾驶域控芯片不是拼算力数字,而是拼系统效率。安霸没有走GPU通用计算的路线,而是用CVflow专用架构把AI推理、几何计算、雷达信号处理、ISP、视频编码全部打通,再用5nm工艺把功耗压到极致。这种"全栈自研+专用架构"的模式,和当年苹果做M系列芯片的思路有几分相似。
对于做芯片设计的工程师来说,CV3-AD提供了一个很好的观察样本:如何在功能安全、信息安全、多传感器融合、大算力AI这几个互相矛盾的需求之间找到平衡。安霸的答案是——用架构创新来换效率,用先进工艺来换功耗,用软件兼容来换生态。这套组合拳打下来,CV3-AD能在自动驾驶芯片的红海里杀出一条血路,也就不奇怪了。