这是一篇针对面向人的协同驾驶(Human-Oriented Cooperative Driving, HOCD)技术的深度技术分析文章。本文在原有基础上进行了大幅度的内容扩充,深入拆解了其背后的数学模型、算法逻辑及行业价值。
深度:如何打破自动驾驶的“人机博弈”?西安交大 HOCD 协同驾驶框架全解析
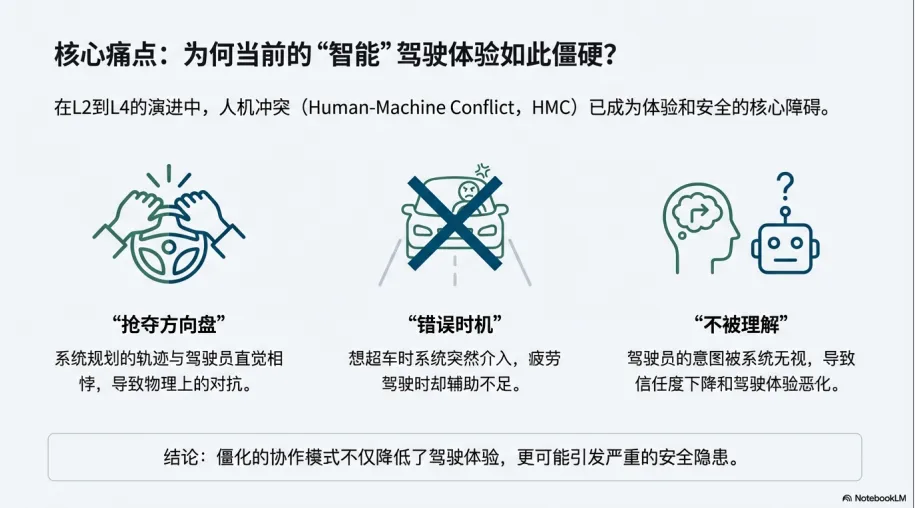
在自动驾驶技术从 L2 向 L4/L5 进化的征途中,一个被长期忽视的暗礁正变得日益凸显:人机冲突(Human-Machine Conflict, HMC)。当算法认为应该制动,而人类驾驶员倾向于加速,或者系统规划的轨迹完全背离了人的驾驶直觉时,这种僵硬的协作模式不仅降低了驾驶体验,更可能引发严重的安全隐患。
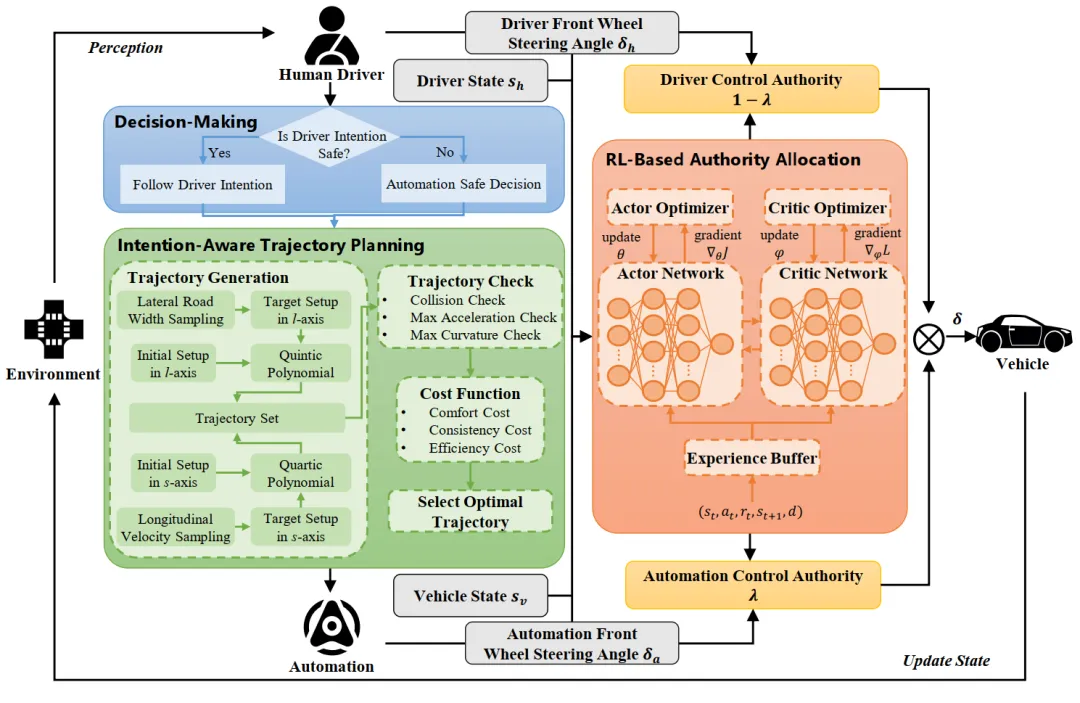
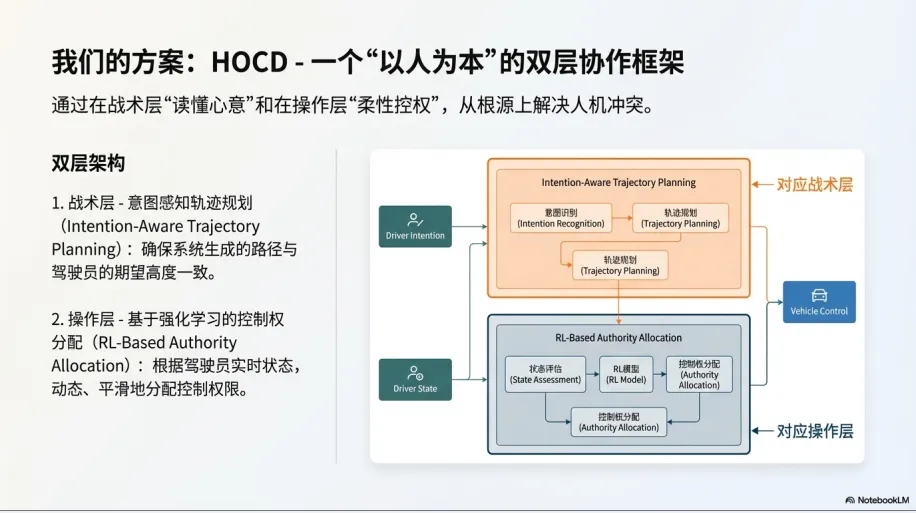
近日,来自西安交通大学与南洋理工大学的研究团队发表了名为 HOCD(Human-Oriented Cooperative Driving) 的研究成果。该方案通过意图感知轨迹规划与强化学习控制权分配的双层架构,将协同驾驶的冲突率大幅降低,为“单车智能”向“协作智能”的跨越提供了关键技术路径。
一、 协同驾驶的三个维度:为什么传统方案行不通?
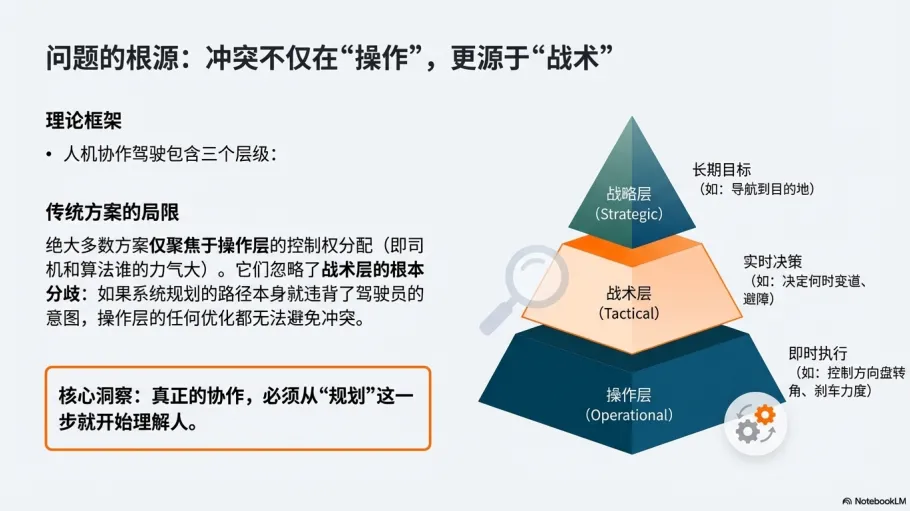
研究指出,人机协作驾驶是一个涵盖战略层(Strategic)、战术层(Tactical)和操作层(Operational)的层级系统。
传统方案的局限性: 过去的研究大多只聚焦于操作层的控制权分配(即司机和算法谁出的力多),却忽略了战术层的轨迹规划。如果系统规划出的路径本身就与司机的意图相悖,那么无论在操作层如何分配权限,冲突都不可避免。HOCD 的核心突破就在于:它让系统在动脑筋规划路径时,就先学会了“读懂”司机的意图。
二、 战术层深度解析:意图感知的轨迹规划
HOCD 在战术层引入了意图感知(Intention-Aware)机制,确保系统规划的轨迹与人类期望高度对齐。
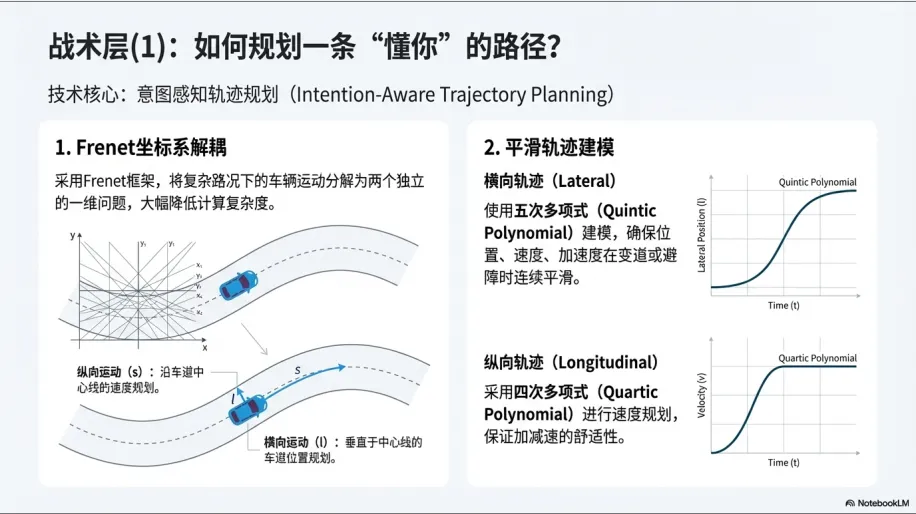
1. Frenet 坐标系下的解耦建模
为了提高计算效率,HOCD 采用了 Frenet 框架,将车辆在复杂弯道上的运动分解为纵向(沿参考线 )和横向(垂直参考线 )两个维度。这种处理方式将复杂的二维平面规划简化为两个一维优化问题,极大降低了计算开销。
- 横向轨迹规划: 使用五次多项式(Quintic Polynomial)建模,通过初始状态(位置、速度、加速度)和目标状态的 6 个约束条件,确保变道或避障过程的平滑性。
- 纵向轨迹规划: 考虑到匀速行驶需求,采用四次多项式(Quartic Polynomial)进行速度规划。
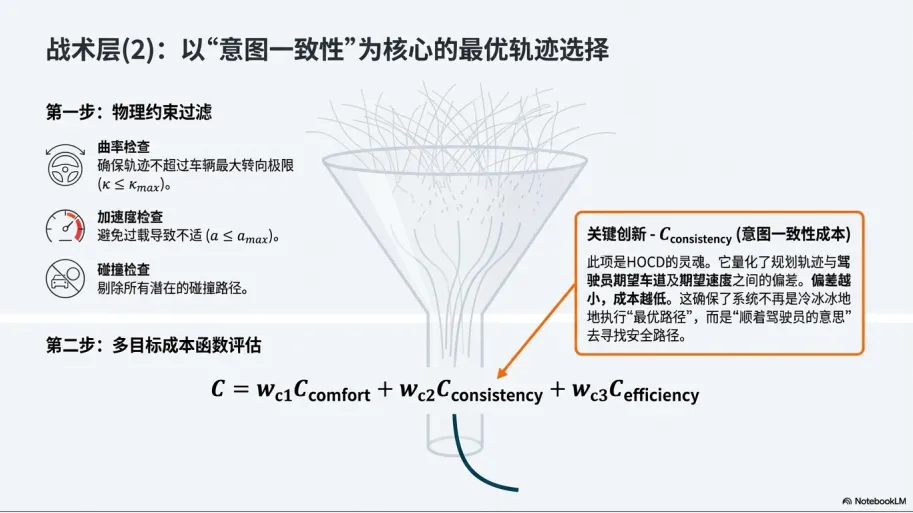
2. 三重约束过滤机制
生成候选轨迹集后,系统通过严苛的物理约束进行筛选:
- 曲率检查(Curvature Check): 确保轨迹曲率 不超过车辆的最大转向物理极限 。
- 加速度检查(Acceleration Check): 避免产生导致乘客不适或车辆失控的过载 。
- 碰撞检查(Collision Check): 利用圆形边界盒模型,实时计算车辆与障碍物间的几何距离,剔除所有潜在碰撞路径。
3. 核心成本函数:意图一致性
在最优路径筛选阶段,HOCD 引入了创新的成本函数 :
其中 (一致性成本) 是 HOCD 的灵魂。它计算规划轨迹与司机期望车道及期望速度的偏差,偏差越小权重越高。这保证了系统不再是冷冰冰地执行避障,而是“顺着司机的意思”去避障。
三、 操作层深度解析:基于 PPO 算法的动态控制权分配
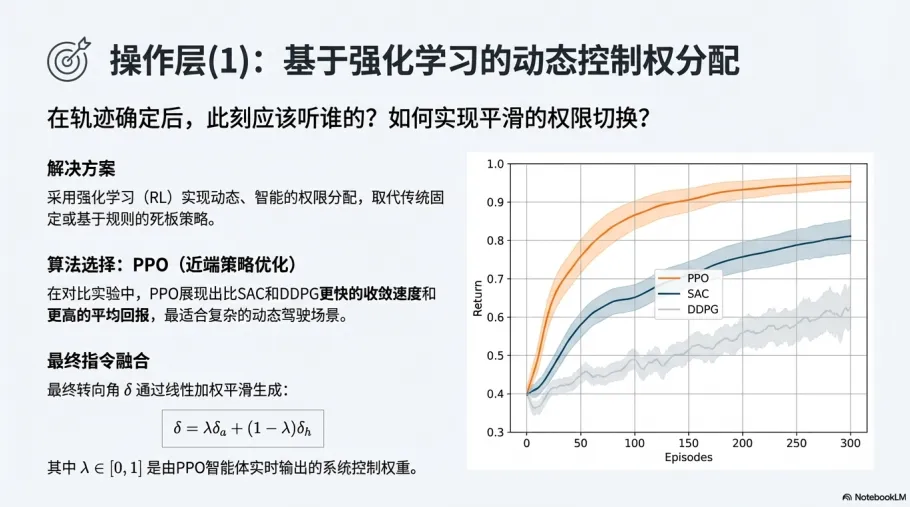
在确定了最优轨迹后,系统需要在操作层实时决定:此刻到底该听谁的?
1. 强化学习:从固定逻辑到动态博弈
传统的固定权限分配(FACD)或基于规则的方案(DCCD)往往过于死板,无法应对司机分心或紧急避险等动态场景。HOCD 选择了 PPO(近端策略优化)算法,因为在对比实验中,PPO 的收敛速度和平均回报率显著优于 SAC 和 DDPG 算法。
2. 状态空间与多目标奖励设计
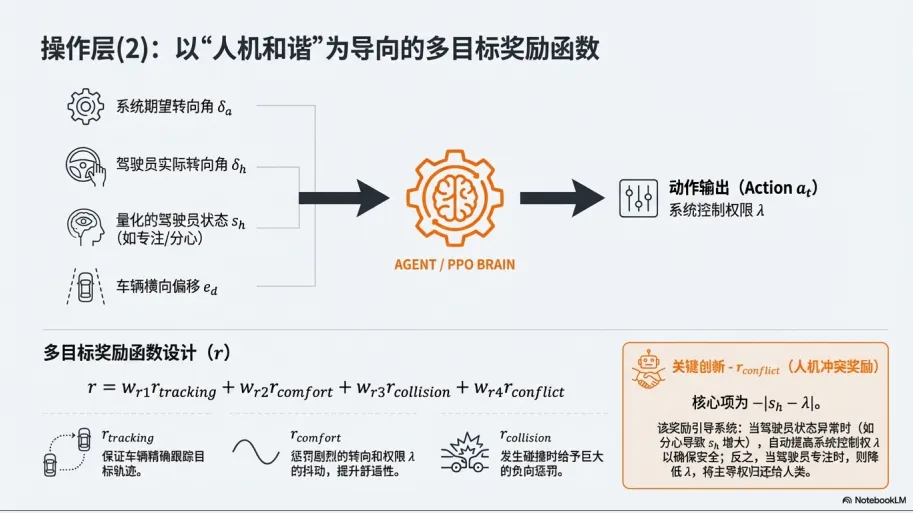
RL 代理实时观测的状态向量 包括:算法期望转向角 、司机实际转向角 、量化的司机状态 (如专注、分心)以及车辆的横向偏移 等状态 。
其奖励函数(Reward Function)实现了多维平衡:
- 跟踪奖励(Tracking): 确保车辆不偏离目标轨迹。
- 人机冲突奖励(Conflict): 关键项 ,引导系统在司机状态异常时(如分心, 变大)自动提高算法控制权 ,反之则归还主导权。
- 舒适度奖励: 惩罚权限 的剧烈抖动,防止“抢夺方向盘”的顿挫感。
3. 线性加权融合逻辑
最终执行的转向指令 通过线性加权实现平滑切换:。其中 ,实现了从纯人工驱动到全自动驾驶的连续、无感过渡。
四、 实验数据:协同驾驶对“单车智能”的提升
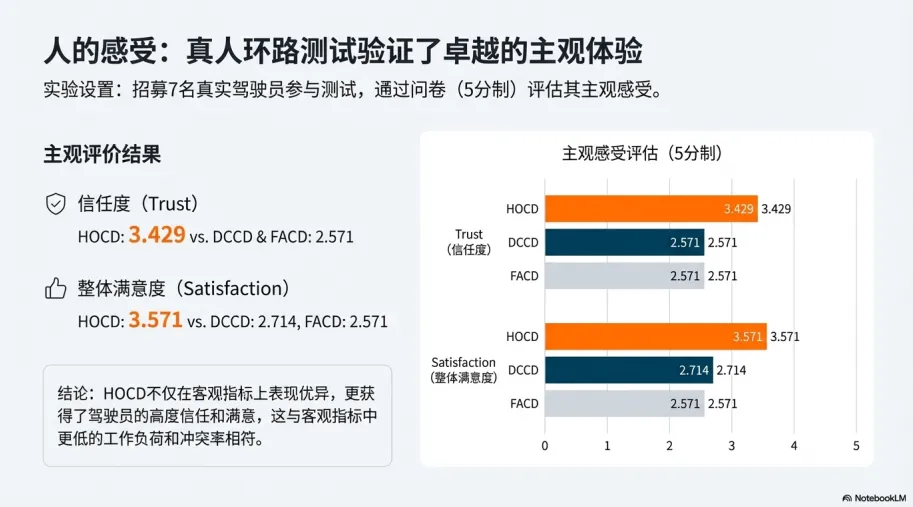
HOCD 在 CARLA 仿真环境及真人环路(Human-in-the-loop)测试中展现了压倒性的优势:
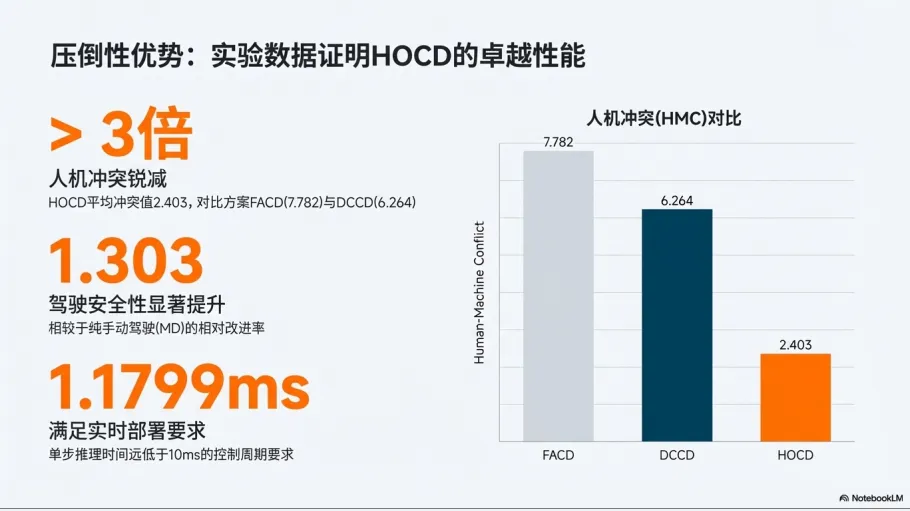
- 冲突率暴降: 在各种司机状态下,HOCD 的平均人机冲突值为 2.403,而传统固定权限方案(FACD)高达 7.782,性能提升超 3 倍。
- 安全性提升: 相比纯手动驾驶(MD),HOCD 在安全性指标上的相对改进率达 1.303,显著增强了单车在复杂路况下的边界保护能力。
- 计算高效性: 尽管引入了复杂的神经网络,但其单步推理时间仅为 1.1799ms,远低于自动驾驶控制周期要求的 10ms,完全满足实车部署需求。
五、 应用价值与未来趋势:迈向“人马合一”
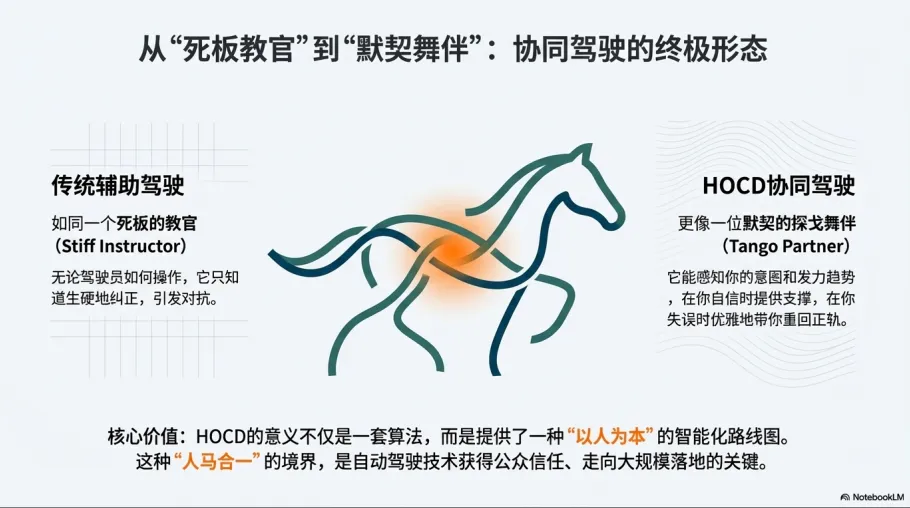
HOCD 的意义不仅在于一套算法,而在于它提供了一种以人为本(Human-Oriented)的智能化路线图:
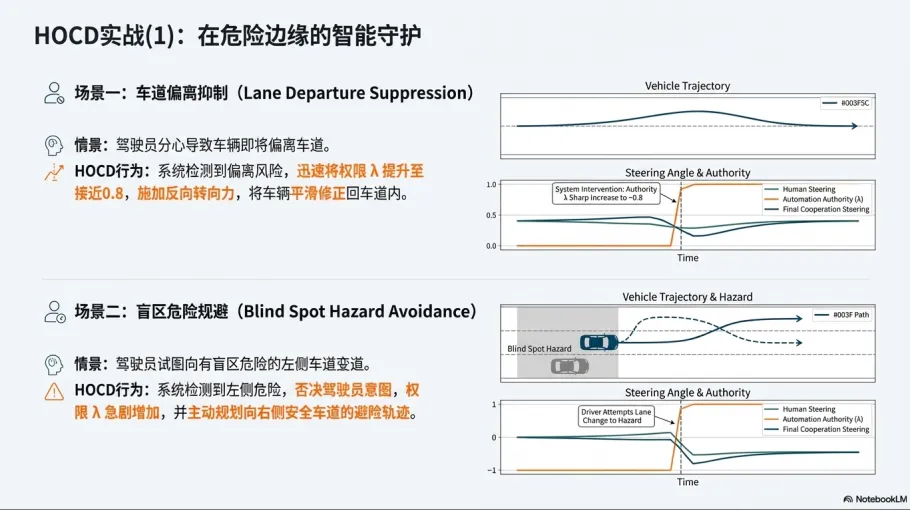
- 分心抑制: 当司机因疲劳导致车辆偏离时,权限自动提升至 0.8,平滑修正轨迹。
- 盲区补偿: 司机试图在盲区有车时变道,系统通过提高权限强制维持车道,并规划新避险路径。
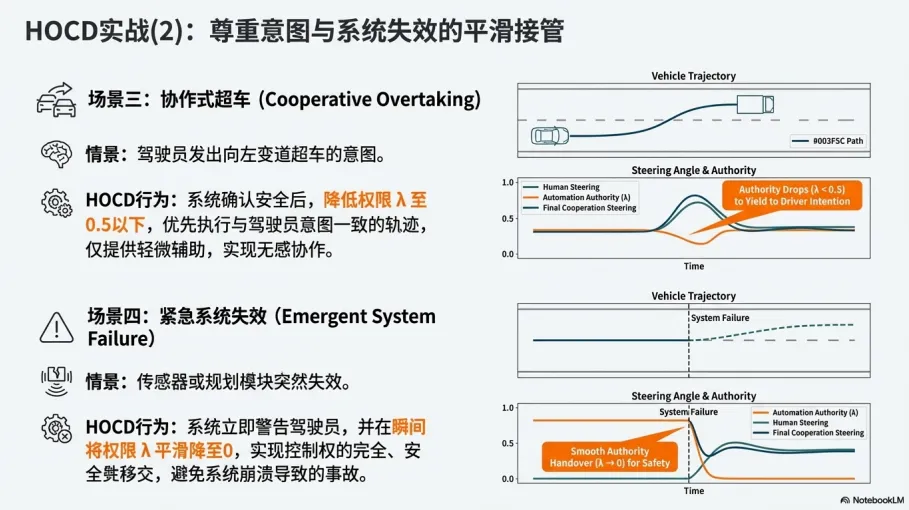
- 系统失效兜底: 当传感器或规划模块突然失效时,系统能迅速将权限降至 0,实现控制权的平滑移交,避免系统崩溃导致的事故。
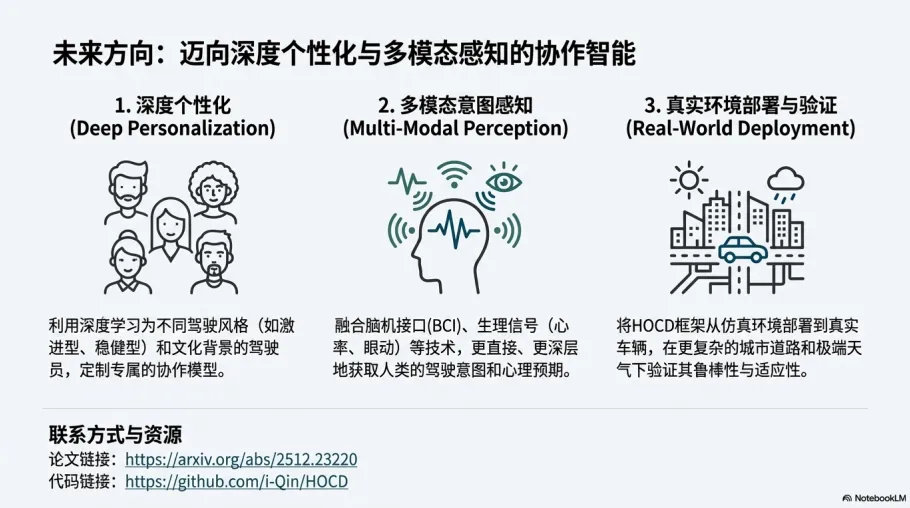
- 深度个性化: 利用深度学习为不同驾驶风格(激进、稳健、文化差异)定制专属的协作模型。
- 多模态感知: 结合脑机接口(BCI)或生理信号(如心率、眼动)直接获取人类更深层的心理预期。
- 真实环境部署: 方案将从仿真器走向真实城市道路,验证其在复杂极端天气和非结构化道路下的鲁棒性。
总结:协同驾驶并非单车智能的替代品,而是其最高级形态。HOCD 技术框架通过在战术层“读懂心意”和操作层“柔性控权”,解决了人机共驾中最大的摩擦力。
技术隐喻:传统的辅助驾驶像是一个死板的教官,无论你如何操作,它只管拉扯你的方向盘;而 HOCD 协同驾驶则像是一位默契的探戈舞伴,它能感知你的每一个发力趋势,在你自信时提供轻微支撑,在你失误时优雅地带你重回舞池中心。这种“人马合一”的境界,才是自动驾驶技术真正获得公众信任、走向大规模落地的终极密钥。
 10个月宝宝每天需要喝多少奶粉?