当前位置:首页>自动驾驶>写在从“自动驾驶”转行“具身智能”一周年

写在从“自动驾驶”转行“具身智能”一周年

  • 2026-08-25 18:07:26
写在从“自动驾驶”转行“具身智能”一周年
本文约7,400字,建议收藏阅读
作 者 | aFakeProgramer
出 品 | 汽车电子与软件

一个老汽车人的血泪观察

前 言

2025年夏天,我交了工牌。

那张工牌我戴了八年,从感知算法工程师做到规控负责人,亲历过L2到L2++的几轮迭代,也熬过几个通宵赶OTA版本。但真正让我下定决心的,不是某一次通宵,是那年Q1的利润表。

那年汽车行业的价格战打到什么程度?比亚迪一句"电比油低",全行业跟着跳水,主流车企单车毛利从过去的两位数干到3%到4%,部分新势力卖一辆亏一辆,行业利润率跌破了警戒线。我所在的主机厂,智驾部门从"明星业务"一夜变成"成本中心",预算砍半、年终奖缩水不说,开年第一周HR就拿着名单来"优化"——我们组三十多号人,走了八个。走的那天,工位上还摆着没喝完的咖啡。

更刺眼的是另一条新闻:同一个月,具身智能赛道单月融资额破了百亿。Figure、1X、Physical Intelligence在海外狂飙,国内宇树、智元、银河通用、星海图轮轮过亿。我刷着朋友圈,一边是前同事在群里哀嚎"又降薪了",一边是机器人圈的大佬在晒"又融了一轮"。

那种撕裂感,没在汽车行业熬过的人很难体会。一边是你深耕八年、看着它从蓝海卷成红海的赛道;一边是聚光灯突然打过来的新世界,而那个新世界的核心玩家,居然都是你认识的老同事。

我交工牌那天,前司的mentor请我喝了顿酒。他说:"你这时候走,对。"顿了顿又说:"但机器人这事儿,比智驾难十倍。"

我没接话。一年过去了,他说对了一半——机器人确实难十倍,但我也没后悔。这一年我每天干14到16个小时,周末也在跑实验、看论文,把汽车行业那套Data Engine(也常被称为Data Flywheel))的方法论往机器人上搬。前阵子组里新来个实习生,跟我聊Sim-to-Real Gap聊了半小时,临了问我:"哥,你在这行干了几年了?"我说:"一年。"他愣了三秒,以为我在吹牛。

这一年,我观察到一个很有意思的现象:身边做具身智能的,十个里有七八个是从汽车行业出来的。李力耘、夏中谱、高继扬这些大佬就不说了,连我前司的几个实习生,现在都在各家机器人公司挑大梁。特斯拉FSD团队更是给Optimus项目源源不断输送人才,那份名单长得惊人。

资本市场和媒体把聚光灯打在"具身智能"上,但很少有人问一个根本问题:为什么是汽车人?为什么不是互联网人?为什么不是搞大模型的那帮人?

这篇文章,我想用这一年踩过的坑、看过的局,聊聊这场"汽车人大迁徙"背后的真相。

01

汽车和机器人,

本质上是同一拨人

我刚转行的时候,第一周就被丢去理解机器人的技术栈。说实话,看完之后我没觉得多陌生。

因为无论是智驾还是机器人,本质上都在干同一件事:在真实、开放、动态的物理世界里,完成从感知到执行的闭环控制。

把这个过程拆开,就是一条流水线:感知 → 理解 → 预测 → 规划 → 控制 → 执行 → 反馈。

智驾这边,感知是摄像头、激光雷达、毫米波雷达、IMU;理解是BEV、占用网络;预测是轨迹推演;规划是路径和速度曲线;控制是方向盘、油门、刹车;执行是车辆底盘;反馈是IMU和轮速计。

机器人那边,感知换成RGB-D、力矩传感器;理解换成VLM(视觉语言模型);预测变成"我抓这个杯子它会不会掉";规划变成动作序列(Motion Planning);控制变成全身关节电机(Whole Body Control);执行变成机械臂和灵巧手;反馈是视觉和力反馈。

你看,灵魂是一样的,只是肉身不同。

我前司有个做规控的大佬,比我早半年转行,现在在某机器人公司做Motion Planning,两周就上手了。当时我还觉得不可思议,后来才明白:他做了十年"在约束条件下找最优解"的活儿,无论是找一条不撞车的轨迹,还是找一条不碰桌子的抓取路径,本质都是一回事。

所以第一个结论很朴素:从AI的视角看,智能汽车和具身机器人只是执行器不同,背后的智能灵魂遵循同一套逻辑。

这也是为什么机器人公司最爱招智驾工程师——不是因为他们懂机器人,是因为他们懂"在物理世界里做闭环控制"这件事。

02

真正值钱的不是算法,

是那套被低估的"AI工业化"

转行第一年,我最大的震撼不是技术,是认知的颠覆。

我以前在车企,总觉得我们做的事儿没什么了不起——不就是感知、规控、控制那一套嘛,论文都是公开的,开源代码一抓一大把。直到有一天,我和一个从互联网大厂转过来的同事聊天,他问我:"你们当年怎么训练感知模型的?"

我说:"车队跑数据,云端自动标注,Dojo训练,仿真验证,OTA推送。"

他沉默了一会儿,说:"我们做推荐系统的,从来没有这种条件。"

那一刻我突然意识到,我们这些汽车人习以为常的东西,其实是用数百亿美元和无数血汗教训堆出来的、外界最被低估的核心壁垒。

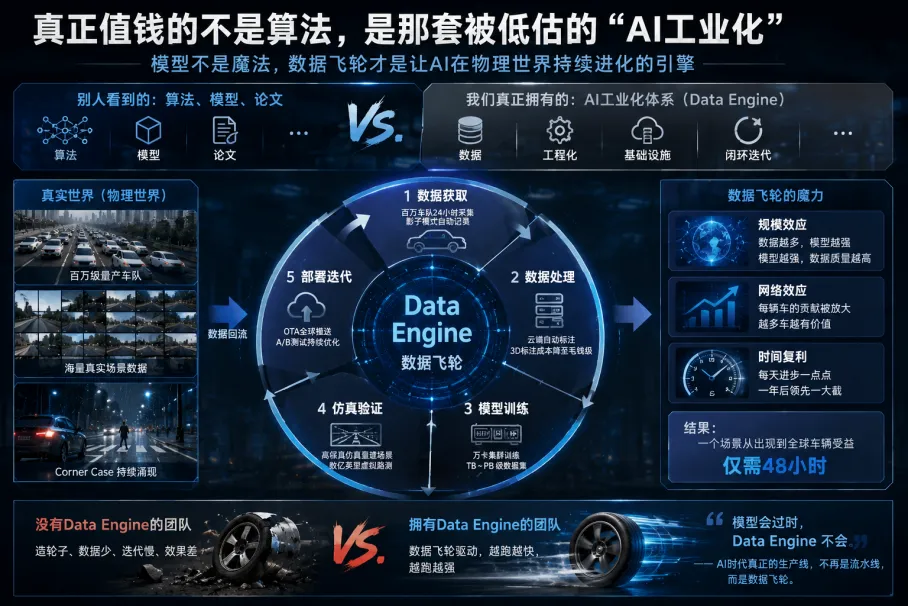
这套东西有个名字,叫Data Engine(数据引擎)。让我把它拆开给你看:

数据获取:百万辆车组成的24小时采集网络,加上影子模式——系统在后台静默运行,AI决策和人类决策不一致时就自动记录。大雨、暴雪、逆光、突然冲出的行人,这些实验室永远凑不齐的Corner Case,每天都在真实路面上演。

数据处理:云端自动标注,多帧视频加多传感器融合,3D物体标注成本从几块钱降到几毛钱。

模型训练:数万张GPU组成的超级计算机,TB甚至PB级数据集训练。

仿真验证:Waymo的Simulation City能基于真实数据重建数百万个高价值场景,在虚拟世界里跑数亿英里模拟路测。你可以让突然冲出的行人速度快0.1秒,让对向来车再近1米——这种压力测试现实里根本做不了。

部署迭代:OTA一夜之间把新模型推到全球数十万辆车上,A/B测试用真实数据验证迭代效果。

这五个环节环环相扣。一个亚利桑那州凤凰城出现的罕见场景,48小时内就能被采集、标注、训练、仿真、推送到全球所有车上。

这就是为什么OpenAI做不了FSD,为什么无数实验室里惊艳的机器人Demo走出实验室就举步维艰。差的不是模型,不是算法,是这套工业化能力。

我刚转行那会儿,团队里有个从某顶级AI实验室来的博士,模型写得贼溜,但每次Demo一上真机就翻车。他不理解为什么,我说:"你缺的不是模型,是Data Engine。"他当时不信,半年后信了。

所以第二个结论:能被复制到机器人行业的,不是某个算法,是这整套驱动AI在物理世界持续进化的Data Engine。

03

为什么Physical AI

诞生在汽车行业,

而不是互联网行业?

这个问题我想了很久。

论AI人才密度,互联网公司甩汽车行业几条街。论数据量,字节跳动一天的视频数据比所有车企一年采集的还多。论算力,谷歌Meta的GPU集群比Dojo还猛。

但Physical AI(物理世界AI)的摇篮,偏偏是看似"传统"的汽车产业。

答案在一个根本分野上:互联网AI和Physical AI,交互的世界截然不同。

互联网AI是"信息处理器",在虚拟数字世界里对文字、图片、视频做模式识别、分类、生成、推荐。它每一次犯错的成本极低——推荐错了你划走,聊天机器人答非所问你重问一句。

Physical AI是"物理世界改造者",在现实世界里和充满不确定性的"原子"打交道。它输出的不是像素和字符,是实实在在的力和运动。它的核心挑战不是语义优美,是安全。

一个在高速上跑的智驾系统,决策窗口可能只有几十毫秒,一个微小错误就可能车毁人亡。一个在工厂里和人协同的机械臂,控制必须满足功能安全(ISO 26262)的严苛标准。

这种对安全、可靠、实时的极致要求,逼着汽车行业建了一套完全不同于互联网的软件架构:实时操作系统(RTOS)对比通用Linux;功能安全标准(ISO 26262)对比互联网的快速迭代、灰度发布;确定性通信(TSN)对比尽力而为的TCP/IP;嵌入式系统的算力功耗约束对比云端近乎无限的计算资源。

这套东西,深刻烙印在每一个汽车工程师的DNA里。

互联网公司能轻易训练出识别全世界猫品种的模型,但很难让一个机械臂在各种光照和姿态下稳定、可靠、安全地拿起一只猫。互联网AI可以容忍99%的准确率,Physical AI不行——它要的是99.999%,剩下的那0.001%,可能就是一条人命、一台报废设备、一次上亿的事故。

LLM的革命改变的是数字世界,Physical AI的革命要直接改造现实世界。而开启后一场革命的钥匙,恰好握在那些常年和物理世界打交道、对"安全"二字怀有敬畏之心的汽车人手里。这也是为什么我转行第一周,CTO跟我说:"你最大的优势不是会写算法,是你知道一个系统在物理世界里跑飞了有多可怕。"

04

为什么是今天?——

一场被价格战逼出来的迁徙

聊到这儿,可能有人会问:汽车和机器人的同构性,十年前就存在了,为什么偏偏是这两年集中爆发?

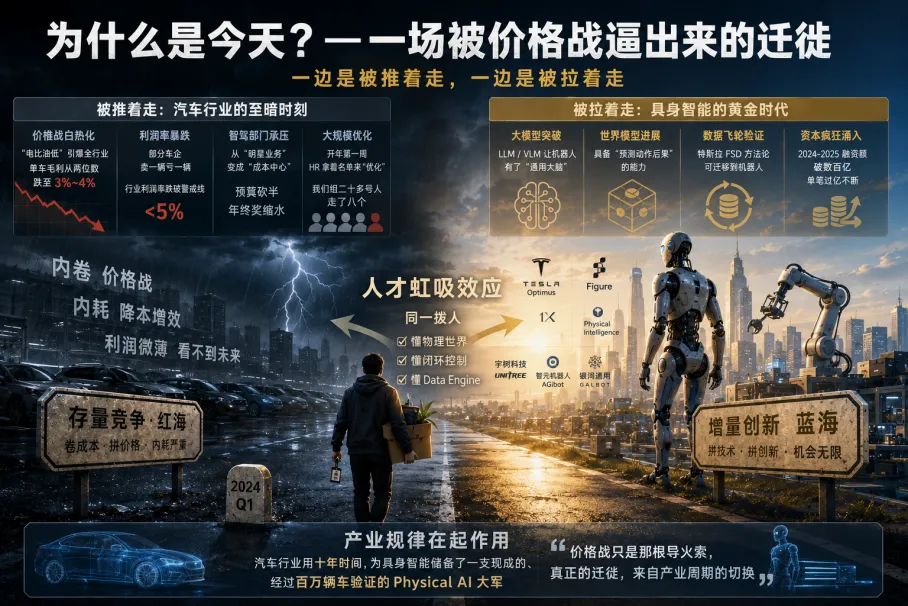
我的回答是:一边是被推着走,一边是被拉着走。

先说被推着走的那一边。2024到2025年,汽车行业的价格战打到了血流成河的程度。比亚迪"电比油低"一记重锤,全行业跟着跳水,单车毛利从过去的两位数干到3%到4%,部分车企卖一辆亏一辆。智驾部门从"护城河"变成"成本黑洞",年终奖缩水、团队优化、预算砍半,成了家常便饭。

我认识的好几个前同事,都是在那一波"优化"里被动离开的。他们不是不想留,是行业本身已经容不下那么多人了。一个做了十年感知的兄弟,被裁那天跟我说:"我在车企卷了十年,卷出一身病,卷出一个3%的毛利。"

再说被拉着走的那一边。同一时期,具身智能迎来了三件大事的共振:

第一,大模型(LLM/VLM)的突破,让机器人第一次有了"通用大脑"的可能。以前机器人只能干预编程的活儿,现在能听懂"把桌上那个红色的杯子递给我"了。GPT-4V、Gemini这些多模态模型,把自然语言指令到机器人动作的鸿沟填了一大半。

第二,世界模型(World Model)的进展,让机器人开始具备"预测动作后果"的能力。这是从感知走向决策的关键一跃。英伟达的GR00T、谷歌的RT-X,都在这条路上跑。

第三,数据飞轮(Data Flywheel)的方法论被验证。特斯拉把FSD那套搬到Optimus上,证明了汽车行业的Data Engine可以迁移——百万辆车跑出来的方法论,现在要靠机器人重新跑一遍。AI时代真正的生产线,不再是流水线,而是数据飞轮。

这三件事凑到一起,加上资本的疯狂涌入——2024到2025年具身智能赛道融资额破了数百亿,单笔过亿的案子一个接一个——形成了一个巨大的虹吸效应。

一边是汽车行业在往外吐人,一边是具身智能在往里吸人。而这两拨人,恰好是同一拨人——懂物理世界、懂闭环控制、懂Data Engine的汽车人。

所以这场迁徙,不是某个大佬的英明决策,是产业规律在起作用。汽车行业用十年时间,为具身智能储备了一支现成的、经过百万辆车验证的Physical AI大军。价格战只是那根导火索。

05

转行1年,我踩过的三座大山

写到这儿,可能有人觉得汽车人转行具身智能是降维打击。我后来发现,机器人真正难的,不是AI,而是物理。别急,听我讲完下面这三座山。

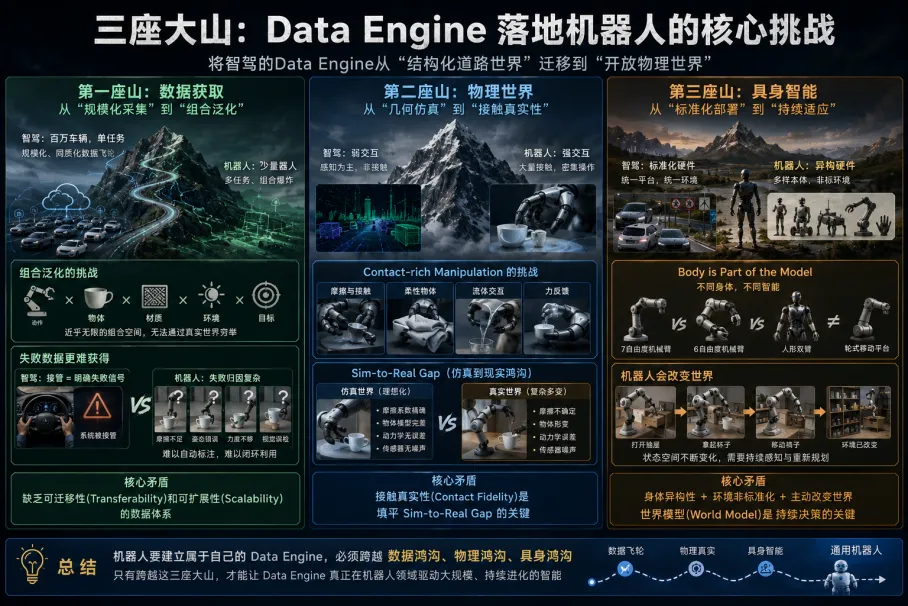
智驾的Data Engine是从相对结构化的道路世界长出来的。把它搬到充满开放任务和复杂物理交互的机器人领域,不能简单复制,必须跨越三座新的大山。这也是我这一年摔得最狠的地方。

第一座山:数据获取——从"规模化采集"到"组合泛化"

我刚转行的时候,天真地以为机器人最大的问题是数量少。错。

真正的问题不是数量少,是数据难以规模化复用。

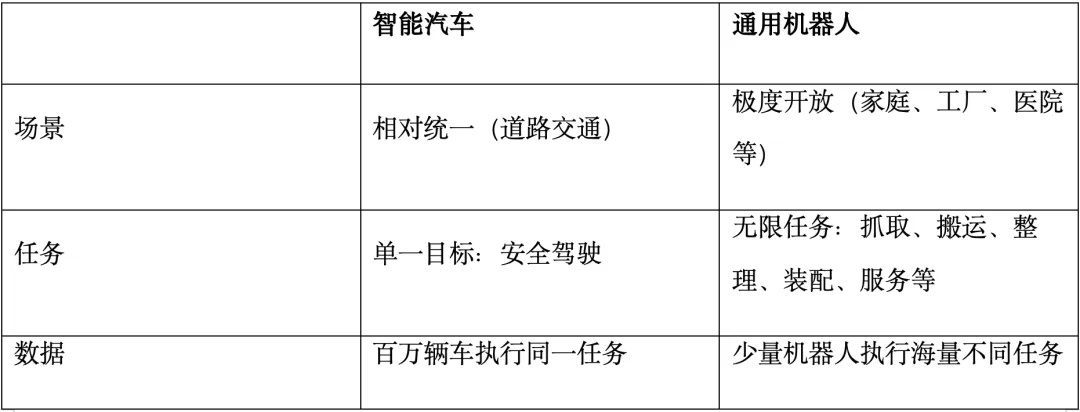
智驾的数据闭环建立在"多智能体、单任务"模式上:数百万辆车,几乎一致的底盘、传感器、控制系统,每天干同一件事——把人从A点送到B点。所以不同车的数据可以不断汇聚,形成持续增长的数据飞轮。

机器人面对的是完全不同的问题。

机器人不仅硬件形态各异(人形、轮式、双臂、单臂、灵巧手),任务也高度开放。同样是"拿起一个杯子",杯子的材质、重量、是否装液体、桌面摩擦系数、光照条件、周围障碍物——任意组合,都是一个新任务。

真正困难的不是长尾,是组合泛化(Compositional Generalization)。在一次抓杯子实验里。我们连续换了二十多个杯子,模型都没问题,但只要换成一个透明、带水珠的玻璃杯,成功率立刻掉下去。后来我们才意识到,机器人面对的不是一百万种物体,是动作、物体、环境、任务目标之间近乎无限的组合空间。靠真实世界采集数据,几乎不可能穷尽。

更头疼的是,机器人的失败远比自动驾驶难定义。车辆被接管是明确的失败信号;机器人抓取失败,是摩擦力不足?姿态规划错误?力度控制不当?还是视觉误检?这些失败难以自动标注,更难直接反馈到数据闭环。

我团队里有个兄弟,之前在车企做数据闭环,来了之后花了三个月想搭一套机器人的"接管数据"系统,最后放弃了。他跟我说:"车被接管是离散事件,机器人失败是连续过程,根本不是一回事。"后来我们换了个思路,用遥操作(Teleoperation)+ 力反馈记录来标注失败帧,才算勉强跑通——但成本是车企那套的十倍。

所以机器人真正缺的,不是更多数据,是具有可迁移性(Transferability)和可扩展性(Scalability)的数据体系。这也是为什么今年(2026)大家都在卷VLA模型(Vision-Language-Action)、在卷合成数据、在卷跨本体迁移——本质上都是在解这道组合泛化的题。

第二座山:物理世界——Data Engine遇到真正的Boss

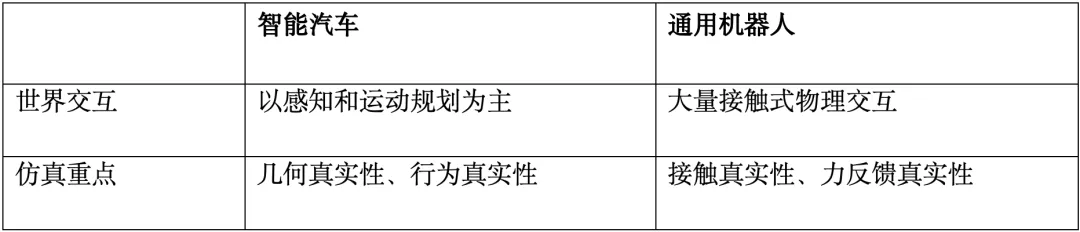
自动驾驶的大多数决策,发生在"不接触世界"的前提下。

识别道路、预测他人行为、规划安全轨迹——仿真的重点是场景够真、交通参与者行为够合理。

机器人完全不同。机器人真正创造价值的地方,几乎都发生在接触(Contact)的瞬间。

拿起杯子、拧瓶盖、插USB、折叠衣服、系鞋带、开门——这些任务都属于典型的Contact-rich Manipulation(接触密集型操作)。

一旦发生接触,问题就极其复杂。摩擦力、弹性形变、接触点变化、力反馈、柔性材料、流体运动——任何一个细微误差,都可能导致现实中的操作失败。

这就是机器人领域长期存在的Sim-to-Real Gap(仿真到现实鸿沟)。

自动驾驶里,一个摄像头仿真误差可能不影响最终决策;但机器人里,哪怕摩擦系数存在千分之一的偏差,都可能导致抓取失败。

我们团队有一次在仿真里把一个倒水任务跑通了,成功率99%。搬到真机上,成功率掉到30%。排查了一周,发现是仿真里的水流模型和真实水流的表面张力差了那么一点点。还有一次更离谱,仿真里抓取一个塑料瓶成功率100%,真机上死活抓不起来——最后发现是仿真里把瓶身的摩擦系数设高了0.02,真瓶身有水汽,更滑。

那一刻我才真正理解,对于机器人,真正需要解决的不只是物理仿真,是接触真实性(Contact Fidelity)。

这也是为什么英伟达在死磕Omniverse物理仿真平台,谷歌在搞RT-X多机器人模型,无数创业公司在探索合成数据——大家都在用不同方式填这道坑。

第三座山:具身智能——身体也是模型的一部分

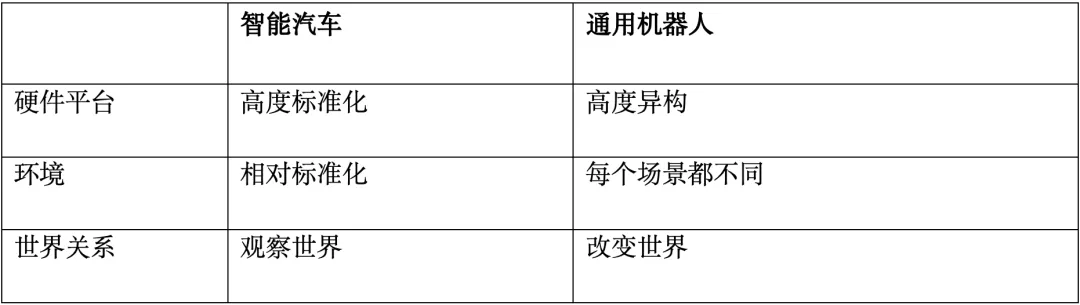
自动驾驶最大的优势是标准化。同一车型硬件几乎一致,道路交通规则高度统一,一次OTA升级可以快速覆盖整个车队。

机器人完全相反。

首先,不同机器人拥有完全不同的身体。机械臂长度、自由度数量、电机响应速度、灵巧手结构、触觉传感器布局都存在巨大差异。同一个策略,在一台机器人上成功,换一台可能完全失效。

所以机器人领域越来越强调一个观点:Body is Part of the Model(身体也是模型的一部分)。

智能不仅来自模型,也来自机器人本体的设计。这事儿在自动驾驶里几乎不存在——你不会说一辆Model 3的"身体"和一辆Model Y的"身体"需要不同的算法。

其次,机器人面对的是高度非标准化的环境。每个家庭、每间厨房、每个工厂车间都有不同的布局、光照、材质和物品摆放。

更要命的是,机器人不仅观察世界,还会不断改变世界。

打开抽屉,环境变了;拿起杯子,世界状态变了;移动椅子,整个规划空间重新变了。机器人需要持续感知、持续更新世界状态,不断重新规划后续动作。

而自动驾驶更多是在相对稳定、可预测的环境里完成路径规划。

这也是为什么机器人不仅需要感知模型,还需要更强大的世界模型(World Model)来预测自身动作将如何影响环境,并据此完成连续决策。
06

给后来者的话: 能力栈的跃迁

经常有汽车行业的兄弟问我:"我现在转行还来得及吗?"

我的回答是:来得及,但你需要一次主动的能力升级。

这场变革不是对旧技能的"替代",是"叠加"和"升维"。

我画过一张Physical AI工程师的能力栈演进图,从下到上是这样六层:Embedded(基础)→ SOA(架构)→ Cloud(云端)→ AI(算法)→ Agent(智能体)→ Physical AI(物理交互)。

Embedded(嵌入式):以AUTOSAR、嵌入式RTOS/Linux/QNX为代表的底层软件开发能力,依然是Physical AI的绝对基石。因为它保证了系统的高可靠性、实时性和安全性。一个不满足功能安全的机器人,就像一辆没有刹车的汽车——能力越强,潜在的危险就越大。

SOA (面向服务的架构): 将复杂的系统解耦为独立的服务,是管理大型、异构软件系统的关键。无论是智能汽车还是机器人,其软件复杂度都要求工程师具备强大的架构设计能力。

Cloud (云端): 数据引擎的运转、大模型的训练、仿真平台的运行,都离不开云。理解云原生技术、DevOps、大数据平台,是打通"车/机器人-云"通路的前提。

AI (算法): 深度学习、计算机视觉、强化学习等AI算法,是赋予系统"智能"的核心。

Agent (智能体): 这是最新的能力层。工程师需要开始以"智能体"的视角思考问题,如何让系统具备自主规划、使用工具、与环境交互的能力。

一个普通的CAN总线工程师,其价值可能会被逐渐削弱。但是,一个既懂CAN通信和ECU底层,又理解SOA架构,还能结合云端数据进行AI模型部署和优化的"全栈工程师",其价值将在Physical AI时代被无限放大。

真正的竞争力,在于能否将自己扎实的嵌入式"硬核"能力,与云端AI、大模型、智能体等上层的"软"能力融会贯通,成为一个稀缺的"全栈物理世界AI工程师"。

我见过太多转行的兄弟,要么彻底抛弃过去、all in大模型,结果发现自己在新赛道里和科班出身的年轻人拼不过;要么死守着嵌入式老本行,对新东西抗拒,最后被边缘化。真正走得远的,都是那些"既懂底层、又懂上层"的T型人才。

我自己这一年的体感是:汽车行业那八年给我最大的礼物,不是某个具体技能,是一种"系统级"的思维方式。看到一个问题,我会本能地想:它的数据从哪来?闭环怎么走?失败模式有哪些?怎么在边缘case上做压力测试?这种思维方式,是互联网公司里做推荐、做NLP的兄弟很难天然具备的。

这也是为什么我转行才一年,但讲起Sim-to-Real、Contact-rich、World Model这些概念,新来的同事以为我干了五年——不是因为我聪明,是因为汽车行业那八年给我打的地基太深了。底子厚的人,转行不是从零开始,是带着弹药空降。

07

写在最后

一年前我交工牌那天,mentor跟我说:"机器人这事儿比智驾难十倍。"

他说对了。但我也没后悔。

因为这一年我越来越确信一件事:自动驾驶教会机器人行业的,不是一套可以照搬的技术栈,是一种AI工业化的思维方式。智能驾驶行业真正输出给具身智能的,并不是某一个自动驾驶模型,而是一套经过百万辆汽车验证的AI工业化方法论。

从数据采集、自动标注、闭环训练,到仿真验证、持续评测和OTA迭代,Data Engine已经证明,大规模AI系统必须依靠持续演进的数据飞轮,而不是一次性训练完成。

但机器人要真正建立属于自己的Data Engine,还必须跨越三道全新的鸿沟:数据鸿沟,从规模化采集走向组合泛化,实现数据的可迁移与可复用;物理鸿沟,从几何仿真走向接触真实性,缩小Sim-to-Real Gap;具身鸿沟,让模型真正理解不同身体、不同环境以及人与物理世界的持续交互。

这条路还很长。但好在,走在这条路上的,是一群懂物理世界、对安全怀有敬畏之心的人。

一年后的今天,那张工牌还躺在抽屉里。我偶尔会把它拿出来看看。它提醒我,我并没有离开汽车行业。只是汽车行业,用另一种方式,把我送到了下一站。

作者微信:

/ END /

最新文章

随机文章