当前位置:首页>自动驾驶>模块化与端到端自动驾驶:数据标注要求有何不同?

模块化与端到端自动驾驶:数据标注要求有何不同?

  • 2026-10-14 10:15:32
模块化与端到端自动驾驶:数据标注要求有何不同?

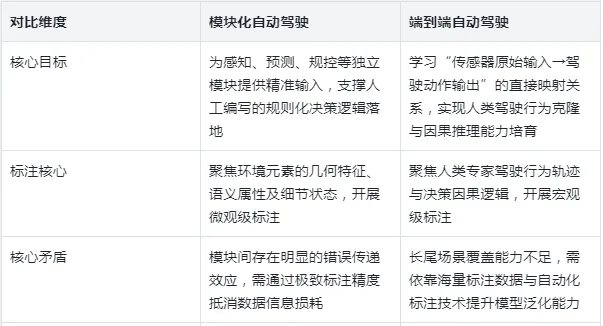
自动驾驶技术从“模块化分治架构”向“端到端统一建模”的跨越,本质上是决策范式从“环境精准重构+规则化驱动”向“人类行为克隆+因果逻辑学习”的根本性转变,这种架构层面的迭代,直接重构了数据标注的核心目标、标注粒度、内容体系、实施流程及成本结构。其中,模块化路径下的数据标注侧重“微观极致精准、分模块适配”,端到端路径则以“宏观行为导向、因果关联清晰、海量高效生产”为核心诉求,二者的差异贯穿数据标注的全流程、全维度。

一、核心定位与标注目标差异

当我们对着智能音箱下达指令、用语音输入法快速成文,或是依靠会议工具自动整理谈话纪要时,AI似乎早已“读懂”了人类的每一句话。但鲜有人知,支撑这份流畅交互的核心,并非大模型本身的“天赋”,而是ASR(Automatic Speech Recognition,自动语音识别)标注技术的默默赋能。作为连接声波信号与语义理解的关键桥梁,ASR标注就像为AI打造的“语义解码器”,让机器在海量标注数据的训练中,逐步掌握人类语言的复杂逻辑,实现从“听见”到“听懂”的质变。

模块化:以“环境精准理解”为核心的微观标注导向

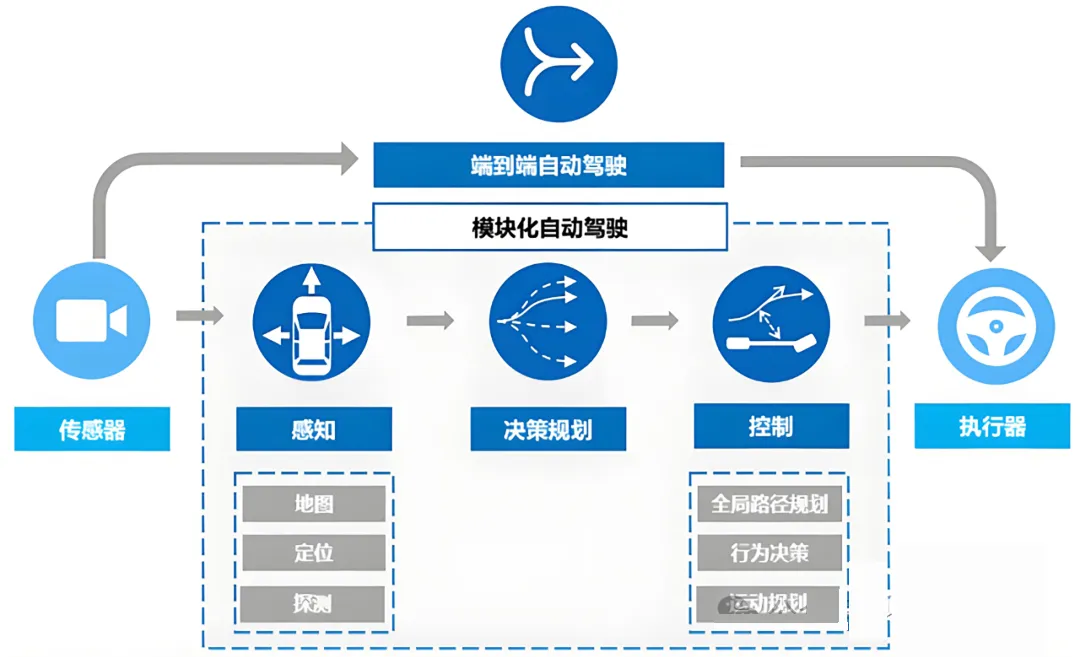
模块化架构的核心逻辑是将复杂的驾驶任务拆解为感知、预测、规控三个独立且串行的核心模块,其中感知模块承担“环境感知”的核心职责,相当于自动驾驶车辆的“视觉与触觉系统”,其输出数据的精准度直接决定后续预测、规控模块的决策合理性。因此,模块化路径下的数据标注必须遵循“极端精细化”原则,为每个独立模块提供确定性的输入数据,以此规避错误在模块间逐级传递、放大。

其标注核心逻辑可概括为“分而治之、专数专用”:针对每个细分算法场景(如红绿灯灯色识别、车道线虚实检测、障碍物分类与跟踪),都需要搭建独立的标注数据集,标注结果以离散化的标签、坐标等形式,精准传递给下游的预测、规控模块。

该路径的关键痛点的是数据信息的高度损耗:传感器采集的海量原始数据(图像、点云),经过标注后仅被压缩为少量核心标签与坐标信息,那些未被标注的细微环境变化(如路面轻微湿滑、行人的潜在横穿意图、非机动车的违规倾向)无法传递给下游规控模块,直接导致模块化架构在长尾场景中的适配能力存在明显局限。

端到端:以“驾驶行为复刻”为核心的宏观标注导向

端到端架构(尤其是单模型统一建模范式)打破了模块化架构的独立模块划分,通过一个统一的神经网络,直接完成“传感器原始信号输入→方向盘转角、加速踏板深度、刹车压力等驾驶动作输出”的全链路映射,不再依赖显式的中间模块与人工编写的硬编码规则。这种架构变革,使得数据标注的重心从“屏幕上的框线、分割区域”,彻底转向“人类司机的手脚动作与决策逻辑”,核心目标是让模型精准复刻人类的驾驶行为与决策思维。

其标注核心逻辑可概括为“行为克隆+因果学习”:标注工作不仅需要精准记录人类司机的驾驶动作轨迹,更要建立动作与环境诱因之间的关联,明确“司机为何做出该动作”(如刹车是因为红灯亮起,而非前车减速),让模型不仅能“模仿人类动作”,更能“理解决策背后的逻辑”,实现从“机械模仿”到“智能决策”的跨越。

该路径的关键突破在于实现了数据信息的无损传递:模型可直接利用传感器原始数据的高维特征,无需经过模块化架构中的信息压缩环节,有效规避了信息瓶颈问题,模型的泛化能力大幅提升,但与此同时,其对标注数据的规模、质量与多样性要求也呈指数级增长。

二、标注内容与粒度差异

1. 模块化:极致精细的“元素级”标注体系

(1)2D图像标注(适配摄像头传感器)

核心围绕摄像头采集的二维图像,开展像素级、精细化标注,为感知模块提供精准的环境语义与几何信息:

目标检测标注:通过矩形框(Bounding Box)精准标定图像中的车辆、行人、骑行者、交通标志、红绿灯等核心目标,要求实现像素级的边界精准(如红绿灯的灯色区域、车道线的虚实边缘),杜绝边界偏差导致的感知错误;

语义分割标注:采用像素级分割方式,精准区分并标注路沿、车道线、路面区域、各类障碍物、植被等环境元素,为规控模块提供精确的空间坐标参考,支撑路径规划与避障决策;

属性补充标注:针对标注目标的具体状态与特征进行补充标注,如车辆的刹车灯/转向灯开启状态、行人的年龄区间与性别、红绿灯的倒计时时长等,为人工编写的“If-Then”规则决策提供离散化的属性参数支撑。

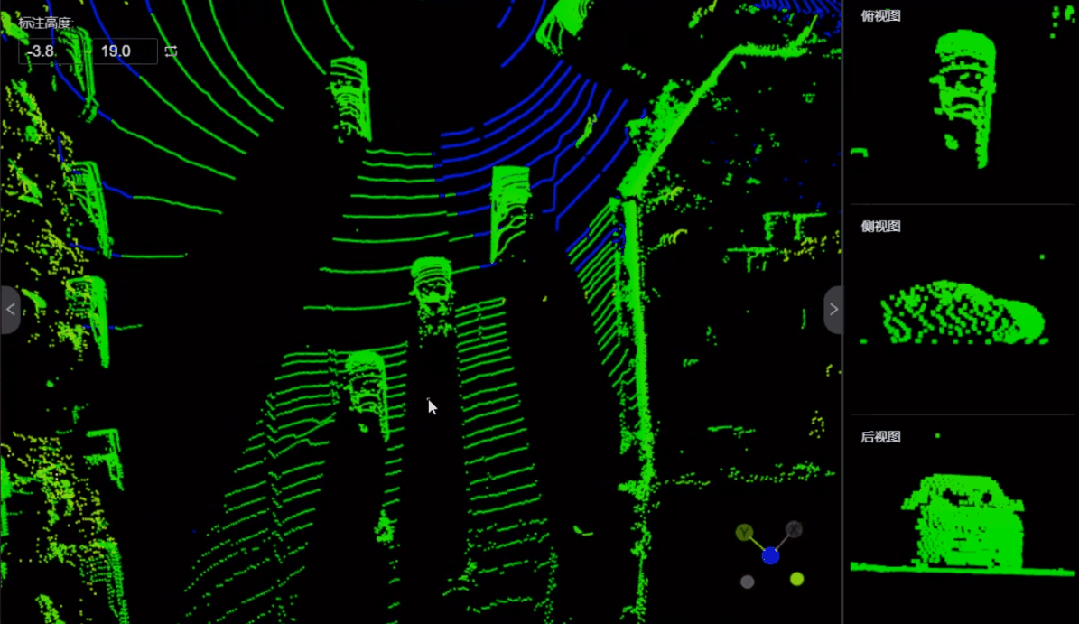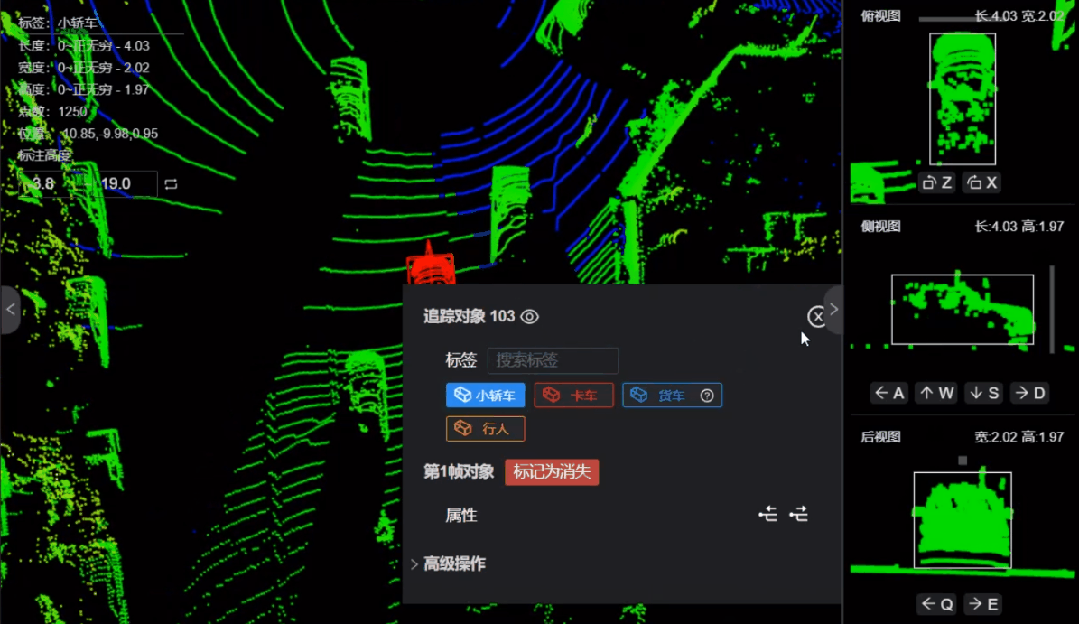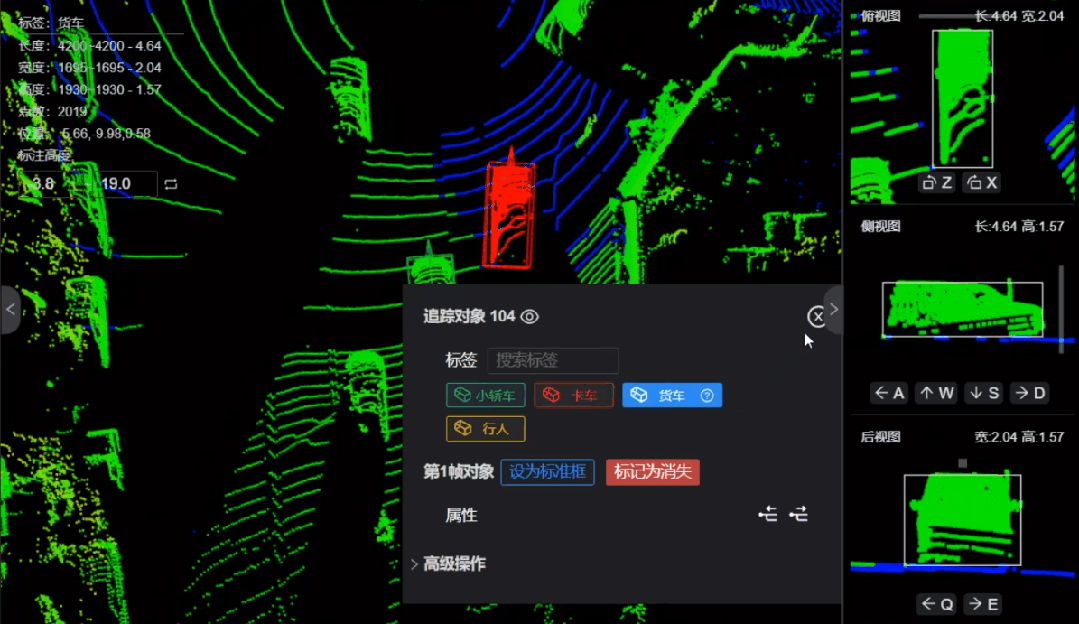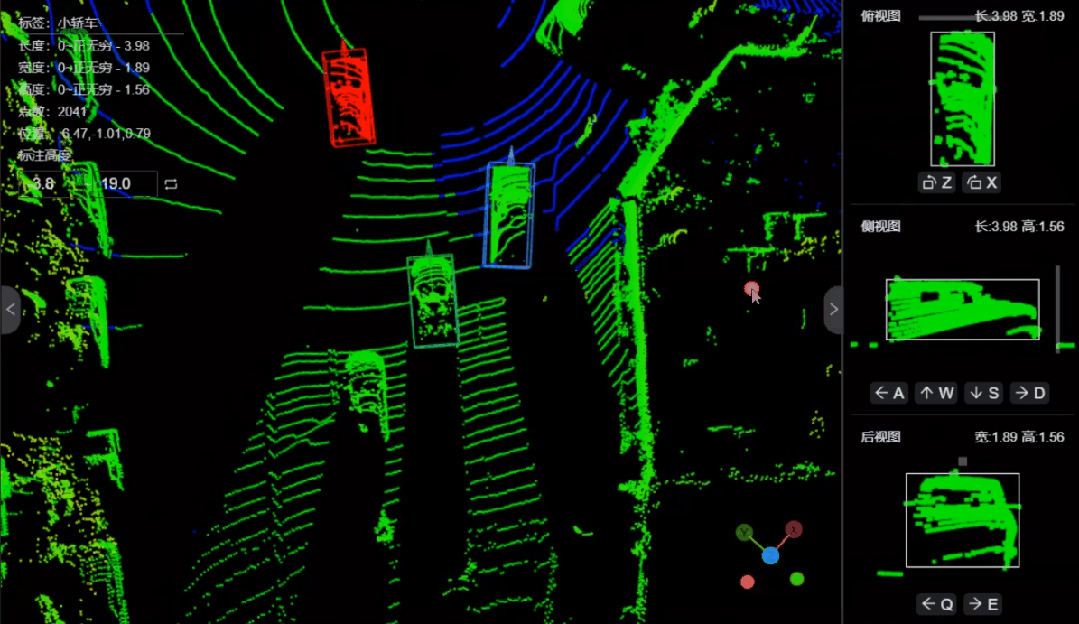
(2)3D点云标注(适配激光雷达传感器)

针对激光雷达采集的稀疏、无语义的三维点云数据,开展高精度的三维标注,弥补2D图像标注在空间距离、深度信息上的不足:

3D框标注:在三维点云空间中,精准圈定各类目标物体,标注其长、宽、高尺寸、航向角及空间位置坐标,要求达到厘米级的标注精度——因为感知模块输出的距离偏差若达到几厘米,传递至规控模块就可能触发不必要的紧急制动,影响驾驶安全性;

点云分割标注:对三维点云进行语义分割,明确区分地面、各类动态障碍物、静态设施、植被等元素,解决激光雷达点云数据稀疏、无语义的核心问题,为融合感知提供基础;

多传感器融合标注:统一摄像头与激光雷达的坐标系,实现2D图像标注与3D点云标注的精准对齐,确保多传感器融合感知时,各类目标的信息能够相互匹配、互补,提升感知模块的鲁棒性。

(3)细分任务专属标注

模块化架构的“分而治之”逻辑,决定了其标注任务的碎片化特征:红绿灯识别、限速牌数值检测、路面坑洼与破损检测、施工区域识别等每个细分算法场景,都需要搭建独立的标注数据集,开展针对性标注,这种碎片化标注模式不仅增加了标注工作量,更推高了整体标注成本。

2. 端到端:行为导向的“动作+因果”标注体系

(1)核心行为标注(基于CAN总线数据)

端到端模型的监督信号直接来源于人类司机的驾驶行为,因此驾驶行为相关的标注是核心,这类数据主要通过车辆CAN总线采集,标注重点是行为的精准性与示范性:

控制信号标注:精准记录人类司机的驾驶控制操作,包括方向盘转角、加速踏板踩踏深度、刹车压力大小、档位切换状态等,这些数据将直接作为模型训练的核心监督信号;

轨迹信息标注:记录车辆在三维空间中的实时位置坐标、行驶速度、加速度变化,构建完整的行驶轨迹数据集,让模型学习不同场景下的合理行驶路径;

数据质量要求:标注数据必须是“金牌司机”的高质量示范数据——即驾驶行为规范、决策合理、无急刹、无违规操作,普通驾驶数据或不规范驾驶行为会误导模型学习,降低模型的决策安全性。

(2)因果逻辑标注(适配VLA/思维链建模)

为解决端到端模型“黑盒决策”的痛点,提升模型的可解释性与泛化能力,端到端路径新增了因果逻辑标注的需求,核心是建立“驾驶动作→环境诱因”的逻辑关联:

决策诱因标注:明确标注驾驶动作与环境因素之间的因果关系,例如“车辆减速→因为行人横穿马路”“路口左转→因为绿灯亮起且无对向车辆”“紧急制动→因为前车突发停车”,让模型理解决策背后的逻辑,而非单纯模仿动作;

语义关联标注:采用自然语言描述场景意图与决策逻辑,如“路口右转时主动避让非机动车”“雨天路面湿滑,降低车速保持安全车距”,支撑视觉-语言-动作(VLA)模型的训练,提升模型的可解释性;

场景标签标注:对标注数据对应的场景类型、风险等级进行分类标注,如场景类型(高速行驶、城市道路、乡村道路、雨天、夜间)、风险等级(常规场景、边缘场景、危险场景),用于后续数据筛选与模型针对性迭代。

(3)4D/世界模型相关标注(以自动标注为主)

端到端模型对标注数据的海量需求,催生了4D自动标注、世界模型等新型标注方式,这类标注不再依赖人工,而是通过技术手段实现自动化生成,标注形态也从“静态帧标注”转向“动态时空标注”:

4D时空标注:融合同一车辆或多辆车在不同时间经过同一路段的传感器数据,构建包含时间维度的高精度三维世界模型(即4D模型)。在该模型中,静态道路设施(如路灯、马路牙子)可通过多次观测实现精准标定;对于动态物体,可利用时序信息进行前后向推算,解决目标遮挡问题(如行人被建筑物遮挡2秒后,系统可通过轨迹一致性自动补齐其标签);

占用网络(Occupancy)标注:将三维空间划分为海量细小的体素(Voxel),标注每个体素在未来一段时间内是否会被物体占用,为模型提供物理空间的动态预测能力。这类海量三维空间标注人工无法完成,必须依靠强大的离线大模型,通过多传感器融合技术自动生成;

世界模型自监督标注:世界模型通过自监督学习方式,学习预测未来几秒钟的环境演变趋势,此时“未来的真实传感器数据”就成为当下数据的标注标签。自动驾驶系统通过“预测未来→与真实未来比对→修正自身表征”的闭环,实现自监督学习,无需人工干预即可从数百万小时的自然驾驶录像中汲取训练养分,这类标注还包含对物理运动规律的隐含标注(如球类滚动后大概率有儿童跟随、雨天路面摩擦力下降需减速)。
三、标注流程与效率差异

模块化:人工主导的“精标+碎片化”实施流程

模块化路径下的标注流程以人工操作为核心,流程繁琐、效率低下,且人工成本占比极高,具体流程如下:

1、数据预处理:对摄像头、激光雷达采集的原始传感器数据进行清洗,去除冗余信息、修正数据偏差,统一数据格式(如相机分辨率、雷达点云密度、坐标体系),为后续标注工作奠定基础;

2、人工精细标注:标注员逐帧对图像、点云数据进行精细标注,包括框选目标、像素级分割、补充属性等操作,单帧图像标注耗时可达数分钟,复杂点云分割甚至需数小时,工作量极大;

3、模块适配拆分:将标注完成的数据集,按感知、预测、规控等不同模块的需求,拆分为专属数据集,分别用于各模块的模型训练与调试,流程割裂且繁琐;

4、质量管控校验:采用“双人标注+交叉复核”的模式,重点校验标注边界精度、属性准确性、坐标一致性,确保标注数据符合模块训练要求,人工成本占比超过80%。

端到端:自动主导的“策展+闭环”实施流程

端到端路径依托自动化标注技术,重构了标注流程,实现了效率的质变,流程以“数据策展+闭环迭代”为核心,具体如下:

1、数据采集筛选:通过影子模式(Shadow Mode)采集海量自然驾驶数据,实时筛选出“模型决策错误、人类决策正确”的关键场景数据——这类数据是最宝贵的训练信号,能够精准解决模型的薄弱环节;

2、自动化标注生成:利用离线大模型,自动完成4D时空标注、占用网络标注、驾驶行为轨迹提取等工作,自动化率可达80%以上,仅复杂边缘场景的标注结果需人工介入校验;

3、人工策展校验:标注员的角色从“画图工”转变为“数据策展人”,核心工作不再是基础标注,而是聚焦因果逻辑标注、场景分类、错误标注修正,确保标注数据的质量与合理性;

4、闭环迭代优化:将标注完成的高质量数据直接输入端到端模型进行训练,模型输出的错误案例回传至标注流水线,重新进行标注与优化,形成“数据采集→标注→训练→反馈→再标注”的闭环迭代。这种模式下,模型的迭代速度不再受限于人类程序员的思维极限,而是由标注流水线的自动化程度与数据多样性决定。

最新文章

随机文章