一、概述
CES 2026标志着汽车行业的重大转折点,汽车不再仅被视为交通工具,而是AI的物理载体。自动驾驶技术从"愿景"走向"实用",AI、VLA模型(视觉-语言-动作)和"舱驾一体"成为本届展会的核心关键词。
本人对AI的VLA模型比较感兴趣,今天就来详细的聊一聊。
二、VLA模型介绍
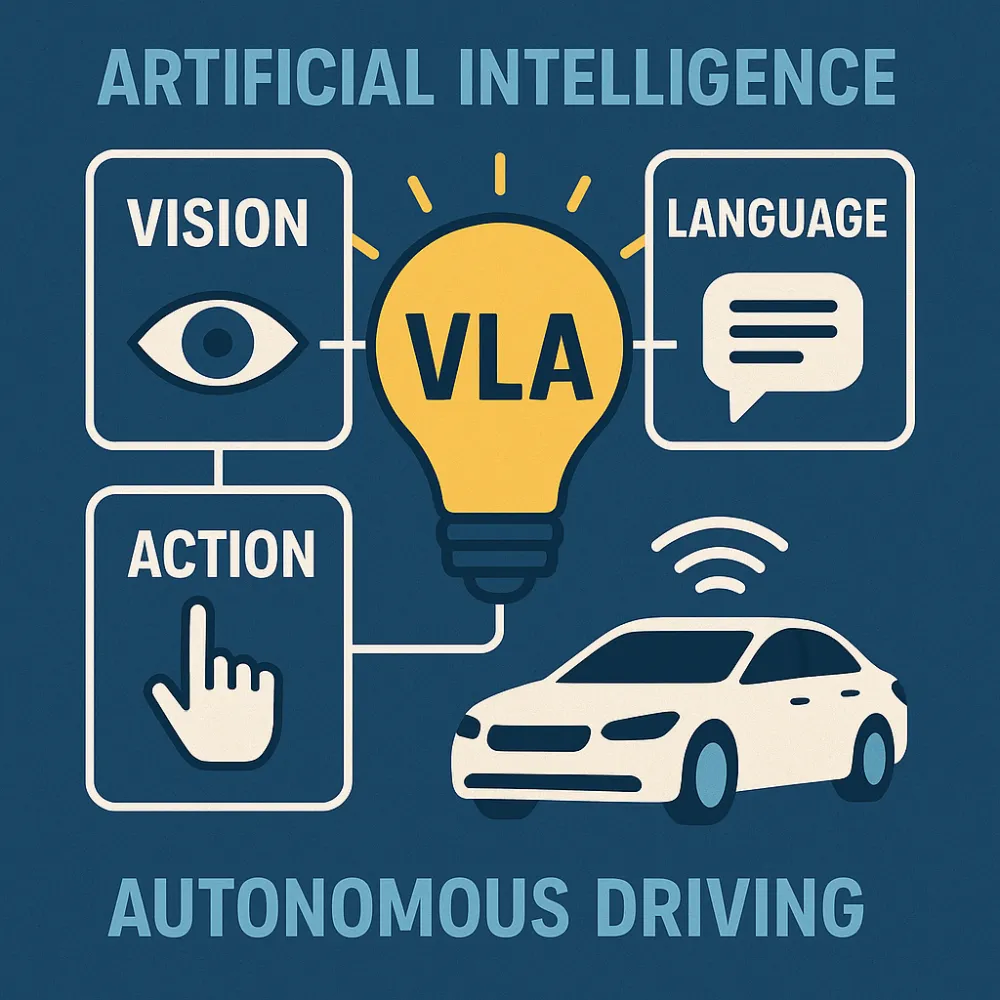
先来说下,VLA模型是什么?
VLA模型(视觉-语言-动作):Vision 视觉、Language 语言、Action 动作
- Vision 视觉:在汽车行业中视觉即感知,指的是摄像头、激光雷达、毫米波雷达等通过视觉传感器获取的信息,如车辆、行人、交通标志
- Language 语言:指的是对感知物的理解、对人类指令的理解 比如:对指令"打开座椅加热器"
- Action 动作
传统架构与VLA架构对比
传统架构
┌─────────────────────────────────────────────────────┐
│                   传统架构                            │
├─────────────────────────────────────────────────────┤
│                                                       │
│  [感知域控]    [决策域控]    [执行域控]    [座舱域控] │
│     ↓             ↓            ↓            ↓        │
│   目标检测    路径规划      运动控制      语音交互    │
│     ↓             ↓            ↓            ↓        │
│   标注数据    规则引擎      PID控制      独立处理     │
│                                                       │
│  问题:                                               │
│  • 数据在域之间传递,信息损耗大                       │
│  • 每个域独立训练,整体不协同                         │
│  • 需要人工定义接口协议                               │
│  • 算力分散,利用率低                                 │
└─────────────────────────────────────────────────────┘
类比:就像一个公司有多个部门(感知部、规划部、执行部),每个部门用不同的语言工作,靠开会(数据传递)协调,效率低且容易出错。
VLA模型:中央大脑架构
┌─────────────────────────────────────────────────────┐
│                VLA 统一大脑                           │
├─────────────────────────────────────────────────────┤
│                                                       │
│            [中央计算平台 - 单一神经网络]              │
│                       ↓                               │
│         ┌─────────────────────────┐                  │
│         │    VLA Transformer      │                  │
│         │   (100亿参数统一模型)   │                  │
│         └─────────────────────────┘                  │
│                ↓         ↓        ↓                  │
│         视觉理解  语言理解  动作输出                  │
│         (感知)   (决策)    (控制)                     │
│                                                       │
│  优势:                                               │
│  • 端到端学习,无信息损耗                             │
│  • 统一优化目标(如"安全到达")                       │
│  • 自动学习最优策略                                   │
│  • 算力集中,GPU利用率高                              │
└─────────────────────────────────────────────────────┘
类比:就像一个人的大脑,眼睛看到(视觉)、理解情况(语言)、控制手脚(动作)是同一个大脑在处理,无缝协同。
三、VLA模型在自动驾驶领域的应用
Alpamayo 开源AI平台
Alpamayo R1:全球首个开源的推理VLA(视觉-语言-动作)模型
搭载车型信息
车型:2025款梅赛德斯-奔驰 CLA(全新一代)
自动驾驶等级:L2++ - 高级辅助驾驶(需要驾驶员监控)
上市时间
核心技术配置
硬件:
- 芯片:NVIDIA DRIVE AGX Orin(254 TOPS 算力)
- 传感器:10个摄像头 + 5个毫米波雷达 + 12个超声波
- 无激光雷达
软件:
功能:
四、个人理解
未来的趋势是舱驾融合向中央大脑演进的趋势。对用户来说,VLA的应用对于提升用户体验感和使用效率至关重要。
典型应用也能在本次展会中安波福的数字创新技术看出:
DMS系统做人脸识别,中央计算平台根据识别内容自动同步用户档案,自动调节车辆生态系统的偏好设置,比如:
文章整理于2026年1月
